시즌 3 — 사용자에서 제작자로 · 2편
AI로 로또 번호를 맞힐 수 있을까? — 트랜스포머·LSTM·통계를 매주 실제 추첨으로 검증해 봤다
"AI 예상번호", "당첨확률 UP" 같은 문구는 많습니다. 그런데 추첨 전에 번호를 공개하고, 추첨 후에 채점하고, 나중에 고치지 않는 곳은 거의 없어요. 그래서 직접 해 봤습니다. 이 글의 숫자는 전부 그 실험의 채점 기록입니다.
확률 · 딥러닝·초기하분포 · 다중비교·12분 읽기
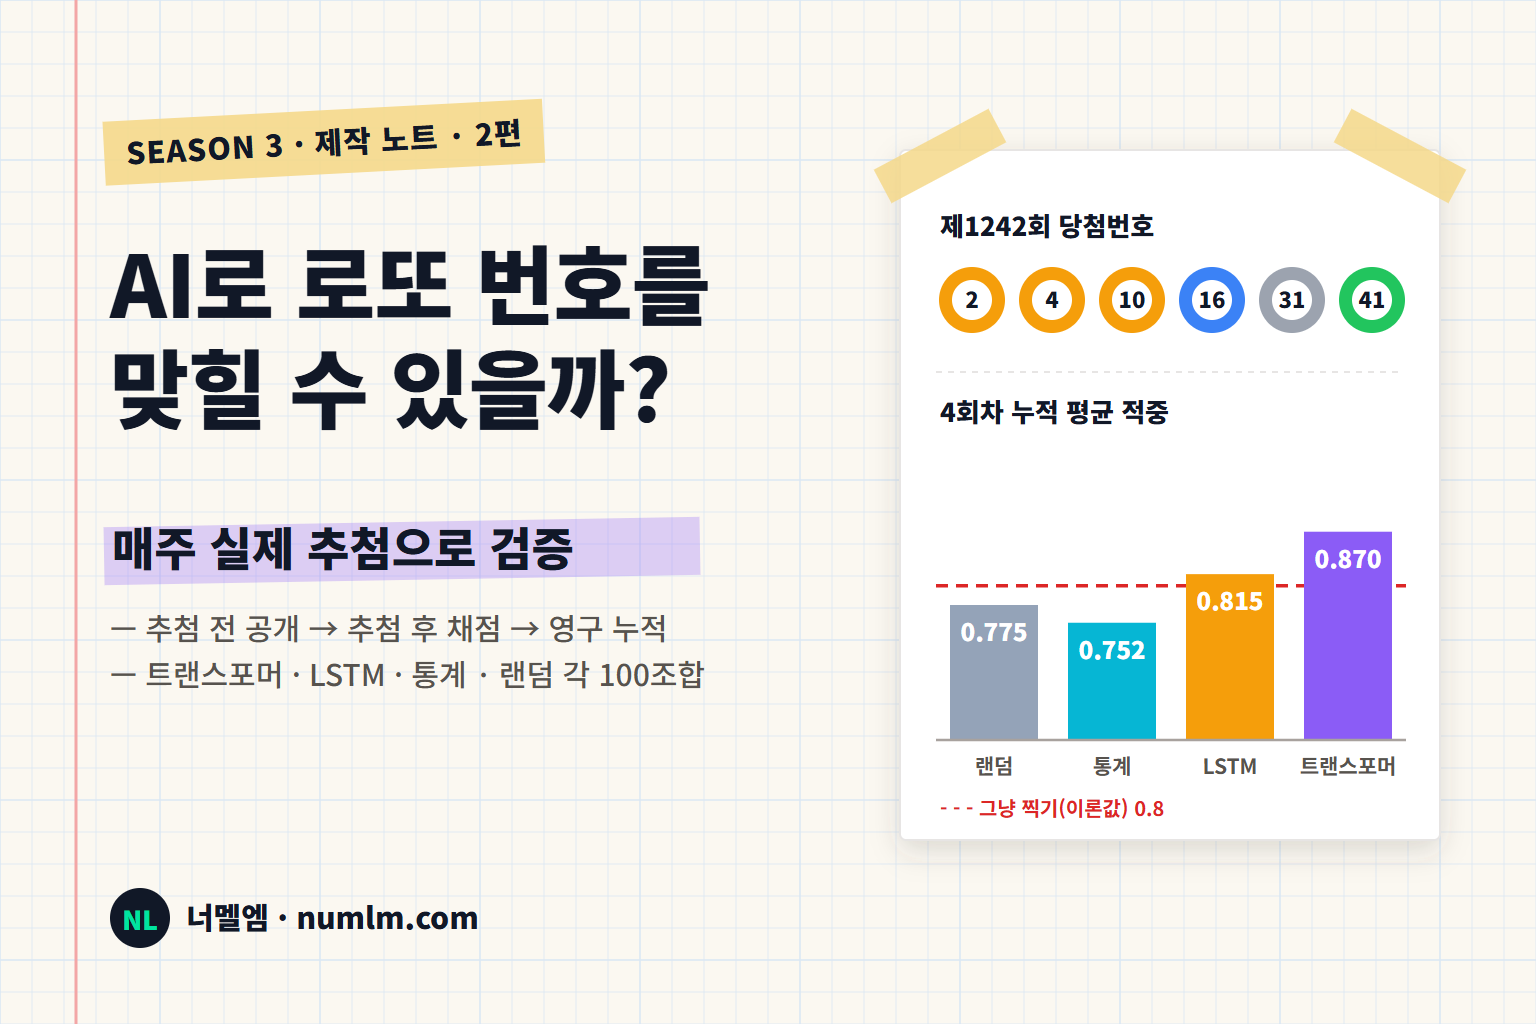
🧪 이 글의 수치는 2026년 9월 26일(제1242회 채점) 기준입니다. 실험은 매주 계속되고, 이번 주 공개 번호와 최신 누적 성적은 너멜엠 AI 로또 실험 페이지에서 바로 볼 수 있습니다. (링크는 글 끝에 모아 두었습니다)
⚡ 3분 요약
- 역대 로또 6/45 당첨 이력(1,242회)으로 실제로 학습한 트랜스포머·LSTM, "많이 나온 번호·함께 나온 번호"를 정직하게 구현한 통계 기법, 그리고 아무 분석 없는 균등 난수(대조군)가 매주 각 100조합을 냅니다.
- 규칙은 셋 — 판매 마감(토요일 20:00 KST) 전에 공개, 추첨 후 자동 채점, 결과는 영구 누적. 잘 나온 주만 골라 보여줄 수 없는 구조입니다.
- 완전 무작위라면 조합 하나당 평균 0.8개가 맞고, 100조합당 3개 이상 맞는 조합은 약 2.4개입니다(초기하분포). 4회차 1,600조합의 실측은 0.752 ~ 0.870 — 네 기법 모두 이 근처였어요.
- 지금은 트랜스포머가 1등(평균 0.870, 3개 이상 16조합, 기대 9.5)입니다. 그런데 계산해 보니 네 기법 중 하나가 순전히 운으로 이만큼 앞설 확률이 약 16% — 6~7번 실험하면 한 번은 나오는 일이에요.
- 두 모델의 본 적 없는 회차에 대한 손실은 2.61~2.63으로, 무작위 추첨의 이론 하한 2.273 아래로 내려가지 못합니다. "번호를 쓰는 형식은 배워도, 어떤 번호가 나올지는 못 배운다"의 실측입니다.
👉 한 문장으로 — AI가 로또를 못 맞히는 건 모델이 약해서가 아니라 배울 패턴이 없어서이고, 그 사실은 믿으라고 할 게 아니라 추첨 전에 공개하고 채점해서 보여줘야 합니다. 그리고 "지금 1등인 AI"를 볼 때마다 먼저 물어야 할 질문은 하나예요 — 우연으로도 그만큼 나오는가?
오늘 함께 공개한 시즌 3 1편에서는 1억 6천만 파라미터 언어모델을 직접 만들며, AI가 "학습한다"는 게 결국 다음에 올 것을 맞히는 게임이라는 걸 실제 학습 로그로 보여 드렸습니다. 이 글은 그 짝입니다 — 배울 패턴이 없는 데이터를 만나면, 같은 방식의 학습은 어떻게 될까요? 로또는 그 질문에 딱 맞는 데이터입니다. 매주 공개되고, 20년 넘게 쌓였고, 수많은 사람이 "패턴이 있다"고 믿는 데이터니까요.
사실 이 실험은 제 오래된 버릇에서 시작됐습니다. 로또를 살 때마다 같은 생각을 했어요. "지난주 번호가 이번 주 번호에 뭔가 영향을 주지 않을까? 제대로 분석하면 예측할 수 있지 않을까?" 그래서 유명하다는 방법들을 찾아봤습니다. 많이 나온 번호, 한동안 안 나온 번호, 자주 함께 나온 번호 쌍, 직전 회차와의 관계… 그렇게 분석해서 번호를 고르고, 로또를 사고, 기대감으로 일주일을 기다렸습니다. 그런 주가 여러 번 있었어요. 결과는 매번 꽝이었습니다.
꽝이 반복되면 보통 두 가지 중 하나를 생각하게 됩니다. "방법이 틀렸나, 아니면 운이 없었나." 그런데 한 사람이 몇 주 사 보는 걸로는 이 둘을 절대 구분할 수 없어요. 조합 몇 장, 몇 주로는 표본이 너무 작거든요. 그래서 제가 해 보고 싶었던 그 분석들을 한꺼번에, 매주, 기법마다 100조합씩 돌리고 그 결과를 전부 공개 채점하기로 했습니다. 제가 일주일씩 기다리며 품었던 질문에, 이번에는 기대감이 아니라 숫자로 답을 받아 보려고요.
검색창에 "로또 AI"를 쳐 보면 예상번호를 뽑아 준다는 곳이 가득합니다. 그런데 이상한 공통점이 있어요. 지난주에 뽑아 준 번호가 몇 개 맞았는지를 매주 빠짐없이 공개하는 곳은 찾기 어렵습니다. 맞은 주는 홍보하고 틀린 주는 조용히 넘어가면, 어떤 방법이든 "적중률이 높아 보이게" 만들 수 있기 때문이죠. 그래서 반대로 해 보기로 했습니다.
STEP 1실험 설계 — 먼저 적고, 나중에 채점하고, 고치지 않는다
과학에서는 이런 방식을 사전 등록(pre-registration)이라고 부릅니다. 결과를 보기 전에 무엇을 어떻게 잴지 먼저 공개해 두는 거예요. 결과를 본 뒤에 분석 방법을 고르면 거의 무엇이든 "유의미하게" 만들 수 있다는 게 알려지면서, 심리학·의학 연구에서 표준이 되어 가는 방식입니다. 이 실험의 규칙도 그 정신을 그대로 따릅니다.
- 판매 마감(토요일 20:00 KST) 전에 각 기법이 100조합씩 만들어 페이지에 공개합니다. 생성 시각이 기록되고, 마감이 지나면 새로 만들 수 없어요.
- 모든 조합은 시드(난수의 씨앗)가 공개되어 있습니다. 회차 번호×1000+기법 번호. 같은 이력과 같은 코드면 누구든 똑같은 100조합을 다시 만들 수 있습니다.
- 추첨 결과가 들어오면 자동으로 채점되고 누적 표에 더해집니다. 빼는 기능은 없어요.
참가 선수는 넷입니다(9월 26일부터 다섯째가 합류했는데, 그 얘기는 STEP 5에서). ① 균등 난수 — 1~45에서 아무 분석 없이 6개를 뽑는 대조군. ② 통계 기법 — 처음엔 "많이 나온 번호" 비율대로 뽑는 빈도 가중, 제1241회부터는 "직전 회차 번호와 과거에 함께 나온 번호"에 점수를 주는 마르코프 체인 방식. ③ LSTM과 ④ 트랜스포머 디코더 — 역대 당첨 이력을 "7, 12, 23, … 구분자, 3, 19, …"처럼 한 줄로 이어 붙여, 1편의 언어모델과 똑같이 "다음 번호 맞히기"로 실제 학습시킨 모델입니다.
그림으로 보면 단순하지만, 핵심은 가운데 자물쇠입니다. 채점하는 쪽이 추첨 결과를 알기 전에 예측이 고정된다는 것 — 이것 하나가 "AI 예상번호" 광고와 실험을 가르는 선이에요.
STEP 2기준선 — "그냥 찍으면" 몇 개가 맞을까
어떤 기법이 잘했는지 말하려면 먼저 아무 생각 없이 찍었을 때의 성적을 알아야 합니다. 로또 6/45는 45개 중 6개를 뽑으니, 내가 고른 번호 하나가 당첨번호에 들어 있을 확률은 6/45 ≈ 13.3%예요. 6개를 골랐으니 평균적으로 6 × 6/45 = 0.8개가 맞습니다. 조합 하나에서 k개가 맞을 확률은 초기하분포라는 공식으로 정확히 계산돼요.
완전 무작위 조합 100개를 샀을 때의 기대 성적 (초기하분포)
| 맞힌 개수 | 한 조합의 확률 | 100조합 중 기대 개수 |
|---|---|---|
| 0개 | 40.1% | 40.1 |
| 1개 | 42.4% | 42.4 |
| 2개 | 15.1% | 15.1 |
| 3개 (5등) | 2.24% | 2.24 |
| 4개 (4등) | 0.136% | 0.14 |
| 5개 | 0.0029% | 0.003 |
| 6개 (1등) | 1/8,145,060 | 0.00001 |
이 표가 이 실험의 결승선입니다. 어떤 기법이든 평균 0.8개, 3개 이상 약 2.4개(100조합당) 근처에 머물면 "찍은 것과 구분되지 않는다"는 뜻이고, 이보다 꾸준히 높아야 비로소 "뭔가 배웠다"고 말할 수 있어요. 여기서 "꾸준히"가 중요합니다 — 한 주, 두 주 잘 나오는 건 STEP 4에서 보듯 흔한 일이거든요.
STEP 34회차 1,600조합의 채점 결과 — 트랜스포머가 1등이다
제1239회(8월 29일)부터 제1242회(9월 19일)까지 4회차가 채점됐습니다. 기법마다 400조합, 합쳐서 1,600조합이에요. 회차별 평균 적중부터 보면 이렇습니다.
회차별 평균 적중 개수 (각 기법 100조합, 이론값 0.80)
| 회차 | 랜덤 | 통계 | LSTM | 트랜스포머 |
|---|---|---|---|---|
| 제1239회 | 0.79 | 0.80 | 0.86 | 0.85 |
| 제1240회 | 0.73 | 0.85 | 0.67 | 0.87 |
| 제1241회 | 0.75 | 1.05 | 0.98 | 0.78 |
| 제1242회 | 0.83 | 0.31 | 0.75 | 0.98 |
통계 기법의 널뛰기를 보세요. 제1241회에 1.05로 전체 최고였다가, 바로 다음 주 제1242회에는 0.31로 전체 최저가 됐습니다. 같은 방법, 같은 코드인데요. 어느 한 주의 숫자만 보고 "이 방법이 된다/안 된다"를 말하면 안 되는 이유가 이 한 줄에 다 들어 있습니다. 4회차를 합친 누적 성적은 아래와 같아요.
트랜스포머가 앞서 있습니다. 평균 0.870개로 이론값 0.8보다 높고, 3개 이상 맞힌 조합이 16개로 기대치 9.5개를 크게 넘었어요. 4개를 맞힌 조합(4등)도 두 번 나왔습니다. 반대로 대조군인 랜덤이 0.775, "많이 나온 번호"를 따라간 통계 기법이 0.752로 뒤쪽이고요.
이 그림만 떼어 광고에 쓰면 이렇게 됩니다 — "실제 학습한 트랜스포머 AI, 무작위 대비 적중률 +12%, 3개 이상 적중 1.7배!" 숫자는 전부 사실이에요. 그런데 이 문장은 틀렸습니다. 왜 틀렸는지가 이 글에서 제일 중요한 부분입니다.
STEP 4"1등 AI"는 우연일까 — 네 명이 달리면 누군가는 앞선다
확인하는 방법은 간단합니다. 아무것도 배우지 않은 선수 네 명을 같은 조건으로 달리게 해 보는 거예요. 무작위 추첨 4회에, 네 명이 각각 100조합씩 순전히 무작위로 낸다 — 이걸 컴퓨터로 2만 번 반복하고, "누군가 트랜스포머만큼 잘하는 경우"가 몇 번 나오는지 셉니다. 결과는 이렇습니다.
아무것도 못 배운 선수 4명 × 4회차 × 100조합, 2만 번 모의실험
| 사건 | 미리 정한 한 명이 | 4명 중 누구라도 |
|---|---|---|
| 평균 적중 0.870 이상 | 4.1% | 15.5% |
| 3개 이상 적중 16조합 이상 | 3.6% | 12.5% |
왼쪽 열만 보면 "4% 확률의 일이 일어났다, 트랜스포머가 뭔가 배웠다"고 말하고 싶어집니다. 하지만 그건 트랜스포머를 미리 찍어 두고 실험했을 때만 쓸 수 있는 숫자예요. 우리는 네 명을 달리게 한 뒤, 결과를 보고 나서 제일 잘한 한 명을 골랐습니다. 그러면 봐야 하는 건 오른쪽 열 — 네 명 중 누구든 이만큼 앞설 확률, 약 16%입니다. 6~7번 실험하면 한 번은 이런 "1등 AI"가 나온다는 뜻이에요.
통계학에서는 이걸 다중비교 문제라고 부릅니다. 비교하는 대상이 많을수록, 순전히 운으로 "유의미해 보이는" 결과가 하나쯤 나올 확률이 커져요. 로또 예측 광고가 보여 주는 "적중 사례"가 대부분 이 구조입니다 — 수많은 방법·수많은 회차 중 잘 맞은 것만 모으면, 아무 방법도 효과가 없어도 인상적인 사례는 반드시 생깁니다. 그래서 이 실험은 결과를 고르지 않고 전부 누적합니다. 트랜스포머의 우위가 진짜라면 회차가 쌓일수록 벌어질 거고, 운이라면 0.8 쪽으로 돌아올 겁니다. 판정은 그때 합니다.
🧭 직접 겪어 보니 — 실험을 시작하고 두 번 기법을 바꿨습니다. 제1241회에 통계 기법을 빈도 가중에서 마르코프 체인으로, 제1243회에는 "직전 회차 번호를 후보에서 뺀다"는 규칙을 없앴어요(실제 추첨에서도 직전 번호는 평균 0.8개가 다시 나오니까요). 두 번 다 판매 마감 전이었고, 교체 전 100조합을 지우지 않고 페이지에 "변경 기록"으로 남겼습니다. 그런데 두 번째 교체를 하고 나서야 깨달았습니다 — 마감 전이라도 이미 공개한 번호를 바꾸는 건, 그 사이에 번호를 본 사람에게는 "고친 것"이에요. 그 뒤로 규칙을 하나 더 넣었습니다. 한 번 공개한 조합은 어떤 이유로도 바꾸지 않고, 새 방법은 다음 회차부터. 사전 등록은 선언보다 지키는 게 어렵다는 걸 몸으로 배운 한 주였습니다.
STEP 5왜 AI도 못 배울까 — 손실이 멈추는 벽, 2.273
성적표 말고 모델 속을 들여다보는 방법도 있습니다. 1편에서 다룬 손실(loss)이요. 두 모델은 매주 역대 이력 중 최근 20회를 떼어 놓고(홀드아웃) 나머지로 학습합니다. 이번 주 기준 제1~1222회로 학습하고, 한 번도 본 적 없는 제1223~1242회로 시험을 보는 거예요.
여기서 재미있는 숫자가 하나 있습니다. 번호 45개 중 아무거나 찍는 모델의 손실은 ln 45 ≈ 3.807입니다. 그런데 이 모델들은 번호를 오름차순으로 적고, 여섯 개마다 구분자를 넣는 형식으로 학습하거든요. 형식을 완벽히 익히면 — 예를 들어 "40 다음엔 41~45만 올 수 있다"를 알면 — 손실이 내려갑니다. 그 하한이 ln C(45,6) / 7 ≈ 2.273이에요. 한 회차의 불확실성(816만 가지 중 하나) 전체를 토큰 7개에 나눈 값이라, 추첨이 공정한 한 어떤 모델도 이 아래로는 못 내려갑니다.
두 모델 모두 3.807에서 2.6 근처까지 내려왔습니다. 꽤 배운 것처럼 보이죠. 하지만 그 하락분은 전부 초록 구간 — 형식입니다. "번호는 오름차순이고, 여섯 개마다 끊긴다"를 배운 거예요. 본 적 없는 회차에서의 손실(2.61~2.63)은 빨간 벽 2.273에 한참 못 미치고, 벽 아래로 내려갈 방법은 원리적으로 없습니다. 1편의 언어모델이 손실 11에서 2.27까지 내려오며 한국어를 배운 것과 비교하면 차이가 선명해요. 배울 패턴이 있는 데이터에서는 벽이 훨씬 아래에 있고, 로또에서는 형식을 배우고 나면 바로 벽입니다.
그러면 STEP 3의 트랜스포머 1등은 뭘까요? 모델의 손실이 벽에 막혀 있다는 건, 모델이 내는 번호 분포가 "추첨이 실제로 뽑는 분포"보다 나을 수 없다는 뜻입니다. 그래서 성적표의 차이는 모델 안이 아니라 운에서 왔다고 보는 게 자연스러워요. 이 해석이 맞는지도 결국 누적 표가 답합니다.
9월 26일부터는 다섯 번째 선수도 합류했습니다. 일본에서 알려진 후나츠식 규칙, 많이 나온 번호(Hot/Cold), 오래 안 나온 번호(Gap), 자주 함께 나온 쌍, 베이즈·마르코프 모델, 기계학습, 위의 두 딥러닝 모델까지 세계적으로 쓰이는 로또 분석법을 전부 합친 "세계 로또 통합 예측"이에요. 질문은 "여러 방법을 합치면 나아지나?"입니다. 과거 20회차로 미리 재 본 성적은 당첨번호 로그손실 3.806 대 균등 3.807 — 사실상 같았습니다. 이 선수의 공식 성적은 제1243회부터 0에서 시작해 쌓입니다.
✅ 30초 복습 — 오늘 배운 것
- ✔예측은 먼저 적어야 채점할 수 있다 — 판매 마감 전 공개, 추첨 후 자동 채점, 영구 누적. 사전 등록의 원리.
- ✔기준선은 조합당 0.8개 — 6 × 6/45. 100조합당 3개 이상 약 2.4개, 1등 1/8,145,060 (초기하분포).
- ✔4회차 실측 0.752 ~ 0.870 — 네 기법 모두 기준선 근처. 같은 통계 기법이 한 주 1.05, 다음 주 0.31.
- ✔"1등 AI"는 다중비교로 따진다 — 결과를 보고 고른 1등이 이만큼 앞설 확률은 약 16%. 미리 정한 한 명 기준(4%)을 쓰면 속는다.
- ✔손실의 벽 2.273 — 형식은 배워서 3.807 → 2.6, 내용은 못 배워서 본 적 없는 회차에서 벽을 못 넘는다.
- 🧪이번 주 공개된 다섯 기법의 100조합, 회차별 채점, 누적 표, 시드·학습 범위까지 너멜엠 AI 로또 실험 페이지에서 직접 확인할 수 있다. (링크는 아래에)
이번 주 번호는 이미 공개되어 있습니다 — 추첨 후에 같이 채점해 보세요
너멜엠(NumLM) AI 로또 실험 페이지에는 이번 회차 다섯 기법의 100조합(공개 시각·시드 포함),
지난 회차 채점 결과, 이 글의 누적 표가 매주 자동으로 갱신됩니다. 번호 추천이 아니라 검증 기록입니다.
🎱 AI 로또 실험 — 이번 주 공개 번호와 누적 성적 →
numlm.com/lotto-ai-experiment · 영어판 numlm.com/en/lotto-ai-experiment
한 발 더 들어가고 싶다면
- 복습: 함께 공개한 1편(밑바닥부터 LLM 만들기)의 손실 곡선과 이 글의 손실 사다리를 나란히 놓으면 "배울 패턴이 있는 데이터"와 "없는 데이터"의 차이가 한눈에 보입니다. 1편(동전 1000번 던지기)의 큰 수의 법칙은 "회차가 쌓이면 0.8로 돌아온다"의 근거이고, 5편(마르코프 체인 입문)은 통계 기법이 쓰는 전이확률의 원리예요.
- 같은 사이트 안에서: 통계 기법이 계산하는 전이확률은 마르코프 체인 실험실에서 직접 계산해 볼 수 있고, 이 실험의 트랜스포머와 같은 구조는 디코더 아틀라스에서 숫자로 한 단계씩 따라갈 수 있습니다. 초기하분포·균등분포는 개념 페이지에서 공식과 함께 다룹니다.
- 다음 편 예고: "ChatGPT는 왜 오래 생각할수록 똑똑해질까?" — 추론 모델이 답하기 전에 "생각하는 토큰"을 쓰는 이유를 해부합니다.
참고 자료
본문의 실험 수치는 이 실험의 공개 채점 기록(2026년 9월 26일, 제1242회 채점 기준)에서 그대로 가져왔고, 모의실험(2만 회)은 같은 조건으로 직접 돌린 결과입니다. 개념과 방법은 다음 원문을 기준으로 썼습니다.
- 동행복권 — 로또 6/45 게임 방법(1~45 중 6개 선택, 당첨 등위와 확률). 추첨 규칙의 공식 출처 · 동행복권 공식 사이트
- Nosek, Ebersole, DeHaven & Mellor (2018) — "The preregistration revolution", PNAS 115(11), 2600–2606. 결과를 보기 전에 분석 계획을 공개하는 사전 등록의 원리 · 원문(DOI)
- Benjamini & Hochberg (1995) — "Controlling the False Discovery Rate: A Practical and Powerful Approach to Multiple Testing", Journal of the Royal Statistical Society B 57(1), 289–300. 여러 비교를 할 때 우연한 "발견"을 통제하는 방법 · 원문(DOI)
- Tversky & Kahneman (1971) — "Belief in the law of small numbers", Psychological Bulletin 76(2), 105–110. 작은 표본의 결과를 과신하는 경향 — "한 주 잘 맞았다"를 믿게 되는 이유 · 원문(DOI)
- Hochreiter & Schmidhuber (1997) — "Long Short-Term Memory", Neural Computation 9(8), 1735–1780. 실험에 쓴 LSTM의 원전 · 원문(DOI)
- Vaswani 외 (2017) — "Attention Is All You Need", NeurIPS 2017. 실험에 쓴 트랜스포머 디코더의 원전 · 원문(arXiv)
마무리 — AI의 한계를 보여 주는 가장 정직한 방법
돌아보면 제가 로또를 사며 붙잡았던 "이전 번호가 다음 번호에 영향을 주지 않을까"라는 질문은, 이 실험의 통계 기법(직전 회차와 함께 나온 번호)과 다섯 번째 선수(유명한 분석법 전부)가 그대로 대신 묻고 있습니다. 제가 혼자 몇 주 해 보고 "운이 없었나" 하던 일을, 이제는 매주 수백 장 규모로 기록하고 있는 셈이에요. 그리고 지금까지의 답은 — 제 꽝들과 똑같이 — 기준선 0.8 근처입니다.
공정한 추첨이라면 과거가 미래를 바꾸지 못한다는 건 확률론의 기본입니다. 그래도 굳이 매주 돌리는 이유는, "AI는 로또를 못 맞힌다"는 말보다 "AI가 추첨 전에 낸 1,600조합의 채점표"가 훨씬 설득력 있기 때문입니다. 그리고 채점표를 쌓다 보면 이번 주처럼 "트랜스포머가 1등"인 순간이 옵니다. 그 순간에 흥분하지 않고 "우연으로도 16%"라고 계산하는 것 — 그게 이 실험이 정말 가르치고 싶은 겁니다.
그런데, 고백할 게 하나 있습니다
실험 페이지에는 "어떤 기법도 당첨 확률을 높이지 못한다, 이건 실험이다"라고 적어 두었습니다. 그런데 정작 이 실험을 만든 저는, 이번 주 새로 합류한 세계 로또 통합 예측의 조합 중에서 골라 로또를 샀습니다.
변명은 하지 않겠습니다. 그 조합이 유리해서 산 게 아니라는 건 제가 제일 잘 압니다. 세계 통합 예측이 고른 조합도 1등 확률은 1/8,145,060으로 다른 어떤 조합과 똑같고, 로또는 판매액의 절반가량이 당첨금으로 돌아가니 1,000원짜리 한 장의 기대 환급액은 대략 500원입니다. 숫자로는 처음부터 지는 게임이에요.
그래도 샀습니다. 도입부에서 쓴 것처럼, 분석해서 번호를 고르고 일주일을 기다리던 그 기대감을 저는 아직 버리지 못했나 봅니다. 그래서 이 고백을 이 글에 남깁니다 — 확률을 아는 것과 기대를 끊는 것은 다른 일이고, 그 틈이 바로 "예상번호" 광고가 파고드는 자리라는 걸 제 영수증이 보여 주니까요. 다만 저는 이 한 장을 투자가 아니라 일주일치 기대감을 산 오락비로 셈합니다. 여러분께 권할 생각은 여전히 없습니다.
트랜스포머의 1등은 다음 주에 사라질 수도, 조금 더 버틸 수도 있습니다. 어느 쪽이든 누적 표에 그대로 남아요. 몇 주 뒤에 이 글의 숫자와 페이지의 숫자를 나란히 놓고 보시면, "적은 표본의 인상"이 "큰 수의 법칙"으로 바뀌는 과정을 직접 보시게 될 겁니다.
그 1등이 실력인지는, 한 번 더 달려 봐야 안다.
너멜엠(NumLM) — 확률부터 LLM까지, 원리부터 제대로 배우는 자기주도 학습 플랫폼
#로또 #로또확률 #AI로또 #트랜스포머 #LSTM #확률과통계 #AI공부
※ 이 글은 LLM 도구를 활용해 초안을 작성한 뒤, 실험 채점 기록의 수치와 학술 출처는 발행 전 직접 검증·편집했습니다. 이 글은 복권 구매를 권하지 않으며, 어떤 기법도 당첨 확률을 높이지 못합니다. 본문에 사실과 다른 부분을 발견하시면 댓글로 알려주시면 즉시 반영하겠습니다.