시즌 3 — 사용자에서 제작자로 · 1편
ChatGPT를 내 컴퓨터 한 대로 만들 수 있을까? — 밑바닥부터 LLM 만들기, 실제 학습 로그로
그래픽카드 한 장, 17시간. 1억 6천만 파라미터짜리 한국어 언어모델을 데이터부터 배포까지 직접 만들었습니다. 이 글의 숫자는 전부 그 학습 로그에서 그대로 가져온 값입니다.
LLM 제작·사전학습 · SFT · DPO·13분 읽기
🧪 이 글의 모든 차트는 정지 화면입니다. 글에 나오는 학습 곡선을 마우스로 읽고, 완성된 모델에 직접 질문을 던져 토큰별 확률까지 보는 것은 너멜엠 miniLLM 실행실에서 할 수 있습니다. (링크는 글 끝에 모아 두었습니다)
⚡ 3분 요약
- LLM은 마법이 아니라 여섯 공정으로 만들어지는 소프트웨어입니다 — 데이터 정제 → 토크나이저 → 사전학습 → 지도 미세조정(SFT) → 선호 정렬(DPO) → 배포. 어느 회사든 큰 틀은 같습니다.
- 저는 이 여섯 공정을 그래픽카드 한 장(RTX 4080)으로 전부 직접 수행했습니다. 1억 6천만 파라미터, 19.6억 토큰, 사전학습 14.5시간 + 미세조정 2.5시간.
- 손실(loss)은 11.24에서 2.27로 떨어졌습니다. 11.1은 "6만 5천 개 단어 중 아무거나 찍기", 2.27은 "후보를 열 개 남짓으로 좁히기"라는 뜻이에요.
- 사전학습만 끝난 모델은 질문에 답하지 못하고 문장을 이어 쓰는 기계입니다. 같은 가중치에 대화 예시 41만 개(SFT)와 선호 쌍 6,400개(DPO)를 더하자 비로소 "서울특별시입니다"라고 답했어요.
- 완성본은 176MB 파일 하나 — 서버도 GPU도 없이 브라우저 안에서 돌아갑니다. 크기가 다를 뿐, ChatGPT와 같은 공정입니다.
👉 한 문장으로 — LLM 제작은 "천재의 발명"이 아니라 "데이터를 먹이고, 다음 단어 맞히기를 시키고, 대화 예시로 형식을 가르치는 공정"이에요. 그 공정의 실제 로그를 이 글에서 보고, 너멜엠 miniLLM 실행실에서 완성된 모델을 직접 돌려보면 "AI가 배운다"는 말의 정체가 손에 잡힙니다.
시즌 2를 마치며 이렇게 예고했습니다 — "다음 시즌은 그 손으로 직접 만들어 봅니다." 그 첫 편입니다. 그리고 14편에서 잠깐 보여드린 게 있었죠. 직접 사전학습시키던 1억 6천만 파라미터 한국어 모델이 94% 지점에서 "대한민국 수도는 어디인가요?"라는 질문에 "2014년 3월 6일 서울이 대한민국 수도가…" 하고 문장을 이어 쓰던 장면요. 그 모델이 완성됐습니다. 오늘은 그 모델이 어떻게 만들어졌고, 무엇을 배웠고, 무엇을 못 배웠는지를 학습 로그 그대로 보여드리려고 합니다.
먼저 솔직하게 규모부터요. ChatGPT급 모델은 수천억 파라미터를 GPU 수천 장으로 수개월 학습합니다. 제 모델은 파라미터가 1억 6천만 개, 그래픽카드 한 장으로 17시간입니다. 대략 천 분의 일, 만 분의 일 규모예요. 그런데도 이 글을 쓰는 이유는 하나입니다 — 공정이 같기 때문입니다. 규모를 줄이면 각 단계에서 무슨 일이 일어나는지가 오히려 또렷하게 보입니다.
여섯 공정을 순서대로 거치면, 누구의 컴퓨터에서든.
STEP 1여섯 공정 — 어느 회사든 큰 틀은 같다
GPT·클로드·제미나이가 만들어지는 과정을 한 줄로 늘어놓으면 이렇습니다. ① 재료 준비(웹 문서·책을 모아 광고·중복·저품질을 걸러냄) → ② 토크나이저(텍스트를 숫자 조각으로 바꾸는 사전 만들기) → ③ 사전학습("다음 토큰 맞히기"를 수십억 번 반복) → ④ 지도 미세조정(SFT)(질문→답변 예시로 대화 형식 가르치기) → ⑤ 선호 정렬(RLHF/DPO)(두 답변 중 사람이 더 좋아한 쪽을 고르게 하기) → ⑥ 평가·배포. 전체 비용의 90% 이상이 ③에 들고, 모델의 지식·말투·편향은 대부분 ①에서 결정됩니다.
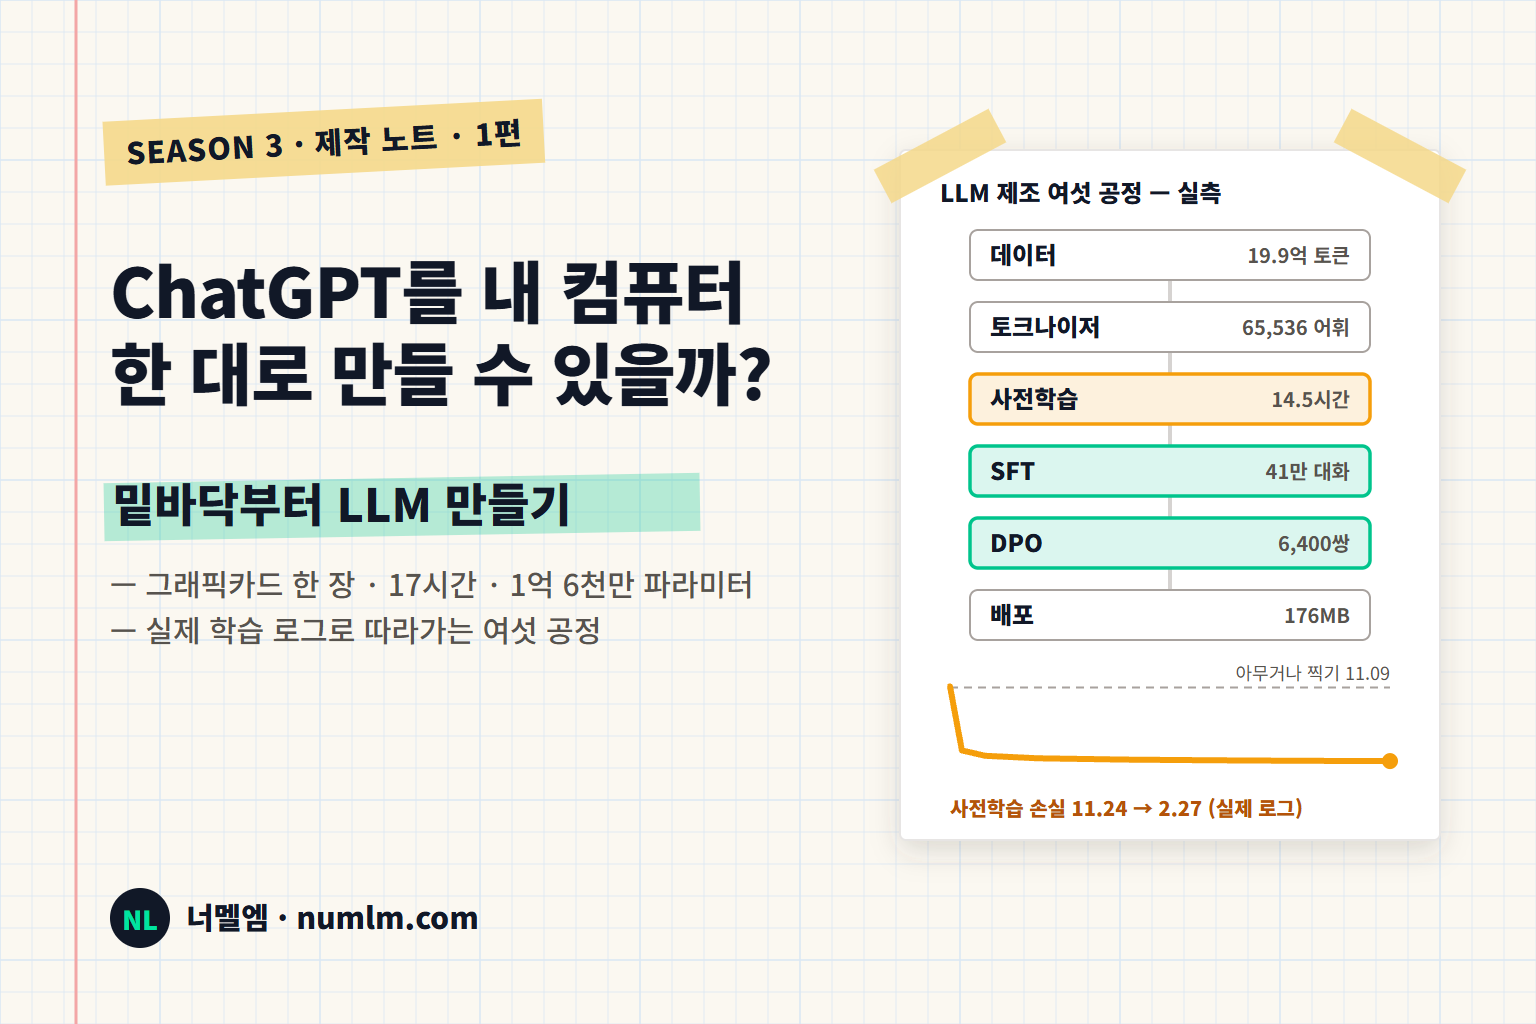
제가 만든 모델의 실제 수치를 이 여섯 칸에 채워 넣으면 아래 그림이 됩니다. 딱 하나 빌린 게 있는데, ② 어휘사전은 Qwen이라는 공개 모델의 것을 가져와 줄여 썼습니다(이유는 STEP 2에서). 나머지는 전부 제 손으로 돌린 공정입니다.
그림에서 하나만 먼저 기억해 두세요. ③에서 14.5시간, ④⑤를 합쳐 2.6시간. 지식과 언어 능력은 거의 전부 사전학습에서 생기고, 우리가 "챗봇답다"고 느끼는 부분은 그 뒤 두 시간 반이 만듭니다. 이 비율이 이 글의 뼈대입니다.
STEP 2재료와 사전 — 20억 토큰, 그리고 6만 5천 개 어휘
재료는 한국어 텍스트 6.9GB였습니다. 일반 말뭉치 85%에 백과사전 15%를 섞었어요. 신경망은 글자를 못 읽으니 전부 숫자 조각, 즉 토큰으로 바꿔야 합니다. 여기서 첫 번째 실무적 결정이 나옵니다 — 사전을 직접 만들 것인가, 빌릴 것인가.
저는 Qwen이라는 공개 모델의 어휘사전(24만 8천 개)을 가져와 제 말뭉치에 실제로 쓰인 6만 5,536개만 남기는 방식을 택했습니다. 이유는 파라미터 예산이에요. 어휘 하나마다 768개짜리 숫자 벡터가 붙는데, 24만 8천 개를 그대로 쓰면 어휘 벡터만으로 1억 9천만 파라미터 — 모델 전체 예산을 혼자 넘깁니다. 6만 5,536개(정확히 2의 16제곱이라 토큰 하나를 2바이트에 담을 수 있습니다)로 줄이니 5천만 파라미터로 내려왔고, 그런데도 말뭉치의 99.997%를 덮었습니다. 20억 토큰 중 사전에 없어 바이트로 쪼갠 경우는 5만 6천 번, 0.003%였어요.
사전을 직접 훈련하는 실습도 해봤는데, 결과가 재미있었습니다. 한국어만으로 3만 2,768개짜리 사전을 훈련하니 토큰 하나가 평균 4.87글자를 담았어요. 빌린 Qwen 사전은 3.74글자였고요. 어휘가 8분의 1인데 한국어 효율은 30% 좋았습니다 — "안녕하세요"를 토큰 하나로 담으니까요. 그런데도 빌린 이유는 다국어·코드·이모지에 대한 강건성과 검증 비용이었습니다. 실무에서 늘 마주치는 트레이드오프예요.
이렇게 6.9GB를 토큰으로 바꾸면 19억 9천만 개의 숫자가 일렬로 늘어선 파일이 됩니다. 사전학습은 이 줄에서 아무 위치나 1,025개를 잘라 와서 "앞 1,024개를 보고 다음 1개를 맞혀라"를 반복하는 일입니다. 그게 전부예요.
STEP 3사전학습 — 손실이 11.24에서 2.27로 떨어지는 14시간
모델 구조는 시즌 2 13편의 어텐션이 18층 쌓인 트랜스포머 디코더입니다. 은닉 차원 768, 문맥 길이 1,024, 파라미터 1억 6,360만 개. 학습은 "다음 토큰 맞히기" 한 가지 목표로 29,980스텝, 한 스텝에 6만 5천 토큰씩, 총 19억 6천만 토큰을 보게 했습니다. RTX 4080 한 장으로 초당 약 4만 토큰을 처리해 14시간 31분이 걸렸어요.
학습이 잘 되고 있는지는 손실(loss) 하나로 봅니다. 손실은 "정답 토큰에 모델이 준 확률의 마이너스 로그"예요. 아무것도 모르는 모델은 6만 5,536개 어휘에 똑같은 확률을 주니까 손실이 ln(65,536) = 11.09가 됩니다. 아래 곡선이 실제 로그입니다.
곡선을 읽는 법입니다. 11.24에서 시작해 800스텝(전체의 3%) 만에 3.5까지 떨어집니다 — 조사·어미·흔한 단어처럼 "쉬운 규칙"을 먼저 흡수하는 구간이에요. 그 뒤로는 완만하게 내려가 2.27에서 끝납니다. 손실을 e의 지수로 바꾼 값을 perplexity라고 하는데, e2.27 ≈ 9.7이에요. 이 숫자는 "매 위치에서 모델이 후보를 열 개 남짓으로 좁혔다"로 읽으면 됩니다. 처음엔 6만 5천 개 중 하나를 찍던 모델이, 열 개 중 하나를 고르는 모델이 된 거예요.
동그라미(검증 손실)가 굵은 선보다 살짝 위에 있는 것도 보세요. 학습에 쓰지 않은 텍스트에서는 2.70으로, 학습 텍스트의 2.27보다 조금 나쁩니다. 이 간격이 암기와 이해의 차이예요. 간격이 벌어지기 시작하면 모델이 외우기 시작했다는 신호라서, 실무에서는 학습 손실보다 검증 손실을 봅니다. 14시간 동안 이 두 값을 30분마다 확인하는 게 사전학습 기간의 일과였습니다.
여기서 직접 겪은 실패담 하나. 어느 날 학습 속도가 에러 한 줄 없이 10분의 1로 떨어졌습니다. 초당 6만 토큰 나와야 할 게 6천~9천이었어요. 원인은 메모리였습니다 — 손실을 계산할 때 [배치×문맥, 어휘 6만 5천]짜리 거대한 행렬이 잠깐 만들어지는데, 이게 그래픽카드 메모리 16GB를 넘겨 버렸고, 윈도우 드라이버는 "메모리 부족" 에러를 내는 대신 조용히 시스템 RAM으로 넘겨서 계속 돌렸습니다. 느려진 이유를 모른 채 하루를 날릴 뻔했죠. 단계별로 시간을 재 보고서야 잡았고, 한 번에 처리하는 배치를 절반으로 줄이는 대신 두 번 누적하는 방식(수학적으로 같은 학습)으로 바꾸자 속도가 돌아왔습니다. "GPU 학습이 느리면 원래 그런가 보다 하지 말고 측정하라" — 이 프로젝트에서 제일 비싸게 배운 교훈입니다.
STEP 4같은 가중치, 다른 태도 — 이어쓰기 기계가 답하기 시작한 순간
사전학습이 끝난 모델은 똑똑하지만 대화를 못 합니다. 14편의 그 장면이 정확히 이겁니다. "대한민국 수도는 어디인가요?"에 답 대신 "2014년 3월 6일 서울이 대한민국 수도가…"라고 이어 썼죠. 틀린 게 아니에요. 모델이 배운 유일한 게임이 "다음에 올 법한 글 잇기"니까, 질문 뒤에 올 법한 문장을 이은 겁니다. 이 상태의 모델을 base 모델이라고 부릅니다.
그다음 두 공정이 이 본능을 "답변"으로 돌려놓습니다. SFT(지도 미세조정)는 질문→답변 대화 41만 2,258개를 정해진 형식(<|im_start|>user … <|im_start|>assistant)으로 보여주며 "이 틀 다음엔 답변이 온다"를 가르칩니다. 손실은 답변 토큰에만 계산해요 — 질문을 외우라는 게 아니라 답하는 법을 배우라는 뜻입니다. 2시간 16분, 4,580스텝. 손실은 3.11에서 1.88로 내려왔습니다(답변 부분만 재니 사전학습과 스케일이 다릅니다).
DPO(선호 정렬)는 마지막 손질입니다. 같은 질문에 대한 "채택 답변 / 거절 답변" 쌍 6,400개를 보여주고, 채택 쪽에 더 높은 확률을 주도록 조정합니다. 방금 만든 SFT 모델을 기준으로 얼어붙여 두고 상대적 변화만 허용하기 때문에 언어 능력은 보존되고 태도만 바뀌어요. 16분 만에 끝났고, 채택 답변을 더 선호할 확률은 50%(동전 던지기)에서 97.5%가 됐습니다. 새 지식은 하나도 안 들어갔습니다 — 장황하게 탈선하는 버릇을 줄이는, 말 그대로 "정렬"이에요.
이 그림이 이 글에서 제일 중요합니다. 두 출력을 만든 모델의 지식은 거의 같습니다. 오른쪽이 답을 아는 건 SFT가 "서울"을 가르쳐서가 아니라, 사전학습 때 이미 배운 것을 답변 형식으로 꺼내는 법을 가르쳤기 때문이에요. 그래서 실무에서는 "모델에게 새 지식을 가르치려면 미세조정"이 아니라 "형식과 태도는 미세조정, 지식은 사전학습 데이터 또는 검색(14편의 RAG)"이라고 나눕니다. 이 모델을 직접 돌려보면 그 경계가 손에 잡혀요 — 너멜엠 miniLLM 실행실에는 같은 모델을 "이어쓰기 모드"와 "채팅 모드"로 번갈아 실행하는 버튼이 있습니다.
STEP 5배포 — 176MB 파일 하나가 브라우저에서 돈다
마지막 공정은 모델을 "쓸 수 있는 물건"으로 만드는 일입니다. 학습 직후의 모델은 파라미터가 16비트 실수라 327MB인데, 이걸 8비트 정수로 바꾸는 양자화를 거치면 176MB가 됩니다. 품질 손실은 거의 없어요. 그리고 GGUF라는 단일 파일 형식으로 묶으면 파이썬도 GPU도 없이 llama.cpp라는 프로그램이 읽어서 실행합니다 — 일반 CPU에서 초당 43~49 토큰. 심지어 같은 파일을 웹브라우저 안에서 돌릴 수도 있습니다. 서버로 아무것도 보내지 않고, 방문자의 컴퓨터가 계산하는 거예요.
그렇게 브라우저에 올린 모델에 "대한민국의 수도는 어디인가요?"를 넣으니 "대한민국의 수도는 서울특별시입니다."가 초당 30토큰 남짓으로 찍혀 나왔습니다. 14편에서 문장을 이어 쓰던 그 모델이요. 솔직히 이 순간이 17시간 중 제일 좋았습니다.
한계도 분명히 적어 둡니다. 1억 6천만 파라미터는 작습니다. 조금만 어려운 질문을 하면 그럴듯한 거짓말을 하고(14편의 할루시네이션 그대로), 같은 말을 반복하기도 합니다. 그래서 이 모델의 쓸모는 "쓸 만한 챗봇"이 아니라 "작은 모델이 무엇을 배우고 무엇을 못 배우는지를 관찰하는 교보재"예요. 실행실에서 온도(temperature)나 반복 감점을 만져보면 그 경계가 어디인지 바로 보입니다.
🔗 시즌 2와 이어지는 선 — 13편의 어텐션을 18층 쌓은 게 이 모델의 구조이고, 11편의 역전파가 14시간 동안 한 일이 저 손실 곡선이며, 14편의 "이어쓰기 기계"가 SFT를 거쳐 답하기 시작한 게 STEP 4입니다. 시즌 2에서 배운 부품이 실제로 조립되는 걸 보는 것 — 그게 시즌 3의 첫 편을 이 글로 여는 이유입니다.
✅ 30초 복습 — 오늘 배운 것
- ✔여섯 공정 — 데이터 정제 → 토크나이저 → 사전학습 → SFT → DPO → 배포. 규모가 다를 뿐 ChatGPT와 같은 공정이다.
- ✔사전학습이 전부의 85% — 19.6억 토큰, 14.5시간. 손실 11.24(아무거나 찍기) → 2.27(후보 열 개 남짓). 검증 손실과의 간격이 암기와 이해의 차이.
- ✔base 모델은 이어쓰기 기계 — 질문에 답 대신 문장을 잇는다. 틀린 게 아니라 배운 게임이 그것뿐이라서.
- ✔SFT·DPO는 지식이 아니라 형식과 태도 — 대화 41만 개, 선호 쌍 6,400개, 합쳐서 2.6시간. 같은 가중치가 "서울특별시입니다"라고 답하게 된다.
- ✔배포는 176MB 파일 하나 — 8비트 양자화 + GGUF. CPU에서도, 브라우저에서도 돈다.
- 🧪손실 곡선을 마우스로 읽고, 완성 모델을 이어쓰기/채팅 모드로 직접 실행하며 토큰별 확률을 보는 것은 너멜엠 miniLLM 실행실에서 할 수 있다. (링크는 아래에)
이 모델, 지금 브라우저에서 직접 돌려볼 수 있습니다
너멜엠(NumLM) miniLLM 실행실에는 이 글의 학습 곡선(사전학습·SFT·DPO)을 마우스로 읽는 모니터, 토크나이저 체험,
그리고 완성된 176MB 모델을 브라우저에 올려 이어쓰기/채팅 모드로 실행하며 토큰별 확률을 보는 플레이그라운드가 있습니다. 학습 문서 16편도 함께 읽을 수 있어요.
🧪 miniLLM 실행실 — 직접 돌려보기 → 이 모델의 구조를 숫자로 걷기 (디코더 아틀라스) →
numlm.com/llm-lab/mini-llm · numlm.com/llm-lab/decoder-atlas
한 발 더 들어가고 싶다면
- 다음 편 예고: "AI로 로또 번호 맞힐 수 있을까?" — 이 글과 같은 트랜스포머를 로또 당첨 이력으로 학습시키면 무슨 일이 생길까요. 매주 실제 추첨으로 검증하는 실험 결과를 정리합니다.
- 복습: 13편(어텐션 — 이 모델의 부품) → 11편(역전파 — 손실 곡선을 만든 힘) → 14편(RAG — 지식은 검색으로, 형식은 미세조정으로)을 이어 읽으면 오늘 글의 여섯 공정이 시즌 2 위에 정확히 얹힙니다.
- 이론 페이지: 사전학습·SFT·RLHF 각 단계의 수식과 배경은 너멜엠 LLM 이론에서 단계별로 다룹니다.
참고 자료
본문의 수치는 제가 학습한 모델의 로그 파일(스텝별 손실·학습률·처리량 기록)에서 그대로 가져왔고, 공정의 이름과 원리는 다음 원문을 기준으로 썼습니다.
- Radford 외 (2019) — "Language Models are Unsupervised Multitask Learners" (GPT-2). "다음 토큰 예측"만으로 언어 능력이 생긴다는 사전학습의 원전 · 원문(OpenAI)
- Ouyang 외 (2022) — "Training language models to follow instructions with human feedback", NeurIPS 2022. SFT → 보상 모델 → RLHF로 이어지는 InstructGPT의 3단계 · 원문(arXiv)
- Rafailov 외 (2023) — "Direct Preference Optimization: Your Language Model is Secretly a Reward Model", NeurIPS 2023. 보상 모델 없이 선호 쌍으로 직접 정렬하는 DPO · 원문(arXiv)
- Sennrich, Haddow & Birch (2016) — "Neural Machine Translation of Rare Words with Subword Units", ACL 2016. 토크나이저의 바이트 쌍 인코딩(BPE) · 원문(arXiv)
마무리 — 만들어 보면 "배운다"는 말의 정체가 보인다
17시간짜리 로그를 다 보고 나면 "AI가 배운다"는 말이 아주 구체적인 뜻으로 바뀝니다. 20억 개의 정답을 하나씩 맞혀 보고, 틀린 만큼 1억 6천만 개의 숫자를 아주 조금씩 고치는 일을 3만 번 반복하는 것. 마법도 의식도 없고, 그래서 규모를 천 배 키워도 원리는 같습니다. 그리고 그 끝에 나온 모델은 아는 것도 많고 모르는 것도 많은, 작지만 진짜 언어모델이었어요.
시즌 3는 이렇게 "직접 만들어 보는" 이야기로 갑니다. 다음 편에서는 같은 모델을 전혀 다른 데이터 — 로또 당첨 이력 — 에 물려 봅니다. 배울 패턴이 없는 데이터를 만나면 이 학습 곡선은 어떻게 될까요.
그 둘을 가르는 선을 본 사람은, AI를 다르게 씁니다.
너멜엠(NumLM) — 확률부터 LLM까지, 원리부터 제대로 배우는 자기주도 학습 플랫폼
#LLM만들기 #사전학습 #SFT #DPO #트랜스포머 #ChatGPT원리 #AI공부
※ 이 글은 LLM 도구를 활용해 초안을 작성한 뒤, 학습 로그의 수치와 학술 출처는 발행 전 직접 검증·편집했습니다. 본문에 사실과 다른 부분을 발견하시면 댓글로 알려주시면 즉시 반영하겠습니다.