시즌 2 — AI를 만드는 손 · 마지막 편
ChatGPT는 어떻게 스스로 일을 처리할까? — AI 에이전트를 그림으로 뜯어보기
답만 하던 AI가 계산기를 두드리고 데이터베이스를 뒤집니다. 그런데 사실 모델은 도구를 직접 쓰지 않습니다 — 그 한 문장이 에이전트의 전부이자 한계입니다.
LLM 실전·에이전트 · Tool Use·12분 읽기
🧪 이 글의 모든 차트는 정지 화면입니다. 에이전트가 쓰는 도구 중 하나인 검색은 지난 편의 넘스탯 RAG 실험실에서 직접 돌려볼 수 있고, 생각·행동·관찰 루프를 손으로 따라가는 단계별 예제는 이론 페이지에 있습니다. (링크는 글 끝에 모아 두었습니다)
⚡ 3분 요약
- 언어 모델은 정확한 계산·최신 정보·외부 상태 변경을 스스로 못 합니다. 그럴듯한 다음 단어를 고를 뿐이라, 큰 자릿수 곱셈조차 보장이 없어요.
- 도구 사용의 핵심 교환 — 모델이 자연어 대신 정해진 형식의 호출문(함수명+인자)을 출력하면, 시스템이 실제로 실행하고, 결과를 다시 모델 입력에 넣어 줍니다.
- 그래서 모델은 도구를 "직접" 쓰지 않습니다. 무엇을 쓸지 문자열로 지시할 뿐 — 실행 주체는 언제나 바깥의 시스템이에요.
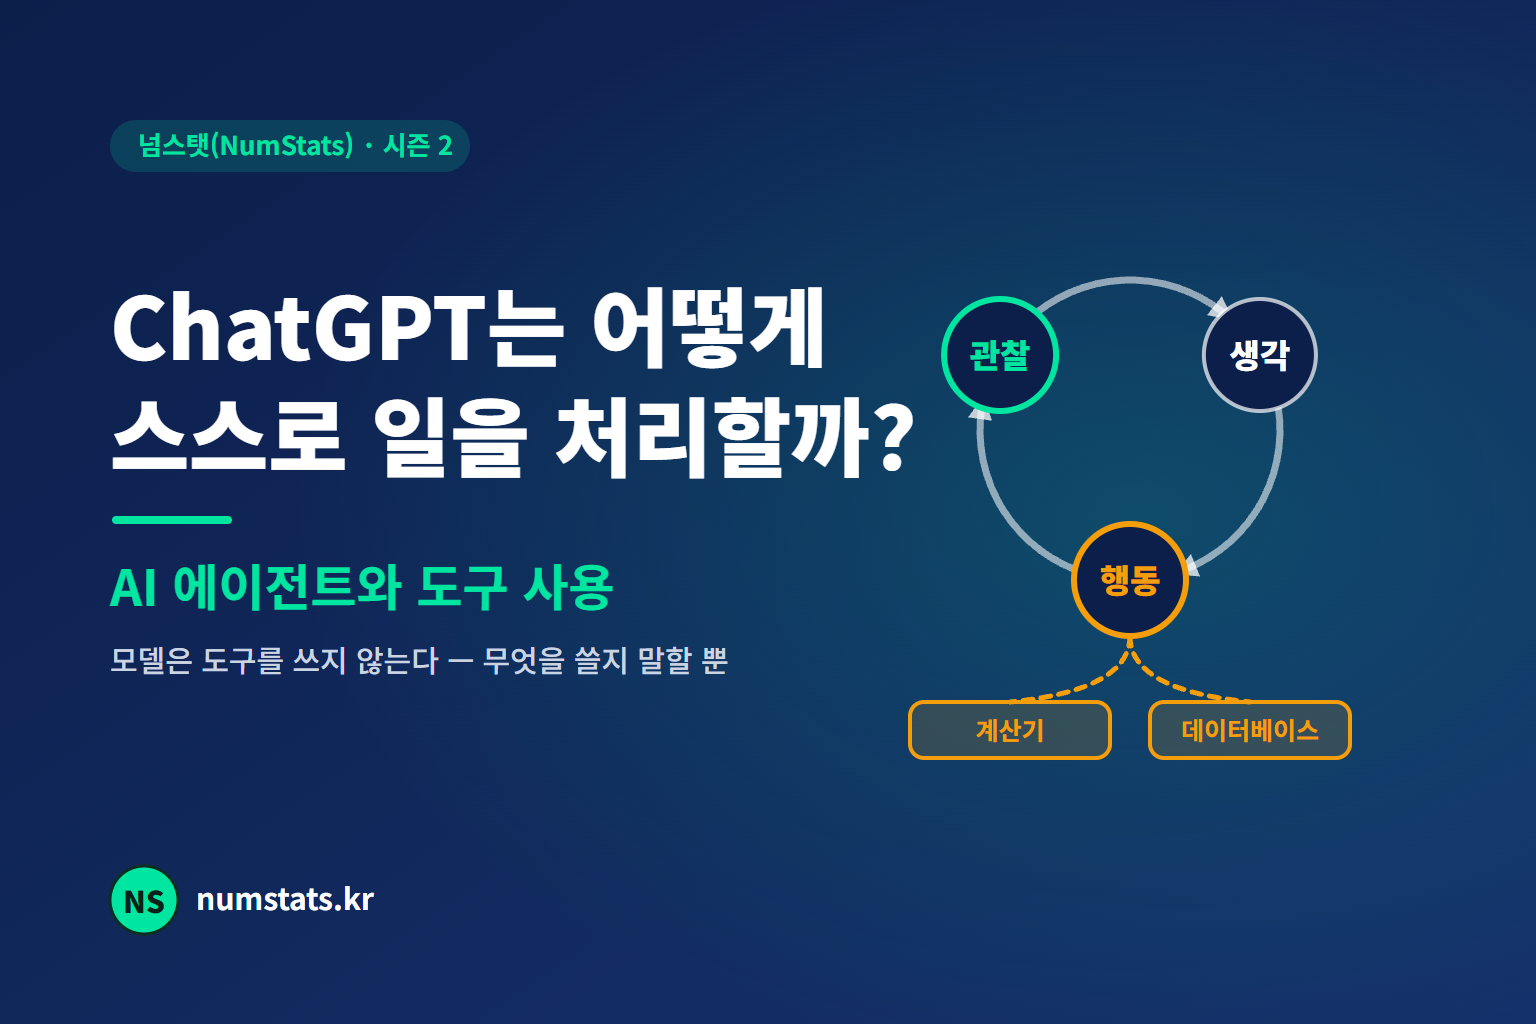
- 에이전트는 이 교환을 반복하는 것입니다. 생각 → 행동 → 관찰 → 다시 생각… (ReAct 패턴). 지난 편의 RAG는 "검색 도구 하나를 한 번만 쓰는" 특수한 경우였어요.
- 대가는 연쇄 오류입니다. 단계마다 90% 성공해도 5단계면 59% — 그리고 루프는 스스로 멈추지 않으므로 종료 조건과 실행 권한은 사람이 설계해야 합니다.
👉 한 문장으로 — 에이전트는 "똑똑해진 AI"가 아니라 "호출문을 쓰는 AI + 그걸 실행해 주는 시스템 + 그 결과를 되먹이는 루프"예요. 세 부품 중 모델이 하는 일은 첫 번째뿐이라는 걸 알면, 어디서 잘되고 어디서 위험한지가 한 번에 보입니다.
지난 14편에서 RAG를 해부하며 이렇게 끝맺었습니다 — "이제 기계는 배우는 법, 보는 법, 읽는 법, 찾아보는 법을 갖췄다." 오늘은 시즌 2의 마지막, 행동하는 법입니다. 그런데 이 편은 앞의 네 편과 성격이 조금 다릅니다. 새 신경망 구조가 나오지 않아요. 나오는 것은 모델 바깥에 무엇을 붙이느냐의 이야기입니다.
먼저 이 질문부터요. 챗봇에게 "3,127 곱하기 419는?" 하고 물어보신 적 있나요? 몇 년 전 모델들은 이런 문제에서 자릿수를 틀리곤 했습니다. 이상하죠 — 계산기 앱은 30년 전에도 이걸 완벽히 했는데, 수천억 파라미터짜리 모델이 왜? 답은 지난 편의 그 문장에 있습니다. 모델은 계산하는 게 아니라 그럴듯한 다음 토큰을 고른다. 곱셈의 정확성을 보장하는 장치가 구조 어디에도 없는 거예요.
모델이 계산기를 부르게 하면 어떨까?
이 발상 하나가 "답하는 AI"를 "일하는 AI"로 바꿨습니다. 그 구조를 뜯어봅시다.
STEP 1한계 — 언어 모델이 스스로 못 하는 세 가지
언어 모델이 아무리 커져도 구조적으로 못 하는 일이 세 가지 있습니다. ① 정확한 계산 — 산술은 확률로 하는 게 아니니까요. ② 최신 정보 — 지식 컷오프 이후는 텅 비어 있습니다(14편). ③ 외부 상태 변경 — 모델의 출력은 어디까지나 텍스트라서, 이메일을 보내거나 데이터베이스를 고치는 일을 스스로 할 수 없어요.
셋의 공통점을 보세요. 전부 모델 바깥의 세계와 닿아야 하는 일입니다. 그렇다면 해법도 하나로 모입니다 — 모델에게 바깥과 닿는 손을 달아 주는 것. 그 손이 도구(tool)이고, 손을 쓰는 방법이 도구 사용(tool use)입니다.
이 그림에서 가장 중요한 건 가운데 세로선입니다. 모델은 왼쪽을 벗어나지 않아요. 모델이 만든 것은 calculator(expression="3127*419")라는 문자열이지, 계산 결과가 아닙니다. 그 문자열을 읽고 진짜 계산기를 돌리는 건 오른쪽의 시스템이고요. 그래서 이 문장이 에이전트 이해의 열쇠입니다 — 모델은 도구를 직접 쓰지 않는다. 무엇을 쓸지 지시할 뿐이다.
STEP 2루프 — 생각하고, 행동하고, 관찰하고, 다시 생각한다
도구를 한 번 쓰는 것과 일을 처리하는 것은 다릅니다. 실제 질문은 한 번의 호출로 끝나지 않거든요. 프린스턴·구글 연구진(Yao 외)이 2022년 공개해 ICLR 2023에 발표한 ReAct 패턴이 그 답입니다 — 이름 그대로 추론(Reasoning)과 행동(Acting)을 번갈아 생성하는 것. 논문의 표현을 옮기면, 추론 흔적은 행동 계획을 세우고 추적하고 갱신하는 데 쓰이고, 행동은 외부 지식원이나 환경과 접속해 추가 정보를 모아 옵니다.
말로 하면 추상적이니 손으로 따라가 봅시다. 도구는 딱 두 개 — 매출 데이터베이스를 읽는 db_query와 calculator. 질문은 "작년 매출 대비 올해 성장률은?" (아래 매출 숫자는 설명용 예시 값입니다.)
왜 세 바퀴였을까요? 매 바퀴의 생각이 "지금 무엇을 알고, 무엇이 없는가"를 갱신하고, 거기에 맞춰 다음 행동을 정했기 때문입니다 — 한 번에 하나의 미지값만 해결하면서요. 이것이 ReAct의 요지입니다. 그리고 3바퀴를 보세요. 모델은 두 숫자를 손에 쥐고도 직접 나누지 않고 계산기에 넘겼습니다. 정확성이 보장돼야 하는 일을, 보장을 주는 장치로 넘기는 것 — 도구 사용의 목적이 이 한 판단에 들어 있어요.
여기서 지난 편과 연결됩니다. RAG는 에이전트의 특수한 경우예요. 도구가 딱 하나(검색)이고, 그걸 정해진 순서로 한 번만 쓰는 형태죠. 에이전트는 그 제약을 풀어, 여러 도구를 스스로 골라 여러 번 씁니다. 14편의 RAG 실험실에서 보신 "검색이 틀리면 답도 틀린다"는 여기서 "도구 선택이 틀리면 그 뒤가 전부 틀린다"로 확장됩니다.
STEP 3도구를 어떻게 배우나 — 예시 몇 개로 스스로
그런데 모델은 calculator(...)라는 형식을 어떻게 알까요? 두 갈래가 있습니다. 하나는 프롬프트에 도구 설명과 사용 예시를 넣어 주는 것 — 13편·시즌 1에서 본 few-shot의 연장입니다. 다른 하나가 흥미로운데, 2023년 메타 연구진(Schick 외)의 Toolformer는 모델이 API마다 예시 몇 개만 받고, 자기지도(self-supervised) 방식으로 어디에 어떤 호출을 끼워 넣을지 스스로 배우게 했습니다. 논문 초록의 표현대로 "각 API에 대해 소수의 시연만 필요"했어요.
공통점은 이겁니다 — 도구 호출은 결국 특정 형식을 정확히 지키는 문제라는 것. 함수명 하나, 따옴표 하나 틀리면 시스템이 실행할 수 없으니까요. 시즌 1에서 다룬 "출력 형식 명시"가 왜 실무에서 그렇게 강조되는지, 에이전트에 오면 이유가 분명해집니다. 형식 준수가 곧 도구 사용의 생명이거든요.
STEP 4대가 — 단계가 늘수록 곱셈으로 무너진다
에이전트가 매력적인 만큼, 위험도 구조적입니다. 가장 큰 것이 연쇄 오류예요. 루프의 각 바퀴에서 올바른 도구와 인자를 고를 확률을 p라고 합시다. n바퀴를 전부 통과할 확률은 (각 단계가 독립이라는 단순화 아래) p의 n제곱입니다. 덧셈이 아니라 곱셈이라는 게 핵심이에요.
숫자를 짚어 봅시다. p=0.9면 3단계 0.9³=0.729(약 73%), 5단계 0.9⁵=0.59049(약 59%). p=0.95면 5단계 0.95⁵≈0.774(약 77%). 단계당 실패율을 10%에서 5%로 절반 줄였을 뿐인데 5단계 전체는 59%에서 77%로 벌어집니다. 실무에서 에이전트 성능을 올리는 작업이 "모델을 키우기"보다 "단계 수를 줄이고, 단계마다 검증을 끼우기"인 이유가 이 산수에 있어요.
두 번째 위험은 루프가 스스로 멈추지 않는다는 것. "생각 → 행동 → 관찰"은 종료 조건이 내장된 구조가 아니에요. 같은 호출을 무한 반복하거나, 실패한 도구를 계속 다시 부를 수 있습니다. 그래서 바퀴 수 상한, 동일 호출 재시도 제한 같은 고삐를 사람이 설계에 넣어야 합니다.
이건 제가 매일 목격하는 일이기도 합니다. 넘스탯의 실험실 페이지들을 만들 때 코딩 에이전트를 쓰는데, 옆에서 지켜보면 오늘 글의 그림이 그대로 재생돼요. 파일을 읽고(도구), 고치고(도구), 빌드를 돌리고(도구) — 생각→행동→관찰이 화면에 줄줄이 찍힙니다. 감탄스러운 날이 많지만, 실패한 빌드를 원인 분석 없이 같은 명령으로 다시 돌리려는 순간도 있습니다. 그때 멈추고 "지금 다른 프로그램이 그 파일을 잡고 있다"라고 알려주는 건 사람인 저예요. 루프의 고삐와 마지막 판단이 왜 설계자의 몫인지, 써 보면 하루 만에 체감됩니다.
세 번째가 가장 무겁습니다. 도구에 실행 권한을 주는 순간, "이메일을 보낸다", "파일을 지운다", "결제를 진행한다" 같은 되돌릴 수 없는 행동이 가능해집니다. 그래서 도구를 가역성으로 나누고 — 읽기(조회·계산)는 자유롭게, 되돌릴 수 없는 쓰기에는 사람의 확인 게이트를 두는 설계가 표준이 되어 갑니다. 모델은 도구를 직접 쓰지 않는다는 STEP 1의 문장이 여기서 안전장치가 됩니다 — 실행 주체가 시스템이니, 시스템에 문지기를 세울 수 있어요.
STEP 5시즌 2 완결 — 다섯 편이 한 줄로
돌아보면 시즌 2는 한 문장을 다섯 번 변주한 셈입니다. 11편의 역전파는 배우는 방법이었고, 12편의 CNN은 보는 구조, 13편의 어텐션은 읽는 구조, 14편의 RAG는 모르는 것을 찾아오는 방법, 그리고 오늘 15편의 에이전트는 바깥 세계에 손을 뻗는 방법입니다.
그리고 재미있는 대칭이 하나 있어요. 앞의 세 편은 모델 안쪽의 이야기였고(구조를 어떻게 짜고 어떻게 학습시키나), 뒤의 두 편은 모델 바깥쪽의 이야기입니다(무엇을 붙이고 어떻게 되먹이나). 요즘 "AI 활용"이라 부르는 것의 대부분은 후자에 있습니다 — 모델은 그대로 두고, 그 주변에 무엇을 놓느냐로 성능과 안전이 갈리니까요.
🔗 시즌 2의 관통선 — 구조는 달라져도 배우는 방법은 언제나 하나(역전파)였고, 모델이 하는 일은 언제나 하나(다음 토큰 고르기)였습니다. 어텐션도, RAG의 검색도, 에이전트의 호출문도 전부 그 위에 얹힌 것입니다. 이 두 문장을 잡고 있으면 다음에 어떤 새 이름이 나와도 위치를 잡을 수 있어요.
✅ 30초 복습 — 오늘 배운 것
- ✔한계 세 가지 — 언어 모델은 정확한 계산·최신 정보·외부 상태 변경을 스스로 못 한다. 전부 모델 바깥과 닿아야 하는 일이다.
- ✔도구 사용의 교환 — 모델은 호출문(함수명+인자)을 문자열로 출력할 뿐, 실행은 시스템이 하고 결과가 다시 입력으로 돌아온다. 모델은 도구를 직접 쓰지 않는다.
- ✔ReAct 루프 — 생각 → 행동 → 관찰 → 다시 생각. 한 바퀴에 미지값 하나씩. RAG는 검색 도구 하나를 한 번 쓰는 특수 사례.
- ✔연쇄 오류 — 전체 성공률은 pⁿ. 단계당 90%도 5단계면 59%. 단계를 줄이고 검증을 끼우는 게 모델을 키우는 것보다 먼저다.
- ✔안전 설계 — 루프는 스스로 멈추지 않는다. 바퀴 상한·재시도 제한, 그리고 되돌릴 수 없는 행동에는 사람의 확인 게이트.
- 🧪생각·행동·관찰 3바퀴 손계산과 연쇄 오류 산수는 넘스탯 이론 페이지에서 단계별로, 에이전트의 "검색" 도구는 RAG 실험실에서 직접 돌려볼 수 있다. (링크는 아래에)
에이전트, 읽었다면 이제 손으로 따라갈 차례
넘스탯(NumStats) AI 에이전트 이론 페이지에서는 생각·행동·관찰 3바퀴 손계산과 연쇄 오류 산수, 가역성 기준의 안전 설계를 3단계로 다루고,
RAG 실험실에서는 에이전트가 쓰는 도구 중 하나인 검색을 두 방식으로 직접 대결시켜 볼 수 있습니다.
🧪 에이전트 루프 단계별 따라가기 → 검색 도구 직접 돌려보기 (RAG 실험실) →
numlm.com 이론 · AI 에이전트와 도구 사용 · numlm.com/llm-lab/rag
한 발 더 들어가고 싶다면
시즌 2가 여기서 완결됩니다. 다음 시즌은 "사용자에서 제작자로" — 직접 만들어 보는 이야기입니다.
- 시즌 3 예고: 이번 시즌이 "AI를 만드는 손"의 원리였다면, 다음은 그 손으로 실제로 무언가를 만들어 보는 시즌입니다
- 복습: 14편(RAG — 도구 하나) → 오늘 글(에이전트 — 도구 여럿을 루프로)을 이어 읽으면 "모델 바깥에 무엇을 붙이나"의 그림이 완성됩니다. 그 앞의 11~13편은 "모델 안쪽" 편입니다
참고 자료
본문의 용어·인용은 다음 원문을 기준으로 작성했습니다. 매출 예시의 숫자는 설명용으로 지어낸 값입니다.
- Yao 외 (2023) — "ReAct: Synergizing Reasoning and Acting in Language Models", ICLR 2023. 추론과 행동을 번갈아 생성하는 에이전트 패턴의 원전 — "추론 흔적이 행동 계획을 세우고 갱신하며, 행동이 외부 지식원과 접속해 정보를 모은다" · 원문(arXiv)
- Schick 외 (2023) — "Toolformer: Language Models Can Teach Themselves to Use Tools". API마다 소수의 시연만으로 자기지도 방식으로 도구 호출을 학습 · 원문(arXiv)
- Lewis 외 (2020) — "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks", NeurIPS 2020. 본문에서 "에이전트의 특수한 경우"로 언급한 RAG의 원전 (14편 참조) · 원문(arXiv)
마무리 — 손을 달아 준 것이지, 머리를 바꾼 것이 아니다
오늘 내용을 한 줄로 줄이면 이거예요. "에이전트는 모델에게 바깥 세계와 닿는 손을 달아 준 것이지, 모델의 머리를 바꾼 것이 아니다." 모델은 여전히 다음 토큰을 고를 뿐이고, 그 토큰이 호출문일 때 시스템이 대신 손을 움직입니다. 그래서 힘도 거기서 나오고, 위험도 거기서 나옵니다 — 손이 닿는 범위를 정하는 건 모델이 아니라 설계하는 사람이에요.
시즌 2를 여기서 마칩니다. 배우는 법(11편), 보는 법(12편), 읽는 법(13편), 찾아보는 법(14편), 행동하는 법(15편) — 다섯 편이 "AI를 만드는 손"의 다섯 손가락이었어요. 다음 시즌에서는 그 손으로 직접 만들어 봅니다.
그 말을 실행할지 정하는 것은, 끝까지 사람의 몫입니다.
시즌 3에서 만나요.
넘스탯(NumStats) — 확률부터 LLM까지, 원리부터 제대로 배우는 자기주도 학습 플랫폼
#AI에이전트 #ToolUse #함수호출 #ReAct #LLM #ChatGPT원리 #AI공부
※ 이 글은 LLM 도구를 활용해 초안을 작성한 뒤, 학술 출처와 수치 정확성은 발행 전 직접 검증·편집했습니다. 본문에 사실과 다른 부분을 발견하시면 댓글로 알려주시면 즉시 반영하겠습니다.