시즌 2 — AI를 만드는 손
AI는 왜 어떤 단어에 더 집중할까? — Attention을 그림으로 뜯어보기
문장을 읽을 때 모든 단어가 똑같이 중요하진 않습니다. 어디를 볼지 스스로 배우는 장치 — ChatGPT의 심장, 어텐션(Attention)을 Q·K·V의 수학까지 해부합니다.
LLM 입문·Attention · Q·K·V·11분 읽기
🧪 이 글의 모든 차트는 정지 화면입니다. 어텐션 히트맵·Q·K·V 계산·번역 정렬까지, 넘스탯 LLM 실험실에서 문장을 바꿔가며 직접 확인할 수 있어요. (링크는 글 끝에 모아 두었습니다)
⚡ 3분 요약
- 어텐션 이전의 번역 모델은 문장 전체를 고정 크기 벡터 하나에 압축했습니다 — 긴 문장일수록 정보가 뭉개지는 병목이 생겨요.
- 어텐션(2014)의 해법 — 요약본 하나에 의존하지 말고, 단어를 만들 때마다 원문 전체를 다시 보며 관련 단어에 가중치를 준다.
- 계산의 뼈대는 검색입니다 — Query(내가 찾는 것) · Key(각 단어의 색인표) · Value(실제 내용물). Q와 K의 유사도로 가중치를 만들고, V를 가중합합니다.
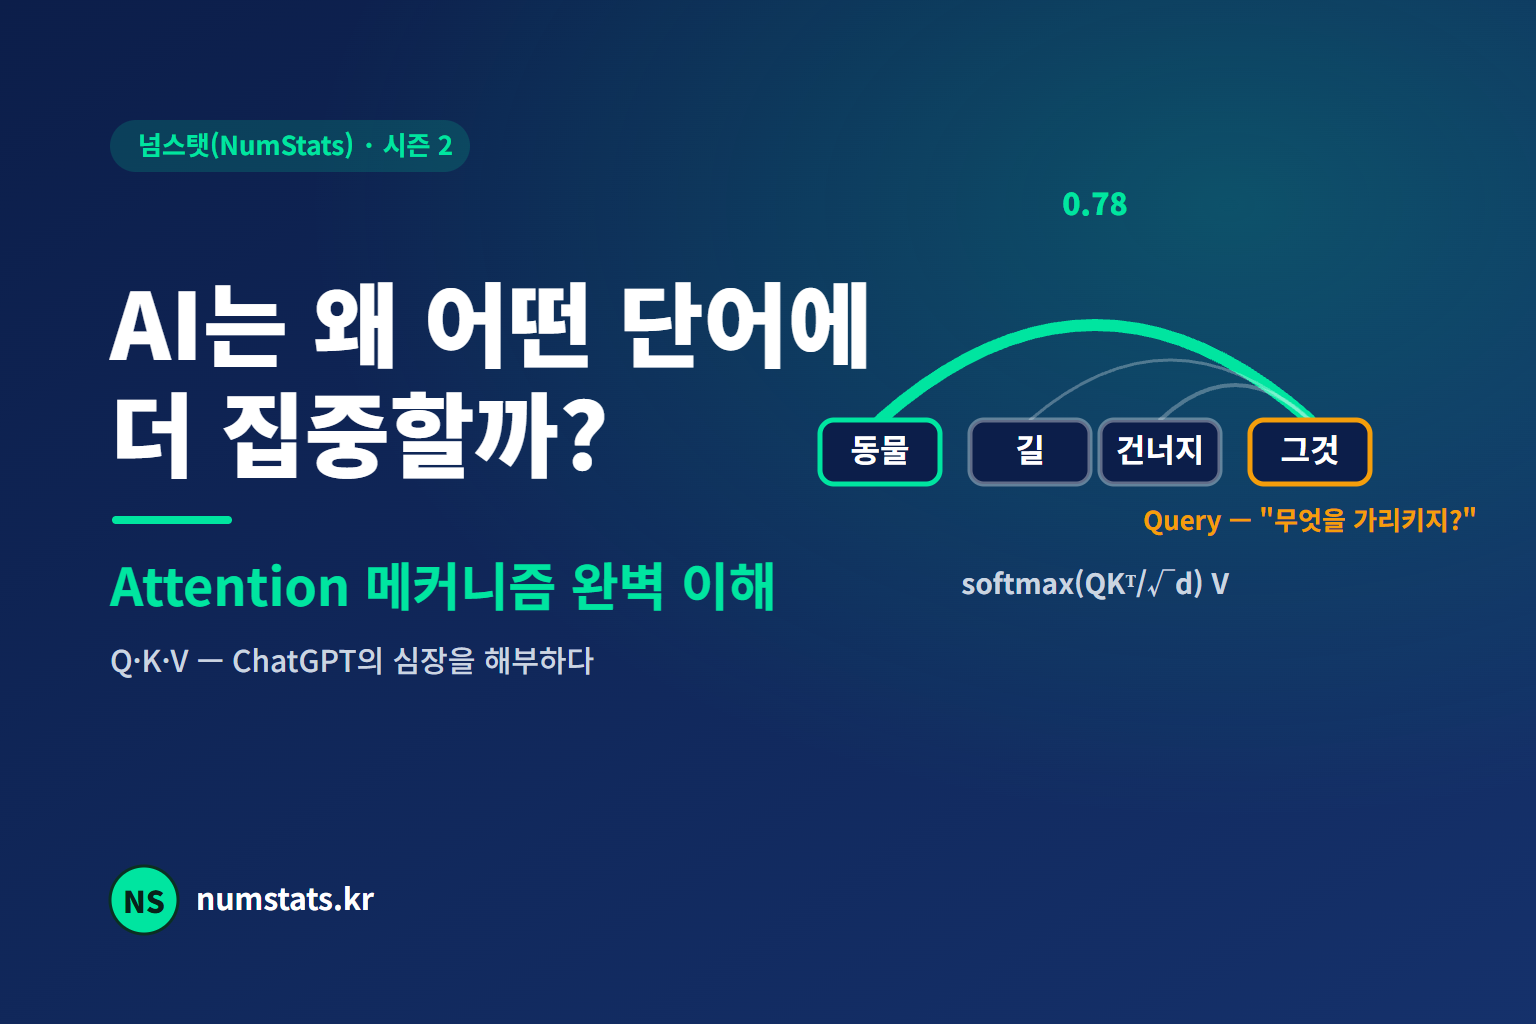
- 셀프 어텐션은 문장이 스스로를 바라보는 것 — "그것"이라는 대명사가 문장 안의 "동물"을 찾아내 문맥을 채웁니다. 수식은 단 한 줄, softmax(QKᵀ/√dk)V.
- 2017년 "Attention Is All You Need"는 순환(RNN)을 아예 버리고 어텐션만으로 Transformer를 만들었고 — 이것이 ChatGPT까지 이어지는 LLM 시대의 시작입니다.
👉 한 문장으로 — 어텐션은 "지금 이 단어를 처리하는 데 문장의 어디를 얼마나 참고할지"를 검색(Q·K·V)으로 계산해, 매번 새로 맞춤 요약을 만드는 장치예요.
시즌 1의 10편에서 ChatGPT의 뼈대가 Transformer라는 것을 봤고, "단어들이 서로를 참고한다"는 직관까지 왔습니다. 시즌 2에서는 11편에서 학습 엔진(역전파)을, 12편에서 기계의 눈(CNN)을 손에 넣었죠. 오늘은 예고했던 대로 그 직관을 수학까지 해부합니다 — AI는 문장을 읽을 때 왜, 어떻게, 어떤 단어에 더 집중하는가.
이 문장을 보세요. "그 동물은 길을 건너지 않았다. 그것은 너무 피곤했기 때문이다." 여러분은 "그것"이 동물이라는 걸 생각도 하기 전에 알았을 겁니다. 길이 피곤할 수는 없으니까요. 그런데 컴퓨터에게 "그것"은 그냥 두 글자입니다. "그것"이 문장 안의 무엇을 가리키는지 찾아내는 능력 — 이것이 언어 이해의 핵심이고, 어텐션이 푸는 문제입니다.
아무것도 제대로 안 보는 것과 같다."
— 어텐션이 태어난 이유
이야기는 ChatGPT가 아니라 번역기에서 시작합니다. 어텐션은 원래 기계 번역의 고질병 하나를 고치려고 태어났거든요. 그 병부터 봅시다.
STEP 1병목 — 문장 전체를 벡터 하나에 욱여넣다
2014년의 표준 번역 모델(Seq2Seq)은 두 부분으로 되어 있었습니다. 인코더가 원문을 읽어 고정 크기 벡터 하나로 요약하고, 디코더가 그 벡터만 보고 번역문을 한 단어씩 생성하는 구조죠. 비유하면 — 통역사가 연설 전체를 듣고 포스트잇 한 장에 요약한 뒤, 연설문 원본은 버리고 포스트잇만 보며 통역하는 방식입니다.
짧은 문장은 괜찮아요. 그런데 문장이 길어지면? 포스트잇 크기는 그대로인데 적을 내용은 늘어나니, 앞부분 정보가 뭉개지고 번역 품질이 뚝 떨어집니다. 이것이 고정 벡터의 병목(bottleneck) 문제입니다.
해결책은 돌이켜보면 당연합니다. 원본을 버리지 마라. 사람 통역사도 그렇게 하죠 — 요약 메모를 들고 있되, 막히면 원문의 해당 대목을 다시 봅니다. 이 "다시 보기"를 수학으로 만든 것이 어텐션입니다.
STEP 2어텐션의 탄생 — 매 단어마다, 원문 전체를 다시 본다
2014년 드미트리 바다나우·조경현·요슈아 벤지오가 낸 해법(ICLR 2015 발표)은 이렇습니다. 디코더가 번역 단어를 하나 만들 때마다, 원문의 모든 단어를 다시 훑어보고 "지금 이 단어를 만드는 데 각 원문 단어가 얼마나 관련 있나"를 점수로 매깁니다. 그 점수(어텐션 가중치)로 원문 정보를 가중평균해서, 지금 필요한 것만 담긴 맞춤 요약을 매번 새로 만드는 거예요. 포스트잇 한 장 대신, 단어마다 새로 쓰는 포스트잇인 셈이죠.
이 가중치를 시각화하면 놀라운 것이 보입니다. 누가 가르쳐주지 않았는데도, 모델이 "cat"을 만들 때 "고양이를"에, "saw"를 만들 때 "보았다"에 집중합니다 — 한국어(목적어가 동사 앞)와 영어(동사가 목적어 앞)의 어순 차이까지 스스로 알아낸 거예요. 물론 이 정렬을 사람이 짠 게 아닙니다. 11편의 역전파가 "번역을 잘 맞히는 가중치"를 찾다 보니 저절로 나타난 겁니다.
이 X자 패턴이 정말 나오는지, 번역 실험실을 만들면서 작은 번역 모델을 직접 학습시켜 봤습니다. 학습 초반의 히트맵은 온통 흐릿했어요 — 어디를 봐야 할지 몰라 아무 데나 보는 상태였죠. 그런데 손실이 내려가면서 저 교차 정렬이 서서히 진해지는 겁니다. 어순 재배열 규칙을 어디에도 넣어 준 적이 없는데도요. 그 히트맵이 또렷해지는 과정을 지켜본 것이, 이 글을 쓰기로 마음먹은 계기 중 하나였습니다.
STEP 3Q·K·V — 어텐션의 정체는 "부드러운 검색"이다
그럼 그 "관련도 점수"는 어떻게 계산할까요? 현대 어텐션의 표준 계산법은 검색 시스템의 구조를 그대로 닮았습니다. 도서관을 떠올려 보세요.
- Query(질의) — 내가 찾는 것. "고양이 관련 책 있나요?"
- Key(색인) — 각 책의 등에 붙은 제목표. 질의와 비교되는 대상
- Value(내용) — 책의 실제 내용물. 최종적으로 꺼내 가는 것
보통의 검색은 가장 잘 맞는 책 한 권을 꺼내죠. 어텐션은 다릅니다 — 모든 책을 조금씩, 관련도에 비례해서 꺼냅니다. Query와 각 Key의 유사도를 내적(dot product)으로 재고, softmax로 "합이 1인 가중치"로 바꾼 뒤, 그 가중치로 Value들을 가중합해요. 딱 잘라 고르는 대신 부드럽게 섞는 것 — 그래서 미분이 가능하고, 미분이 가능하니 역전파로 학습할 수 있습니다. 문장의 각 단어는 학습된 행렬 세 개를 곱해 자신의 Q·K·V 세 역할 벡터를 갖게 되고요.
STEP 4셀프 어텐션 — 문장이 스스로를 바라본다, 수식 한 줄로
번역에서는 번역문(Q)이 원문(K·V)을 바라봤습니다. 그런데 이 장치를 한 문장 안에서 돌리면 어떻게 될까요? 문장의 모든 단어가 Query가 되어 같은 문장의 모든 단어(Key·Value)를 바라보는 것 — 이것이 셀프 어텐션(self-attention)입니다. 도입의 그 문장에서 "그것"이 Query를 던지면, "동물"의 Key와 유사도가 가장 높게 나와 0.8쯤의 가중치가 실리고, "그것"의 표현에는 동물의 정보가 섞여 들어갑니다. 대명사가 지시 대상을 찾는 과정이, 검색 한 번으로 끝난 거예요.
이 전부를 담은 수식이 Transformer 논문의 그 유명한 한 줄입니다.
Attention(Q, K, V) = softmax( QKᵀ / √dk ) V
QKᵀ — 모든 단어 쌍의 유사도(내적)를 한 번에 · softmax — 합이 1인 가중치로 · V — 가중치만큼 내용물을 섞는다
√dk — 벡터가 길수록 내적 값이 커져 softmax가 한쪽으로 쏠리니, 미리 나눠서 완화하는 안전장치
수식에서 하나 덧붙이면, 저 √dk가 왜 붙어 있는지는 실험실에 스케일링 켬/끔 토글을 넣고 비교해 보고서야 체감했습니다. 나눗셈을 빼는 순간 가중치가 눈에 띄게 한쪽으로 쏠리거든요 — 그리고 벡터 차원이 클수록 내적 값 자체가 커지니, 실제 모델 크기에서는 이 쏠림이 softmax가 한 단어에 몰빵하는 수준까지 갑니다. 논문이 "안전장치"라고 한 줄로 지나가는 항이 실제로 무엇을 막고 있는지, 히트맵 두 장을 나란히 놓고 보면 선명해집니다.
STEP 5"Attention Is All You Need" — 그리고 LLM의 시대
시선 하나로는 부족합니다. "그것"은 지시 관계를 봐야 하지만, 동시에 어떤 단어는 문법 관계를, 어떤 단어는 의미상 짝을 봐야 하죠. 그래서 Transformer는 Q·K·V 행렬 세트를 여러 벌 두고 여러 시선으로 동시에 어텐션을 돌립니다 — 멀티헤드 어텐션(multi-head attention)입니다. 헤드마다 다른 관계를 전담하는 전문가 위원회인 셈이에요.
그리고 2017년, 구글 연구진 여덟 명이 도발적인 제목의 논문을 냅니다 — "Attention Is All You Need". 당시 언어 모델의 표준이던 순환 구조(RNN)를 통째로 들어내고, 셀프 어텐션만으로 모델을 만든 거예요. 이것이 Transformer입니다. 순환이 사라지자 단어를 하나씩 순서대로 처리할 필요가 없어졌고, 문장 전체를 한꺼번에 병렬 처리할 수 있게 됐습니다. 병렬화가 되니 모델과 데이터를 어마어마하게 키울 수 있었고 — 그 확장의 끝에 GPT, 그러니까 ChatGPT가 있습니다. 10편에서 봤던 그 구조의 심장이 바로 오늘 해부한 어텐션이에요.
🔗 시즌 2 세 편이 하나로 — 11편의 역전파는 배우는 방법, 12편의 CNN은 보는 구조, 오늘의 어텐션은 읽는 구조입니다. 그리고 셋은 한 몸이에요. 어텐션의 Q·K·V 행렬도, CNN의 필터도, 전부 같은 역전파가 데이터에서 학습합니다. 구조는 달라져도 배우는 방법은 언제나 하나 — 시즌 2의 관통선입니다.
✅ 30초 복습 — 오늘 배운 것
- ✔고정 벡터 하나에 문장을 압축하면 병목 — 긴 문장에서 정보가 뭉개진다.
- ✔어텐션(2014) — 매 단어마다 원문 전체를 다시 보고, 관련도 가중치로 맞춤 요약을 새로 만든다.
- ✔Q·K·V — 찾는 것(Q)과 색인(K)의 유사도로 가중치를 만들어 내용물(V)을 섞는 "부드러운 검색". 미분 가능해서 역전파로 배운다.
- ✔셀프 어텐션 — 문장이 스스로를 본다. "그것"이 "동물"을 찾는다. 수식은 softmax(QKᵀ/√dk)V 한 줄.
- ✔Transformer(2017) — RNN을 버리고 어텐션만으로. 병렬화 → 초거대화 → ChatGPT.
- 🧪위 다섯 가지는 전부 LLM 실험실에서 브라우저 실제 계산으로 재현된다 — 글로 이해했다면, 손으로 확인할 차례. (링크는 아래에)
어텐션, 읽었다면 이제 직접 돌려볼 차례
넘스탯(NumStats) Self-Attention 실험실에서는 문장을 넣고 쿼리 단어를 골라 어텐션 히트맵을 관찰하고,
√dk 스케일링 효과와 softmax(QKᵀ/√dk)V 4단계 계산을 직접 체험할 수 있습니다.
🧪 어텐션 히트맵 직접 그려보기 → LLM 이론 학습 둘러보기 →
numlm.com/llm-lab/attention · numlm.com/theory_large_language_model
한 발 더 들어가고 싶다면
시즌 2는 학습 엔진 위에 구조를 하나씩 얹어 갑니다.
- 14편 — RAG 완벽 가이드: ChatGPT는 왜 검색을 할까? 어텐션이 문장 안의 검색이었다면, RAG는 세상 밖 지식의 검색입니다
- 복습: 10편(Transformer 직관) → 오늘 글 → 11편(역전파)을 이어 읽으면 "구조와 학습"의 그림이 완성됩니다
참고 자료
본문은 다음 표준 자료를 기준으로 작성했습니다.
- Sutskever, Vinyals & Le (2014) — "Sequence to Sequence Learning with Neural Networks", NeurIPS 2014. 고정 벡터 기반 Seq2Seq — 어텐션이 고치게 되는 출발점 · 원문(arXiv)
- Bahdanau, Cho & Bengio (2015) — "Neural Machine Translation by Jointly Learning to Align and Translate", ICLR 2015. 어텐션 메커니즘의 원전 — 정렬을 학습으로 · 원문(arXiv)
- Vaswani 외 (2017) — "Attention Is All You Need", NeurIPS 2017. Transformer — Scaled Dot-Product·멀티헤드 어텐션의 원전 · 원문(arXiv)
- Uszkoreit (2017) — "Transformer: A Novel Neural Network Architecture for Language Understanding", Google Research Blog (2017-08-31). 논문 공저자의 공식 소개 글 — "그 동물은 길을 건너지 않았다" 대명사 예문의 출처 · 원문(Google Research)
- Zhang 외 (2023) — 『Dive into Deep Learning』. 11장 어텐션 메커니즘과 Transformer — Q·K·V·스케일링을 대화형 그림과 코드로 설명 · d2l.ai
마무리 — 집중을 배우는 기계
오늘 내용을 한 줄로 요약하면 이거예요. "어텐션은 '지금 무엇을 참고할지'를 Q·K·V 검색으로 계산하는 장치이고, 어디에 집중할지조차 사람이 아니라 역전파가 가르친다." 요약본 하나에 만족하지 않고 매번 원문을 다시 보는 것 — 그 성실한 되돌아봄이 기계에게 문맥을 읽는 힘을 주었습니다.
이제 기계는 배우는 법(11편), 보는 법(12편), 읽는 법(오늘)을 갖췄습니다. 다음 편에서는 이 기계가 자기가 모르는 것을 밖에서 찾아오는 법 — ChatGPT가 검색과 결합하는 RAG를 해부합니다.
그 선택적인 시선이 ChatGPT의 심장이 되었습니다.
다음 편에서 만나요.
넘스탯(NumStats) — 확률부터 LLM까지, 원리부터 제대로 배우는 자기주도 학습 플랫폼
#어텐션 #트랜스포머 #LLM #ChatGPT원리 #딥러닝 #셀프어텐션 #AI공부
※ 이 글은 LLM 도구를 활용해 초안을 작성한 뒤, 학술 출처와 수치 정확성은 발행 전 직접 검증·편집했습니다. 본문에 사실과 다른 부분을 발견하시면 댓글로 알려주시면 즉시 반영하겠습니다.