시즌 2 — AI를 만드는 손
AI는 어떻게 사진 속 고양이를 알아볼까? — CNN을 그림으로 뜯어보기
컴퓨터에게 사진은 그저 숫자의 격자입니다. 그 숫자 더미에서 고양이를 찾아내는 기계 — 합성곱 신경망(CNN)의 설계를 돋보기 하나로 풀어봅니다.
딥러닝 입문·CNN · 이미지 인식·10분 읽기
🧪 이 글의 모든 차트는 정지 화면입니다. 합성곱·풀링 연산부터 CNN 실제 학습까지, 넘스탯 딥러닝 실험실에서 슬라이더로 직접 조작하며 확인할 수 있어요. (링크는 글 끝에 모아 두었습니다)
⚡ 3분 요약
- 컴퓨터에게 사진은 픽셀 밝기 숫자의 격자일 뿐입니다. 일반 신경망(MLP)으로 풀면 가중치가 수십억 개로 폭발하고, 고양이가 한 칸만 옆으로 이동해도 처음 보는 입력이 돼요.
- 합성곱(Convolution)은 작은 필터(돋보기) 하나가 사진 전체를 훑고 다니며 같은 특징(모서리·질감)을 어디서든 찾아내는 연산 — 가중치를 공유하니 수가 급감하고, 위치가 바뀌어도 알아봅니다.
- 풀링(Pooling)은 특징 지도를 요약해 줄이는 단계 — "이 근처에 모서리가 있었다"만 남겨 위치 변화에 더 둔감해집니다.
- 합성곱·풀링 층을 쌓으면 "선 → 모서리 → 눈·귀 → 고양이 얼굴"처럼 특징이 점점 추상화됩니다. 1998년 LeNet이 원형을 만들었고, 2012년 AlexNet이 ImageNet 대회를 압도하며 딥러닝 시대를 열었어요.
- 가장 중요한 반전 — 필터를 사람이 설계하지 않습니다. 11편의 역전파가 "고양이를 잘 맞히는 필터"를 데이터에서 스스로 찾아냅니다.
👉 한 문장으로 — CNN은 "작은 돋보기들을 층층이 겹쳐, 픽셀에서 개념까지 올라가는 사다리"이고, 그 돋보기의 내용물은 역전파가 스스로 배웁니다.
지난 11편에서 우리는 신경망 학습의 엔진 — 역전파를 손에 넣었습니다. 순전파 → 손실 → 역전파 → 가중치 수정, 이 네 박자면 어떤 신경망이든 데이터에서 배울 수 있다고 했죠. 그럼 이제 이 엔진으로 진짜 문제를 하나 풀어봅시다. 사진 속 고양이 알아보기.
사람에게는 0.1초짜리 문제입니다. 세 살 아이도 하죠. 그런데 컴퓨터에게 이건 오랫동안 "불가능에 가까운 문제"였습니다. 왜일까요? 컴퓨터가 보는 사진이 우리가 보는 사진과 전혀 다르기 때문입니다.
숫자 300만 개를 봤을 뿐이다."
— 이미지 인식이 어려운 단 하나의 이유
이 숫자 더미에서 고양이를 찾아내려면, 신경망의 구조 자체를 사진이라는 데이터에 맞게 다시 설계해야 합니다. 그 설계가 바로 합성곱 신경망(CNN, Convolutional Neural Network)이에요. 문제의 정체부터 봅시다.
STEP 1컴퓨터의 눈 — 사진은 숫자의 격자다
디지털 사진은 픽셀(pixel)이라는 점들의 격자이고, 각 픽셀은 밝기를 나타내는 숫자입니다(컬러라면 빨강·초록·파랑 세 숫자). 1,000×1,000 컬러 사진 한 장이면 숫자가 300만 개예요. 컴퓨터 입장에서 "고양이 사진"과 "식빵 사진"의 차이는, 이 300만 개 숫자의 배열 차이일 뿐입니다.
11편에서 배운 다층 신경망(MLP)으로 정면 돌파하면 어떻게 될까요? 두 가지 벽에 부딪힙니다.
- 가중치 폭발 — 입력 300만 개를 첫 은닉층 뉴런 1,000개와 전부 연결하면 그것만으로 가중치가 30억 개. 첫 층에서 이미 감당이 안 됩니다.
- 위치에 취약 — MLP에게 픽셀 하나하나는 독립된 입력입니다. 고양이가 사진 왼쪽에서 오른쪽으로 한 뼘만 이동해도 완전히 다른 입력이 되어, 위치마다 고양이를 처음부터 다시 배워야 해요.
💡 문제를 다시 쓰면 — "고양이를 알아보라"는 "300만 개 숫자 격자에서, 위치가 어디든 반복해서 나타나는 밝기 경계·질감·형태의 패턴을 찾아라"가 됩니다. 이렇게 쓰고 나면 필요한 도구가 보여요. 같은 패턴을 모든 위치에서 찾아주는 장치 — 그게 다음 단계의 합성곱입니다.
STEP 2합성곱 — 돋보기 하나로 사진 전체를 훑는다
아이디어는 뜻밖에도 고양이의 뇌에서 나왔습니다. 1959년 신경생리학자 데이비드 허블과 토르스텐 비셀이 고양이의 시각 피질에 전극을 꽂고 발견한 사실 — 시각 뉴런 하나하나는 화면 전체가 아니라 자기 담당의 좁은 영역만 보고, 그 영역에 특정 방향의 선분이 나타날 때만 반응한다는 것이었죠(1981년 노벨 생리의학상). 고양이를 알아보는 기계의 설계도가, 고양이 뇌 실험에서 나온 셈입니다.
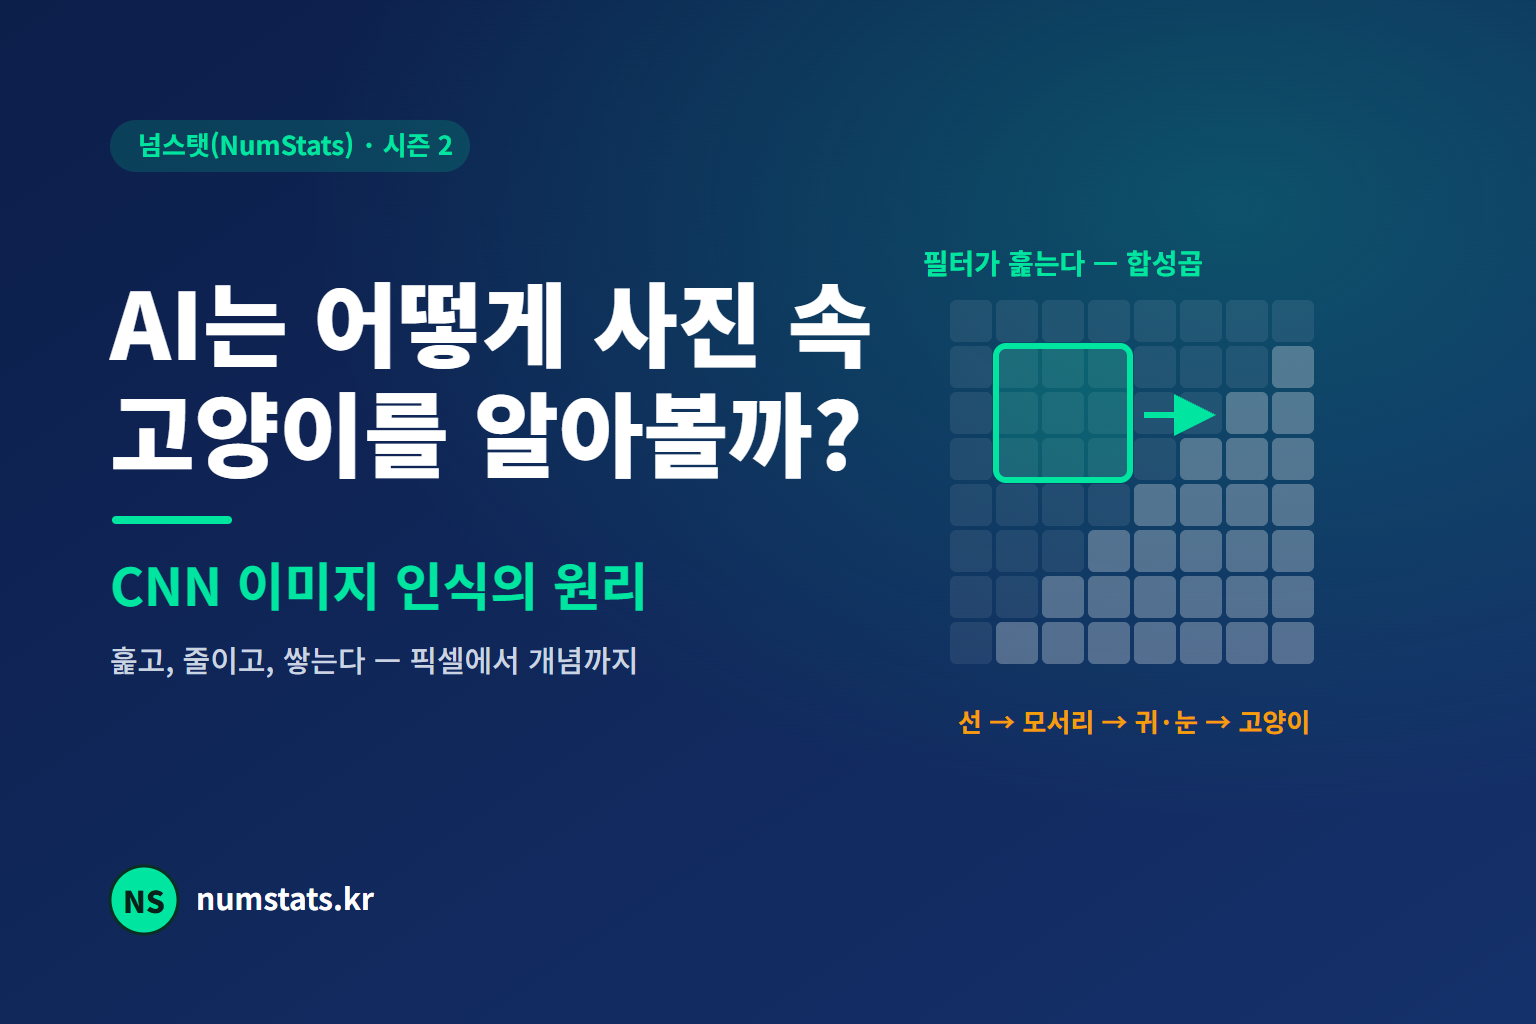
이 구조를 수학으로 옮긴 것이 합성곱(convolution)입니다. 3×3 정도의 작은 숫자판 — 필터(filter) 혹은 커널이라 부릅니다 — 를 사진 위에 올려놓고, 겹친 픽셀과 필터 값을 곱해서 전부 더합니다(어디서 본 가중합이죠? 맞아요, 11편의 뉴런 계산입니다). 그리고 필터를 한 칸 옆으로 밀어 같은 계산을 반복하며 사진 전체를 훑습니다. 그 결과로 "이 위치에 필터가 찾는 패턴이 얼마나 있나"를 담은 새 격자, 특징 지도(feature map)가 만들어져요.
이 단순한 설계가 STEP 1의 두 벽을 동시에 무너뜨립니다. 첫째, 가중치 공유 — 사진 전체를 검사하는 데 필터 하나, 즉 가중치 9개면 충분하니 30억 개가 필요 없습니다. 둘째, 위치 불변성 — 같은 필터가 모든 위치를 훑으니, 고양이 귀가 왼쪽에 있든 오른쪽에 있든 같은 필터가 같은 반응을 합니다. 위치마다 다시 배울 필요가 없어요.
고백하자면, 이 합성곱을 실험실 페이지로 만들면서 저도 한참 헤맸습니다. Stride(필터가 한 번에 미는 칸 수)와 Padding(가장자리 채우기) 값을 바꿀 때마다 출력 격자 크기가 어긋나서, 출력 크기 공식을 몇 번이고 다시 계산했거든요. 그 시행착오 끝에 확실해진 게 하나 있습니다 — 공식을 외우는 것보다 필터가 미끄러지는 모습을 눈으로 한 번 보는 쪽이 훨씬 빠릅니다. 슬라이더를 움직여 보면 "아, 그래서 출력이 작아지는구나"가 계산 없이 몸에 들어와요.
STEP 3풀링 — 요약해서 줄이고, 흔들림에 둔감해진다
합성곱이 만든 특징 지도는 아직 사진만큼 큽니다. 그리고 너무 정밀해요 — "모서리가 정확히 (137, 254) 픽셀에 있다"는 정보는 고양이인지 판단하는 데 과합니다. "이 근처에 모서리가 있다" 정도면 충분하죠. 그래서 특징 지도를 구역으로 나눠 구역마다 대표값 하나만 남기고 줄입니다. 이것이 풀링(pooling)이에요. 가장 흔한 방식은 구역에서 가장 큰 값(가장 강한 반응)만 남기는 최대 풀링(max pooling)입니다.
풀링의 효과는 두 가지입니다. 계산량이 준다(격자가 1/4로) — 그리고 더 중요하게, 위치의 잔떨림에 둔감해집니다. 특징이 한두 픽셀 흔들려도 "구역의 최댓값"은 그대로니까요. 고양이가 살짝 움직인 사진도 같은 고양이로 보이는 이유입니다.
STEP 4층층이 쌓기 — 선에서 고양이까지 올라가는 사다리
이제 부품이 다 모였습니다. 합성곱 → 풀링 → 합성곱 → 풀링… 을 층층이 쌓으면 무슨 일이 일어날까요? 11편의 💡박스에서 예고한 그 장면입니다. 첫 층의 필터들은 선과 모서리 같은 단순한 패턴을 찾습니다. 다음 층의 필터는 그 결과를 재료로 모서리들의 조합 — 곡선, 귀 모양, 눈동자를 찾고, 그다음 층은 그것들을 조합해 얼굴 형태를 찾습니다. 마지막에 일반 신경망(완전연결층)이 이 고수준 특징을 보고 "고양이 97%"라는 확률을 출력하죠.
이 설계의 역사에는 이정표가 둘 있습니다. 1998년 얀 르쿤 팀의 LeNet은 이 구조로 우편번호와 수표의 손글씨 숫자를 읽어내며 CNN의 원형을 완성했어요. 그리고 2012년, 제프리 힌턴 팀(11편 역전파의 그 힌턴입니다)의 AlexNet이 이미지 인식 대회 ImageNet에서 오답률을 26%대에서 15%대로 한 번에 끌어내리며 우승합니다. 2등과의 압도적인 격차에 컴퓨터 비전 연구계 전체가 방향을 틀었고 — 우리가 아는 딥러닝 시대가 여기서 시작됐습니다.
STEP 5반전 — 그 필터들, 사람이 만든 게 아니다
여기까지 읽고 이런 의문이 들었다면 정확합니다. "세로 모서리 필터, 귀 모양 필터… 그 수천 개 필터를 대체 누가 설계하지?" CNN 이전의 컴퓨터 비전은 실제로 전문가가 특징 추출기를 손으로 설계했습니다. 그리고 그것이 한계였어요. 고양이의 "고양이다움"을 규칙으로 다 적을 수는 없으니까요.
CNN의 진짜 반전은 이것입니다 — 필터 속 숫자들은 전부 학습되는 가중치입니다. 처음엔 무작위 잡음으로 시작해서, 사진을 넣고 → "고양이" 확률을 뽑고 → 정답과 비교해 손실을 재고 → 11편의 역전파가 필터 값 하나하나의 책임을 계산해 수정합니다. 이 네 박자를 수백만 장의 사진으로 반복하면, 첫 층에서 모서리 감지기가 저절로 나타납니다. 허블과 비셀이 고양이 뇌에서 본 그 구조를, 신경망이 데이터만 보고 스스로 재발명하는 거예요.
이미지 분류 실험실을 만들며 브라우저에서 작은 CNN을 직접 학습시켜 봤을 때, 이 글을 준비하면서 가장 신기했던 순간이 왔습니다. 학습 전의 필터는 정말 무작위 잡음이었는데, 학습이 몇 바퀴 돌자 첫 층 필터 몇 개가 밝기 경계에 반응하는 모서리 감지기 모양으로 정돈되기 시작하더군요. 교과서에서 "저절로 나타난다"는 문장을 읽는 것과, 그게 내 화면에서 실제로 일어나는 걸 보는 건 전혀 다른 경험이었습니다.
🔗 시즌 2가 연결되는 순간 — 11편에서 배운 학습 루프(순전파 → 손실 → 역전파 → 수정)는 엔진이고, 오늘 본 CNN은 그 엔진을 얹은 첫 번째 전문 차체입니다. 앞으로 만날 Attention·Transformer도 마찬가지예요. 구조는 달라져도, 배우는 방법은 언제나 역전파 하나입니다.
✅ 30초 복습 — 오늘 배운 것
- ✔컴퓨터에게 사진은 숫자 격자 — MLP로는 가중치 폭발 + 위치 이동에 취약.
- ✔합성곱 — 작은 필터가 전체를 훑는다. 가중치 공유로 수가 급감, 위치가 바뀌어도 같은 반응.
- ✔풀링 — 구역별 대표값만 남겨 줄인다. 위치의 잔떨림에 둔감해진다.
- ✔층을 쌓으면 선 → 부품 → 개체로 특징이 추상화 — LeNet(1998)이 원형, AlexNet(2012)이 시대를 열었다.
- ✔필터는 사람이 아니라 역전파가 데이터에서 학습한다 — 모서리 감지기가 저절로 나타난다.
- 🧪위 다섯 가지는 전부 딥러닝 실험실에서 브라우저 실제 계산으로 재현된다 — 글로 이해했다면, 손으로 확인할 차례. (링크는 아래에)
노래로 복습하기 · 넘스탯 딥러닝 노래 시리즈
EP05. 필터의 눈 — Eye of the Filter
오늘 배운 합성곱 필터를, 노래 한 곡으로 마음에 다시 새겨보세요.
넘스탯 딥러닝 노래 시리즈 전체 재생목록 ▶CNN, 읽었다면 이제 직접 돌려볼 차례
넘스탯(NumStats) CNN 실험실에서는 Convolution·Stride·Padding·Pooling을 슬라이더로 조작하고,
이미지 분류 실험실에서는 CNN을 브라우저에서 실제로 학습시켜 필터·특징 맵·확률을 들여다볼 수 있습니다.
🧪 합성곱 필터 직접 밀어보기 → CNN 실제로 학습시켜 보기 →
numlm.com/dl-lab/cnn · numlm.com/dl-lab/image-classification
한 발 더 들어가고 싶다면
시즌 2는 학습 엔진 위에 구조를 하나씩 얹어 갑니다.
- 13편 — Attention 메커니즘 완벽 이해: 눈(CNN) 다음은 언어입니다. AI가 문장의 어떤 단어에 집중하는지, Q·K·V의 수학까지
- 복습: 11편(신경망·역전파)을 먼저 읽으면 오늘의 "필터도 결국 학습되는 가중치"가 완전히 연결됩니다
참고 자료
본문은 다음 표준 자료를 기준으로 작성했습니다.
- Hubel & Wiesel (1962) — "Receptive fields, binocular interaction and functional architecture in the cat's visual cortex", The Journal of Physiology 160(1). 시각 피질의 국소 수용장·방향 선택성 발견 (1981 노벨 생리의학상) · 원문(DOI)
- LeCun, Bottou, Bengio & Haffner (1998) — "Gradient-based learning applied to document recognition", Proceedings of the IEEE 86(11). LeNet — CNN 원형의 완성 · 원문(DOI)
- Krizhevsky, Sutskever & Hinton (2012) — "ImageNet Classification with Deep Convolutional Neural Networks", NeurIPS 2012. AlexNet — ImageNet 대회 압승으로 딥러닝 시대 개막 · 원문(NeurIPS)
- Goodfellow, Bengio & Courville (2016) — 『Deep Learning』 (MIT Press). 9장 합성곱 신경망 — 가중치 공유·등변성의 표준 교과서 설명 · 공식 웹판
- Zhang 외 (2023) — 『Dive into Deep Learning』. 합성곱·풀링·LeNet·AlexNet을 대화형 그림과 코드로 설명 · d2l.ai
마무리 — 눈을 얻은 기계
오늘 내용을 한 줄로 요약하면 이거예요. "CNN은 작은 필터로 전체를 훑고(합성곱), 요약해 줄이고(풀링), 층층이 쌓아 픽셀에서 개념까지 올라가는 구조 — 그리고 그 필터들은 역전파가 데이터에서 스스로 배운다." 사람이 고양이의 정의를 적어주는 대신, 기계가 수백만 장의 사진에서 고양이다움을 스스로 발견하게 만든 것. 이것이 2012년 이후 세상이 바뀐 방식입니다.
기계가 눈을 얻었으니, 다음은 말입니다. 다음 편에서는 AI가 문장을 읽을 때 어떤 단어에 왜 더 집중하는지 — ChatGPT의 심장인 Attention 메커니즘을 Q·K·V의 수학까지 해부합니다.
그 단순한 반복이 기계에게 눈을 주었습니다.
다음 편에서 만나요.
넘스탯(NumStats) — 확률부터 LLM까지, 원리부터 제대로 배우는 자기주도 학습 플랫폼
#CNN #합성곱신경망 #딥러닝 #이미지인식 #컴퓨터비전 #AlexNet #딥러닝공부
※ 이 글은 LLM 도구를 활용해 초안을 작성한 뒤, 학술 출처와 수치 정확성은 발행 전 직접 검증·편집했습니다. 본문에 사실과 다른 부분을 발견하시면 댓글로 알려주시면 즉시 반영하겠습니다.