시즌 2 개막 — AI를 만드는 손
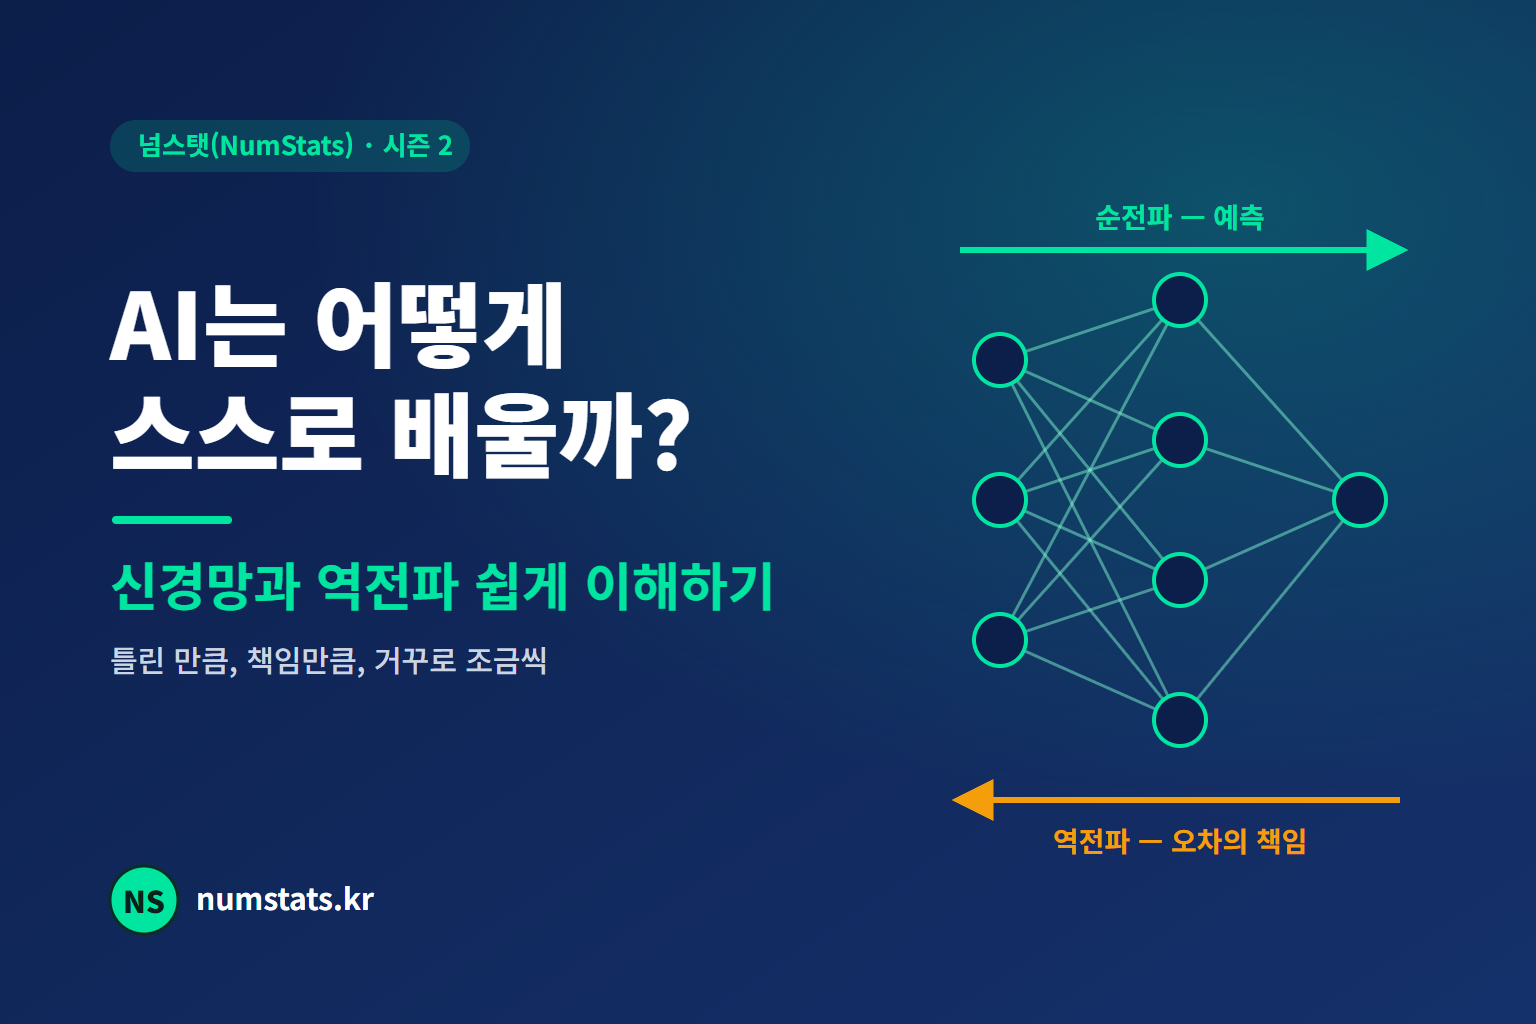
AI는 어떻게 스스로 배울까? — 신경망과 역전파를 그림으로 뜯어보기
정답을 알려주는 선생님 없이, AI는 틀린 만큼 스스로를 고칩니다. 뉴런 하나의 덧셈부터 AI의 겨울을 끝낸 역전파(Backpropagation)까지 — 학습의 엔진을 열어봅니다.
딥러닝 입문·신경망 · 역전파·10분 읽기
🧪 이 글의 모든 차트는 정지 화면입니다. 뉴런 계산·XOR·경사하강법·역전파 전부, 넘스탯 딥러닝 실험실에서 슬라이더로 직접 조작하며 확인할 수 있어요. (링크는 글 끝에 모아 두었습니다)
⚡ 3분 요약
- 신경망의 기본 부품은 뉴런 하나 — 입력에 가중치를 곱해 더하고(가중합), 활성화 함수로 신호를 내보냅니다. 8편의 로지스틱 회귀와 같은 골격이에요.
- 뉴런 한 층으로는 XOR 같은 간단한 문제도 못 풉니다(1969년 증명). 층을 쌓은 다층 신경망이 되어야 복잡한 패턴을 배울 수 있어요.
- 학습이란 손실(얼마나 틀렸나)을 줄이는 방향으로 가중치를 조금씩 고치는 일 — 안개 낀 산에서 발밑 경사만 보고 내려가는 경사하강법입니다.
- 역전파(1986)는 출력의 오차를 거꾸로 흘려보내며 수백만 개 가중치 각각의 "책임"을 한 번에 계산하는 알고리즘이에요.
- 순전파 → 손실 계산 → 역전파 → 가중치 수정. 이 네 박자의 무한 반복이 ChatGPT까지 포함한 모든 딥러닝 학습의 정체입니다.
👉 한 문장으로 — AI의 학습은 "틀린 만큼, 틀리게 만든 책임의 크기만큼, 모든 손잡이를 거꾸로 조금씩 돌리는 일"의 반복이에요.
시즌 1의 9편에서 ChatGPT가 만들어지는 8단계를 따라가며 이렇게 말했어요. "모델은 정답과의 차이를 보고 내부의 숫자를 조금씩 고친다." 10편에서는 그 모델의 뼈대가 Transformer라는 것도 봤죠. 그런데 정작 "조금씩 고친다"가 실제로 어떻게 일어나는지는 상자 속에 남겨뒀습니다. 시즌 2의 첫 글에서 그 상자를 엽니다.
생각해 보면 이상한 일이에요. ChatGPT의 내부에는 수천억 개의 숫자(가중치)가 있는데, 어느 숫자를 얼마나 고쳐야 하는지 알려주는 사람이 아무도 없습니다. 그런데도 모델은 배웁니다. 어떻게?
누가, 얼마나 틀리게 만들었는지를 알아야 고칠 수 있다."
— 신경망 학습을 관통하는 단 하나의 질문
이 질문에 답한 것이 1986년의 역전파(Backpropagation) 알고리즘이고, 이것이 지금의 딥러닝 시대를 연 엔진입니다. 하지만 역전파를 이해하려면 먼저 신경망이라는 기계가 어떻게 생겼는지부터 봐야 해요. 부품 하나에서 시작합니다.
STEP 1부품 하나 — 뉴런은 "가중치를 곱해 더하는 기계"
신경망의 최소 부품은 인공 뉴런이에요. 1958년 심리학자 프랭크 로젠블랫이 퍼셉트론(Perceptron)이라는 이름으로 처음 기계로 구현했습니다. 하는 일은 놀랄 만큼 단순해요.
- 입력마다 가중치(weight)를 곱한다 — "이 입력을 얼마나 중요하게 볼까?"
- 전부 더한다(가중합) — 그리고 기본 성향을 나타내는 편향(bias)을 더한다
- 결과를 활성화 함수에 통과시켜 신호를 내보낸다 — "이 정도면 반응할까, 말까?"
어디서 본 모양이죠? 맞아요. 8편의 로지스틱 회귀가 정확히 이 뉴런 하나였습니다. 입력에 가중치를 곱해 더하고, Sigmoid라는 활성화 함수로 확률을 만들었죠. 그러니 여러분은 이미 뉴런 하나를 완전히 이해하고 있는 셈이에요. 중요한 건 이거예요 — 뉴런이 "배울 수 있는" 것은 가중치 w와 편향 b뿐입니다. 학습이란 결국 이 숫자들을 고치는 일이에요.
STEP 2층으로 쌓기 — 한 층으로는 XOR도 못 푼다
1958년 퍼셉트론이 공개되자 언론은 "스스로 생각하는 최초의 기계"라며 열광했어요. 그런데 1969년, MIT의 마빈 민스키와 시모어 페퍼트가 찬물을 끼얹습니다. 저서 『Perceptrons』에서 한 층짜리 퍼셉트론은 XOR — "둘 중 하나만 참일 때 참" 같은 초등학생도 아는 규칙 — 을 원리적으로 배울 수 없다고 증명한 거예요. 뉴런 하나는 세상을 직선 하나로만 가를 수 있는데, XOR은 직선 하나로는 갈라지지 않기 때문이죠.
이 증명의 여파로 신경망 연구는 오랜 침체기, 이른바 "AI의 겨울"에 들어갑니다. 해법 자체는 알려져 있었어요 — 뉴런을 층층이 쌓으면(다층 퍼셉트론, MLP) 직선 여러 개를 조합해 훨씬 복잡한 경계를 그릴 수 있습니다. 문제는 "쌓으면 풀린다는 건 알겠는데, 그 많은 가중치를 대체 어떻게 학습시키지?"였습니다. 중간에 낀 은닉층(hidden layer)의 뉴런들은 정답과 직접 비교할 수 없으니까요. 이 질문의 답이 나오기까지 십수 년이 걸립니다.
💡 층을 쌓으면 왜 강해질까? — 첫 층의 뉴런들이 각자 간단한 특징(직선 경계)을 감지하고, 다음 층은 그 특징들을 조합한 특징을 만들어요. 층이 깊어질수록 "선 → 모서리 → 눈·코 → 얼굴"처럼 점점 추상적인 개념이 만들어집니다. 이것이 딥(deep)러닝의 "깊다"의 의미예요.
STEP 3채점하기 — "얼마나 틀렸나"를 숫자 하나로: 손실 함수
이제 학습으로 넘어갑니다. 무언가를 고치려면 먼저 얼마나 틀렸는지 측정할 수 있어야겠죠. 신경망의 예측과 정답의 차이를 숫자 하나로 요약한 것이 손실(loss)이고, 그 계산 규칙이 손실 함수(loss function)예요. 손실이 크면 많이 틀렸다, 0에 가까우면 거의 맞혔다는 뜻입니다.
예를 들어 집값을 예측하는 모델이 5억이라고 답했는데 정답이 6억이면, 오차 1억을 제곱해 손실로 삼는 식이에요(평균제곱오차). ChatGPT 같은 언어 모델은 "다음 토큰의 확률"을 예측하니, 정답 토큰에 확률을 낮게 준 만큼 벌점을 주는 손실(교차 엔트로피)을 씁니다. 어느 쪽이든 핵심은 같아요 — 학습의 목표가 "손실이라는 단 하나의 숫자를 낮추는 것"으로 명확해진다는 점입니다.
가중치 조합을 찾는 일"
STEP 4내려가기 — 안개 낀 산과 경사하강법
가중치를 이렇게 저렇게 바꿀 때마다 손실이 오르내립니다. 가중치가 수백만 개라면, 손실은 수백만 차원 공간에 펼쳐진 거대한 산맥의 고도와 같아요. 우리의 목표는 이 산맥에서 가장 낮은 골짜기(손실 최소)를 찾는 것. 그런데 산맥 전체 지도는 아무도 갖고 있지 않습니다.
그래서 신경망은 안개 낀 산의 등산객처럼 움직입니다. 멀리는 안 보여도 발밑의 경사는 느낄 수 있죠. 매 걸음 "지금 위치에서 가장 가파른 내리막 방향"을 계산해 그쪽으로 한 걸음 내딛습니다. 이것이 경사하강법(gradient descent)이에요. 여기서 한 걸음의 보폭이 그 유명한 학습률(learning rate)입니다 — 너무 크면 골짜기를 건너뛰며 요동치고, 너무 작으면 하세월이죠.
고백 하나 하자면, 옵티마이저 실험실을 만들면서 학습률 슬라이더를 일부러 한껏 키워 본 적이 있습니다. 손실이 줄기는커녕 골짜기 양쪽 벽을 핑퐁처럼 튕겨 다니다가 그래프 밖으로 발산해 버리더군요. "보폭이 너무 크면 골짜기를 건너뛴다"는 문장을 열 번 읽는 것보다, 그 발산하는 그래프를 한 번 보는 게 훨씬 강렬했습니다. 반대로 학습률을 아주 작게 줄이면 수백 스텝이 지나도 제자리걸음이었고요 — 이 줄다리기가 학습률 튜닝의 전부입니다.
그런데 여기 마지막 관문이 남아 있어요. "가장 가파른 내리막 방향"을 알려면 가중치 하나하나가 손실에 얼마나 영향을 주는지를 전부 계산해야 합니다. 가중치가 수백만~수천억 개인데, 하나씩 바꿔보며 확인한다면 우주가 끝날 때까지 계산해도 모자라죠. 바로 이 계산을 단번에 해내는 것이 오늘의 주인공, 역전파입니다.
STEP 5역전파 — 오차의 책임을 거꾸로 나누어 갖기
1986년, 데이비드 러멜하트·제프리 힌턴·로널드 윌리엄스가 학술지 네이처(Nature)에 발표한 논문 "Learning representations by back-propagating errors"가 이 문제를 풀었습니다. 아이디어를 회사에 비유하면 이래요.
제품(출력)에 불량(오차)이 발생했습니다. 사장이 최종 조립팀(출력층)에 묻죠. "불량에 당신 팀 책임이 얼마나 되나?" 조립팀은 자기 책임을 계산한 뒤, 부품을 납품한 이전 팀(그 앞 층)에 자기가 받은 책임을 기여도만큼 나눠서 전달합니다. 그 팀은 또 그 앞 팀으로… 이렇게 오차의 책임이 출력에서 입력 방향으로, 즉 거꾸로(back) 전파(propagation)됩니다. 한 번의 역방향 전달이 끝나면 모든 가중치가 "내 책임이 이만큼"이라는 숫자(기울기)를 손에 쥐게 되고, 각자 그 크기에 비례해 반대 방향으로 자신을 수정합니다.
수학적으로는 미분의 연쇄 법칙(chain rule)을 층을 따라 체계적으로 적용한 것인데, 진짜 위력은 효율에 있어요. 가중치를 하나씩 건드려 보는 대신, 순전파 한 번 + 역전파 한 번이면 수천억 개 가중치의 책임이 전부 계산됩니다. 은닉층은 정답과 직접 비교할 수 없다던 1969년의 벽이, 이 "책임 나누기"로 무너진 거예요. 그리고 이것이 STEP 2에서 멈춰 있던 이야기의 결말이자, AI의 겨울이 끝나는 장면입니다.
이 회사 비유가 정말 맞는지, 기본 신경망 실험실을 만들 때 역전파를 한 스텝씩 버튼으로 돌려 보며 확인했습니다. 스텝 버튼을 누르면 가중치마다 기울기 숫자가 붙고, 다음 스텝에서 정확히 그 크기에 비례해 반대 방향으로 움직입니다. 출력에서 먼 가중치일수록 책임이 잘게 쪼개져 도착하는 것도 수치로 보이고요. 비유로 이해한 것과 숫자가 움직이는 걸 보는 건 확실히 다른 층위의 납득이었습니다.
🔗 시즌 1과 연결하면 — 9편에서 본 ChatGPT의 사전학습 "다음 토큰을 예측하고 틀린 만큼 고친다"의 "고친다"가 바로 이 ③역전파 + ④가중치 수정이에요. 10편의 Transformer 블록 안 수천억 개 가중치도 전부 이 루프로 배웁니다. 상자 속 엔진이 이제 보이시죠?
✅ 30초 복습 — 오늘 배운 것
- ✔뉴런 = 가중합 + 활성화. 배우는 것은 가중치 w와 편향 b뿐이다.
- ✔한 층은 XOR도 못 푼다(1969) — 층을 쌓아야 복잡한 패턴을 배운다.
- ✔손실 함수가 "얼마나 틀렸나"를 숫자 하나로 만든다 — 학습 목표는 이 숫자 낮추기.
- ✔경사하강법 — 발밑 경사만 보고 한 걸음씩 내려간다. 보폭이 학습률.
- ✔역전파(1986) — 오차의 책임을 출력→입력 방향으로 나눠, 모든 가중치의 수정 방향을 한 번에 계산한다.
- 🧪위 다섯 가지는 전부 딥러닝 실험실에서 브라우저 실제 계산으로 재현된다 — 글로 이해했다면, 손으로 확인할 차례. (링크는 아래에)
노래로 복습하기 · 넘스탯 딥러닝 노래 시리즈
EP03. Backprop Heart — 역전파의 마음
오늘 배운 역전파를, 노래 한 곡으로 마음에 다시 새겨보세요.
넘스탯 딥러닝 노래 시리즈 전체 재생목록 ▶신경망, 읽었다면 이제 직접 돌려볼 차례
넘스탯(NumStats) 기본 신경망 실험실에서는 뉴런 하나의 계산부터 역전파 한 스텝의 실제 수치 변화,
퍼셉트론의 XOR 한계까지 — 오늘 읽은 모든 장면을 브라우저에서 직접 조작할 수 있습니다.
🧪 역전파 한 스텝 직접 돌려보기 → 딥러닝 이론 학습 둘러보기 →
numlm.com/dl-lab/neural-network-basics · numlm.com/theory_deep_learning
한 발 더 들어가고 싶다면
시즌 2는 이 학습 엔진 위에 하나씩 구조를 얹어 갑니다.
- 12편 — CNN 이미지 인식의 원리: 오늘 만든 신경망이 어떻게 사진 속 고양이를 알아보는지
- 13편 — Attention 메커니즘 완벽 이해: 10편의 직관을 한 단계 깊이, Q·K·V의 수학까지
- 복습: 8편(로지스틱 회귀 = 뉴런 하나), 9편(ChatGPT 학습 8단계)과 이어서 읽으면 그림이 완성됩니다
참고 자료
본문은 다음 표준 자료를 기준으로 작성했습니다.
- Rumelhart, Hinton & Williams (1986) — "Learning representations by back-propagating errors", Nature 323, 533–536. 역전파 알고리즘을 널리 알린 원전 · 원문(DOI)
- Rosenblatt (1958) — "The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain", Psychological Review 65(6). 퍼셉트론의 출발점 · 원문(DOI)
- Minsky & Papert (1969) — 『Perceptrons』 (MIT Press). 단층 퍼셉트론의 XOR 한계 증명
- Goodfellow, Bengio & Courville (2016) — 『Deep Learning』 (MIT Press). 6장 심층 순방향 신경망, 역전파의 표준 교과서 설명 · 공식 웹판
- Zhang 외 (2023) — 『Dive into Deep Learning』. 선형 신경망·다층 퍼셉트론·경사하강법·역전파를 대화형 그림과 코드로 설명 · d2l.ai
마무리 — 시즌 2를 열며
오늘 내용을 한 줄로 요약하면 이거예요. "AI의 학습이란, 틀린 만큼 — 그리고 틀리게 만든 책임의 크기만큼 — 모든 가중치를 반대 방향으로 조금씩 돌리는 일의 반복이다." 신비로워 보이던 "스스로 배우는 기계"의 실체는, 채점(손실)과 책임 배분(역전파)과 반성(가중치 수정)의 성실한 무한 반복이었습니다.
시즌 1이 "AI를 이해하는 눈"이었다면, 시즌 2는 "AI를 만드는 손"입니다. 학습 엔진을 손에 넣었으니, 다음 편에서는 이 엔진으로 굴러가는 첫 번째 전문 구조 — 사진 속 고양이를 알아보는 CNN을 만나러 갑니다.
그 성실한 반복이 ChatGPT를 만들었습니다.
다음 편에서 만나요.
넘스탯(NumStats) — 확률부터 LLM까지, 원리부터 제대로 배우는 자기주도 학습 플랫폼
#신경망 #역전파 #딥러닝 #경사하강법 #손실함수 #퍼셉트론 #AI공부
※ 이 글은 LLM 도구를 활용해 초안을 작성한 뒤, 학술 출처와 수치 정확성은 발행 전 직접 검증·편집했습니다. 본문에 사실과 다른 부분을 발견하시면 댓글로 알려주시면 즉시 반영하겠습니다.