ChatGPT는 어떻게 문장을 이해할까? Transformer 구조 쉽게 설명 | 넘스탯(NumStats) — Attention Is All You Need
모든 단어가 서로를 동시에 바라본다 — 단 하나의 아이디어 Attention으로 AI의 역사를 바꾼 Transformer(트랜스포머)의 속을 열어봅니다. (시즌 1 마지막 편)
LLM 입문·Attention · GPT·11분 읽기
⚡ 3분 요약
- Transformer는 현재 ChatGPT · Gemini · Claude 등 거의 모든 LLM의 뼈대가 되는 구조예요.
- 기존 RNN/LSTM은 문장을 순서대로 한 단어씩 읽어 긴 문장에선 앞부분을 잊기 쉬웠어요.
- Transformer는 모든 단어가 서로를 동시에 바라보는 Self-Attention 방식을 씁니다.
- Self-Attention은 Q(질문)·K(색인)·V(내용)로 단어 사이 관련도를 계산해요.
- 여러 관점을 한 번에 보기 위해 Multi-Head Attention으로 병렬 처리해요.
- 이 Transformer 블록을 여러 층 쌓고 다음 토큰 예측으로 학습한 결과가 GPT예요.
👉 한 문장으로 — Transformer는 "모든 단어가 서로를 동시에 참고해 문맥을 이해하는 구조"이고, 이것이 현대 LLM의 핵심이에요.
지난 9편에서 ChatGPT가 만들어지는 8단계를 풀면서, 사전학습·SFT·RLHF가 모두 어떤 "신경망" 위에서 벌어진다고 했어요. 그런데 그 신경망의 정체는 일부러 뭉뚱그렸죠. 오늘 그 상자를 엽니다. 안에 들어 있는 건 단 하나 — Transformer예요.
2017년, 구글 연구진이 발표한 논문 한 편의 제목은 도발적이었어요. "Attention Is All You Need(필요한 건 어텐션뿐)". 그전까지 문장을 처리하던 복잡한 장치들을 다 걷어내고, '어텐션'이라는 한 가지 메커니즘만으로 충분하다고 선언한 거예요. 이 논문이 GPT·BERT·ChatGPT로 이어지는 모든 현대 LLM의 출발점이 됩니다.
모든 단어가 모든 단어를 한 번에 바라보게 하자."
— Transformer를 관통하는 단 하나의 발상
이름은 거창하지만, 핵심은 위 한 문장이에요. 오늘은 그 발상이 왜 혁명이었는지, 그리고 어텐션이 실제로 어떻게 작동하는지를 수식 암기 없이 직관으로 따라가 봅니다. 먼저, 무엇이 문제였는지부터요.
Transformer 이전 — 한 글자씩 읽다 앞을 까먹는 문제
Transformer 이전의 모델(RNN·LSTM)은 사람처럼 문장을 왼쪽에서 오른쪽으로 한 단어씩 읽었어요. 직관적이지만 두 가지 큰 약점이 있었죠.
- 앞부분을 잊어버린다. 문장이 길어지면, 끝에 도달했을 때 맨 앞 단어의 기억이 흐려져요. "내가 어릴 적 살던 그 동네의 빵집은 …(긴 설명)… 지금도 거기 있을까?"에서 '거기'가 빵집임을 끝까지 붙잡기 어렵습니다.
- 느리다. 단어를 순서대로 하나씩 처리하니, 앞 단어가 끝나야 다음 단어를 볼 수 있어요. 수천 개의 GPU로 동시에 계산하고 싶어도 병렬 처리가 안 됐어요.
Transformer의 해법은 과감했어요. "순서대로 읽기를 아예 포기하자." 대신 문장의 모든 단어를 책상 위에 펼쳐 놓고, 각 단어가 다른 모든 단어를 동시에 훑어보게 했습니다. 거리가 아무리 멀어도 직접 연결되니 앞을 까먹지 않고, 한꺼번에 보니 병렬 처리도 가능해졌죠. 이 "동시에 훑어보기"가 바로 어텐션(Attention)입니다.
STEP 1 / 5단어를 좌표로 + 순서표 붙이기
9편에서 봤듯 모델은 글자를 못 읽어요. 그래서 먼저 문장을 잘게 자르고(토큰화), 각 토큰을 여러 숫자로 된 좌표(벡터)로 바꿉니다. 이게 임베딩(embedding)이에요. 비슷한 의미의 단어는 좌표 공간에서 서로 가깝게 자리 잡습니다. (원 논문에서는 한 단어를 512개의 숫자로 표현했어요.)
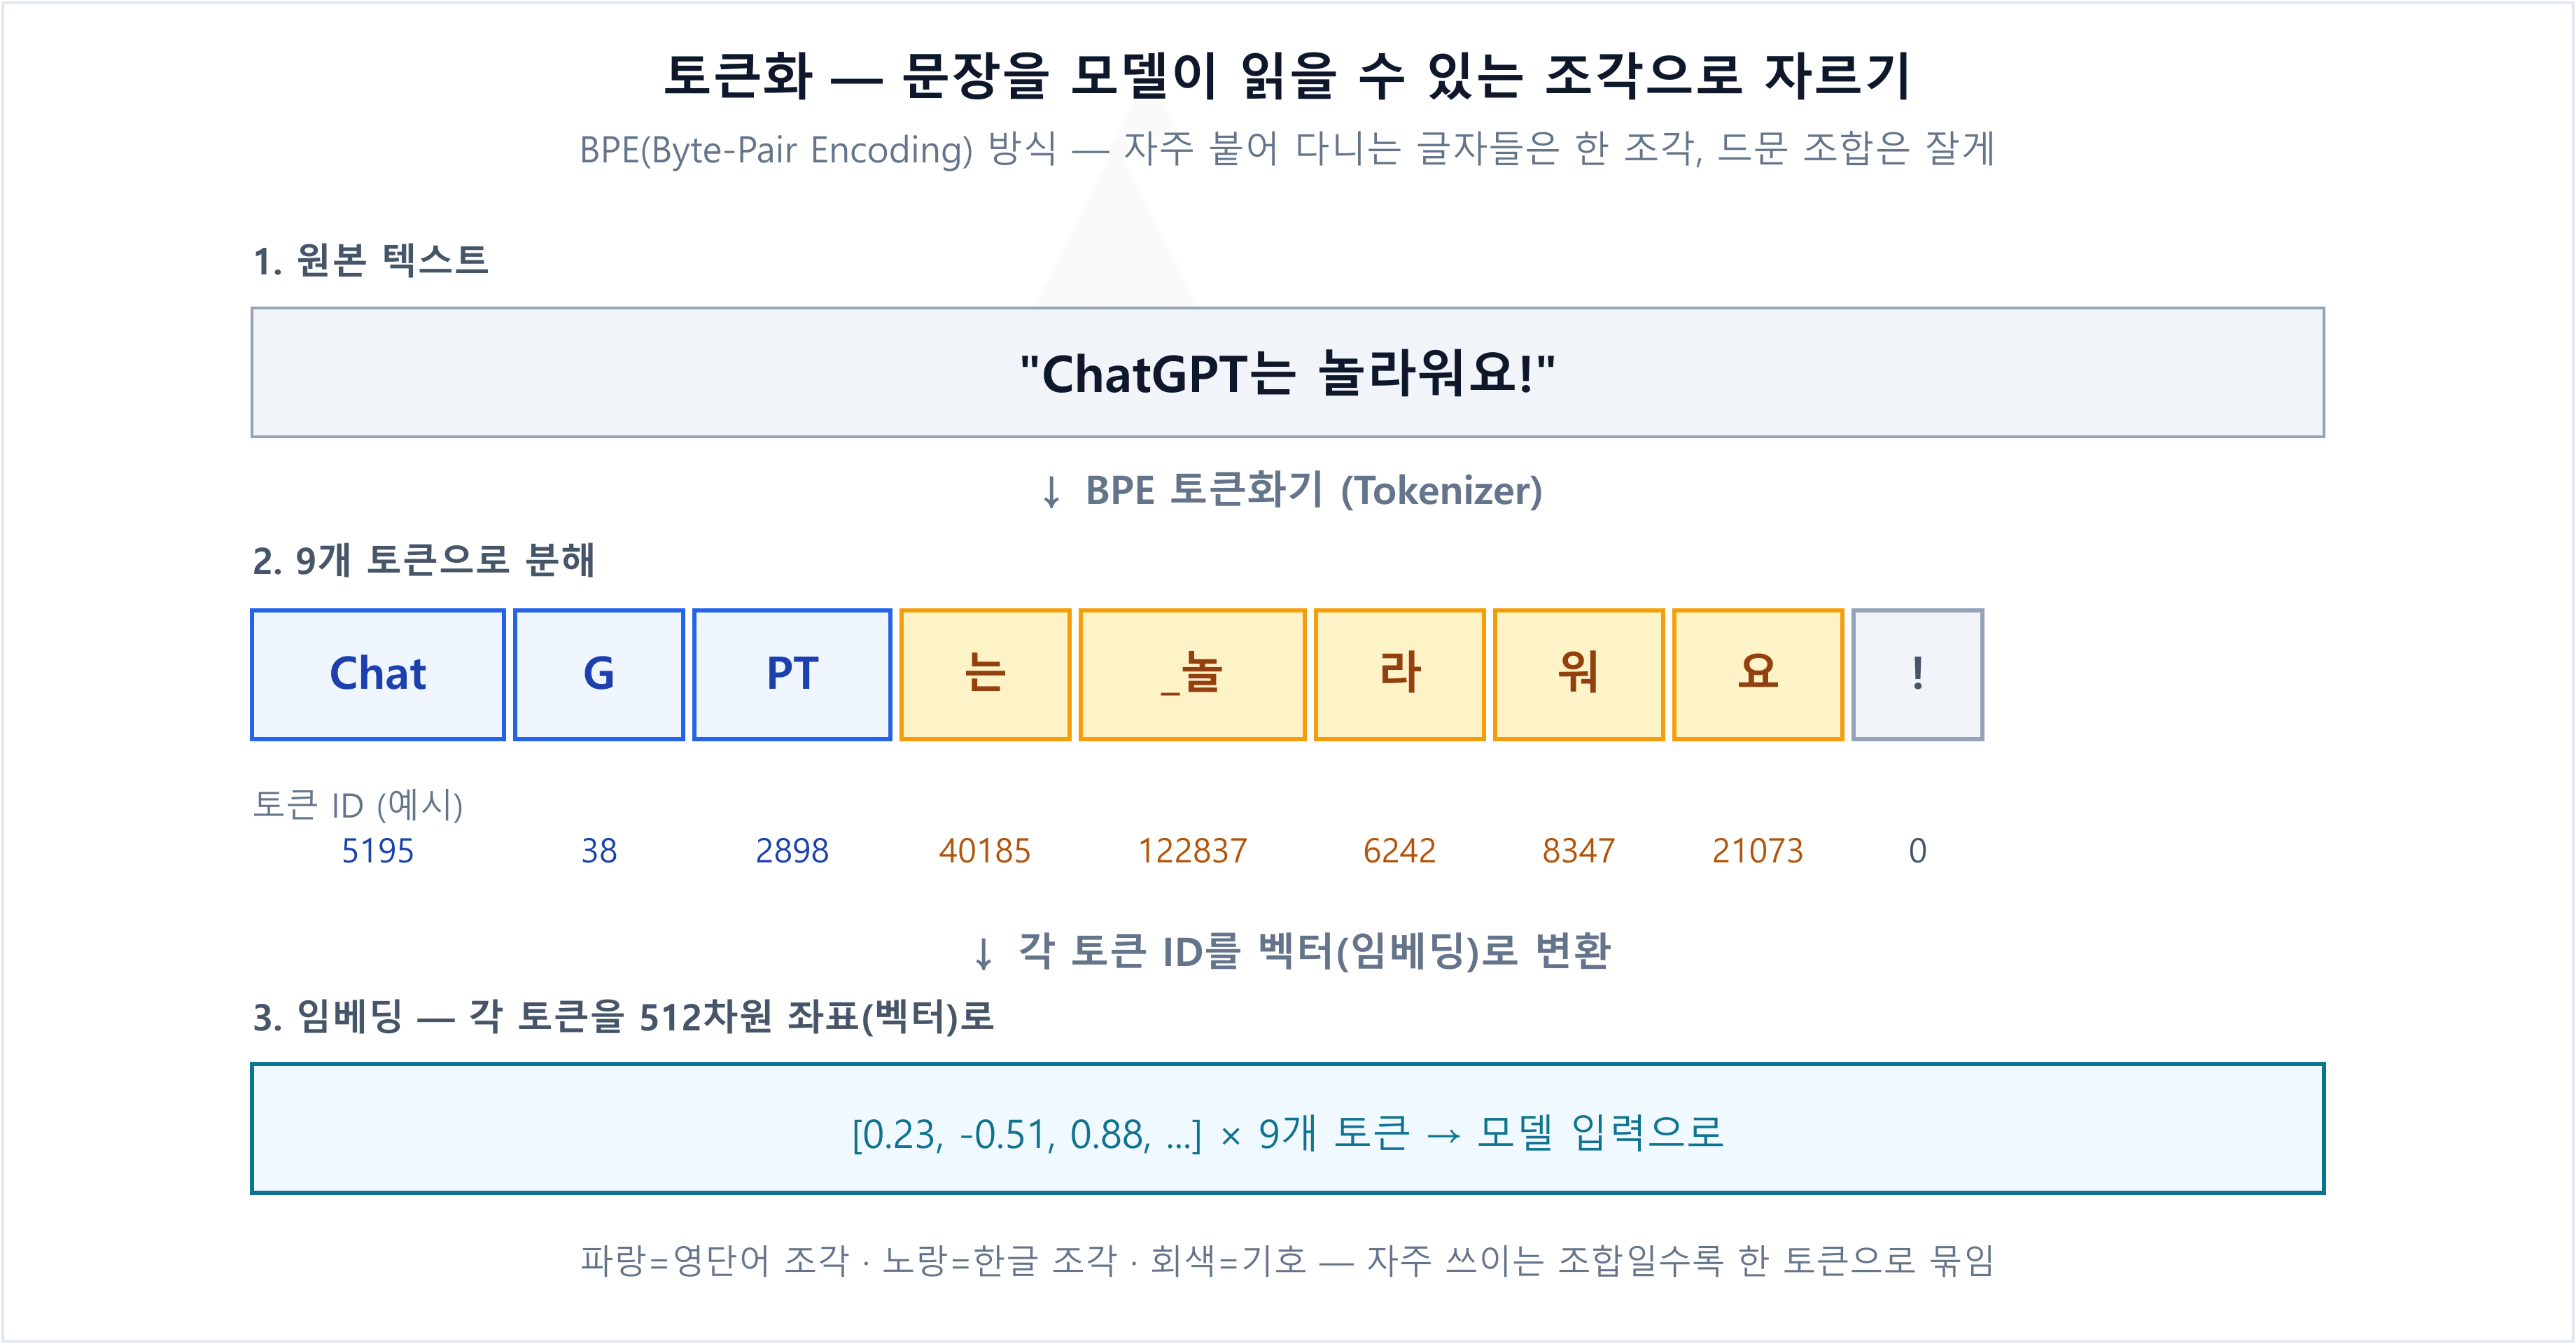
잠깐, 저 그림에 붙은 토큰 ID(5195, 38, 2898…)는 뭘까요? 사실 국어사전의 페이지 번호와 정확히 같은 개념이에요. 토큰화기에는 자기만의 사전(vocabulary)이 있고, 각 항목마다 고유 ID가 붙어 있습니다. "Chat"은 언제 어디서든 5195번, "는"은 40185번 — 사전이 안 바뀌는 한 영원히요. 사전 실물은 이렇게 생겼어요.
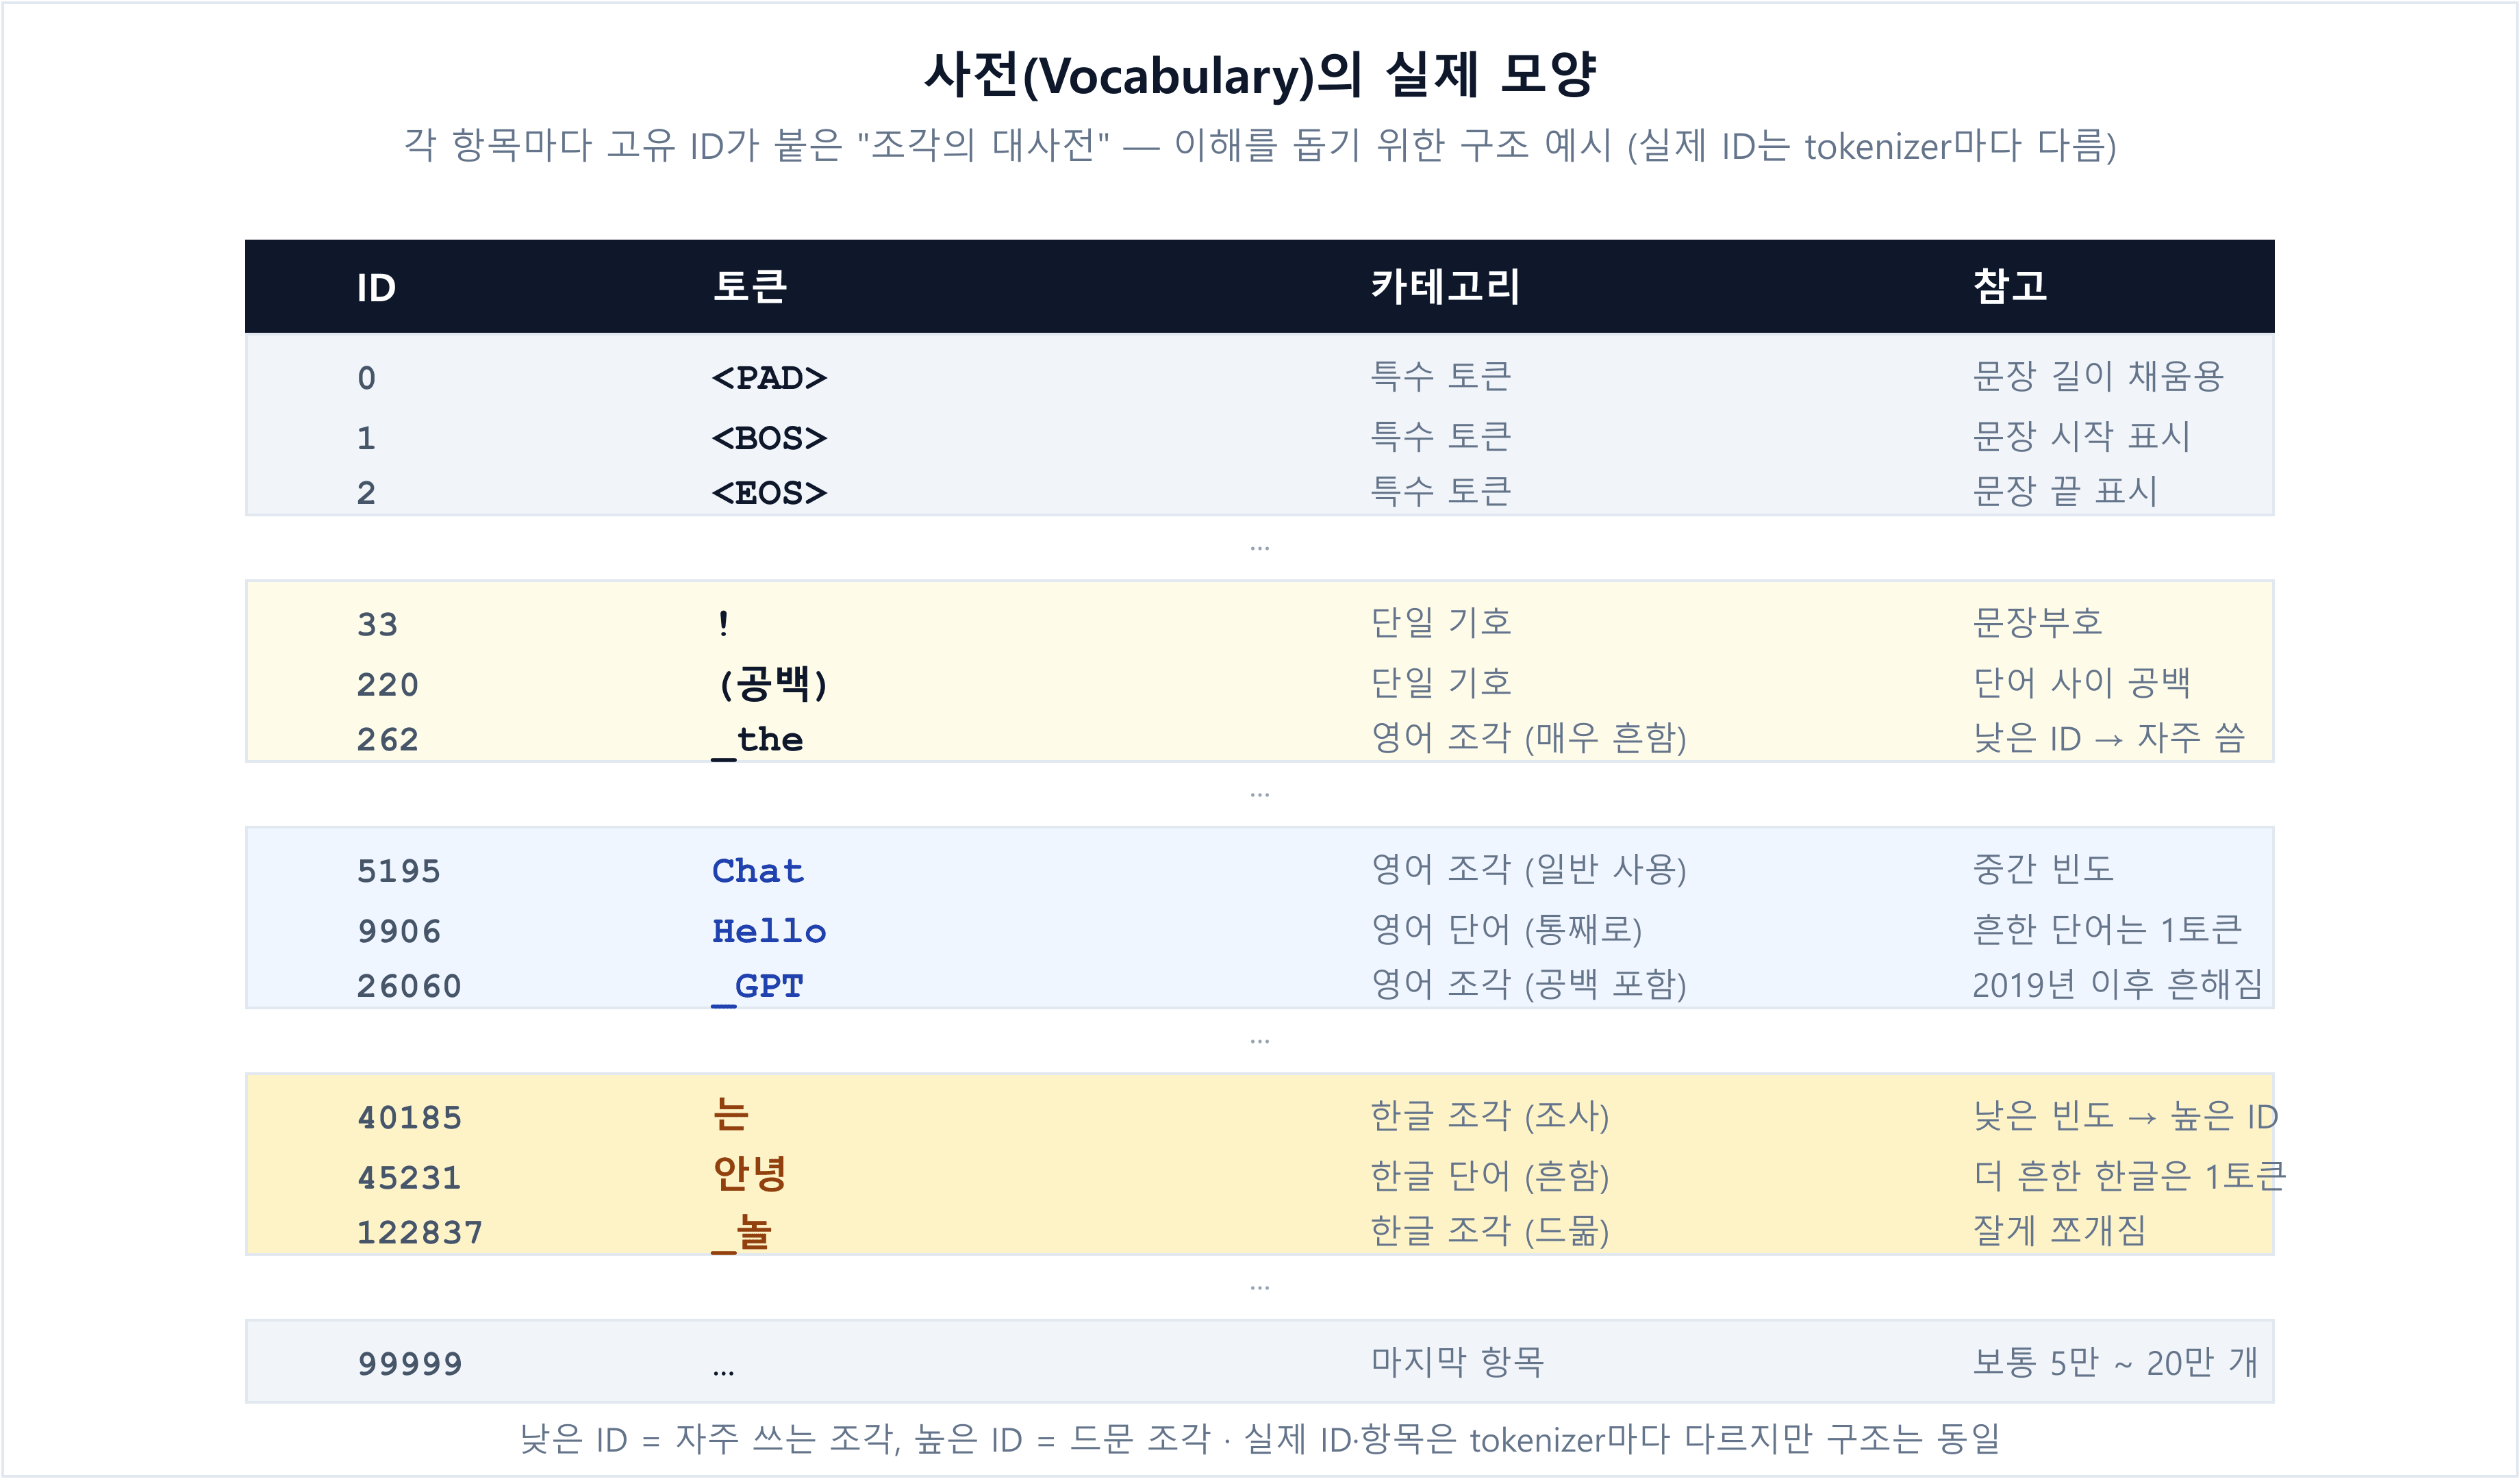
※ `_GPT`, `_the`, `_놀`에서 밑줄(_)은 "이 토큰 앞에 공백이 있다"는 뜻이에요. BPE는 "Chat"과 " Chat"(앞에 공백)을 완전히 다른 토큰으로 취급해요 — 그래야 "ChatGPT"(붙여쓰기)와 "Chat GPT"(띄어쓰기)를 구분할 수 있거든요. 실제로 GPT는 Ġ, LLaMA는 ▁를 쓰지만 알아보기 어려워 그림에선 밑줄(_)로 표기했어요.
이 사전은 하늘에서 뚝 떨어진 게 아니에요. 인터넷 규모 텍스트를 읽으며 BPE(Byte-Pair Encoding)라는 방법으로 만들어집니다. 원리는 놀랍도록 단순해요.
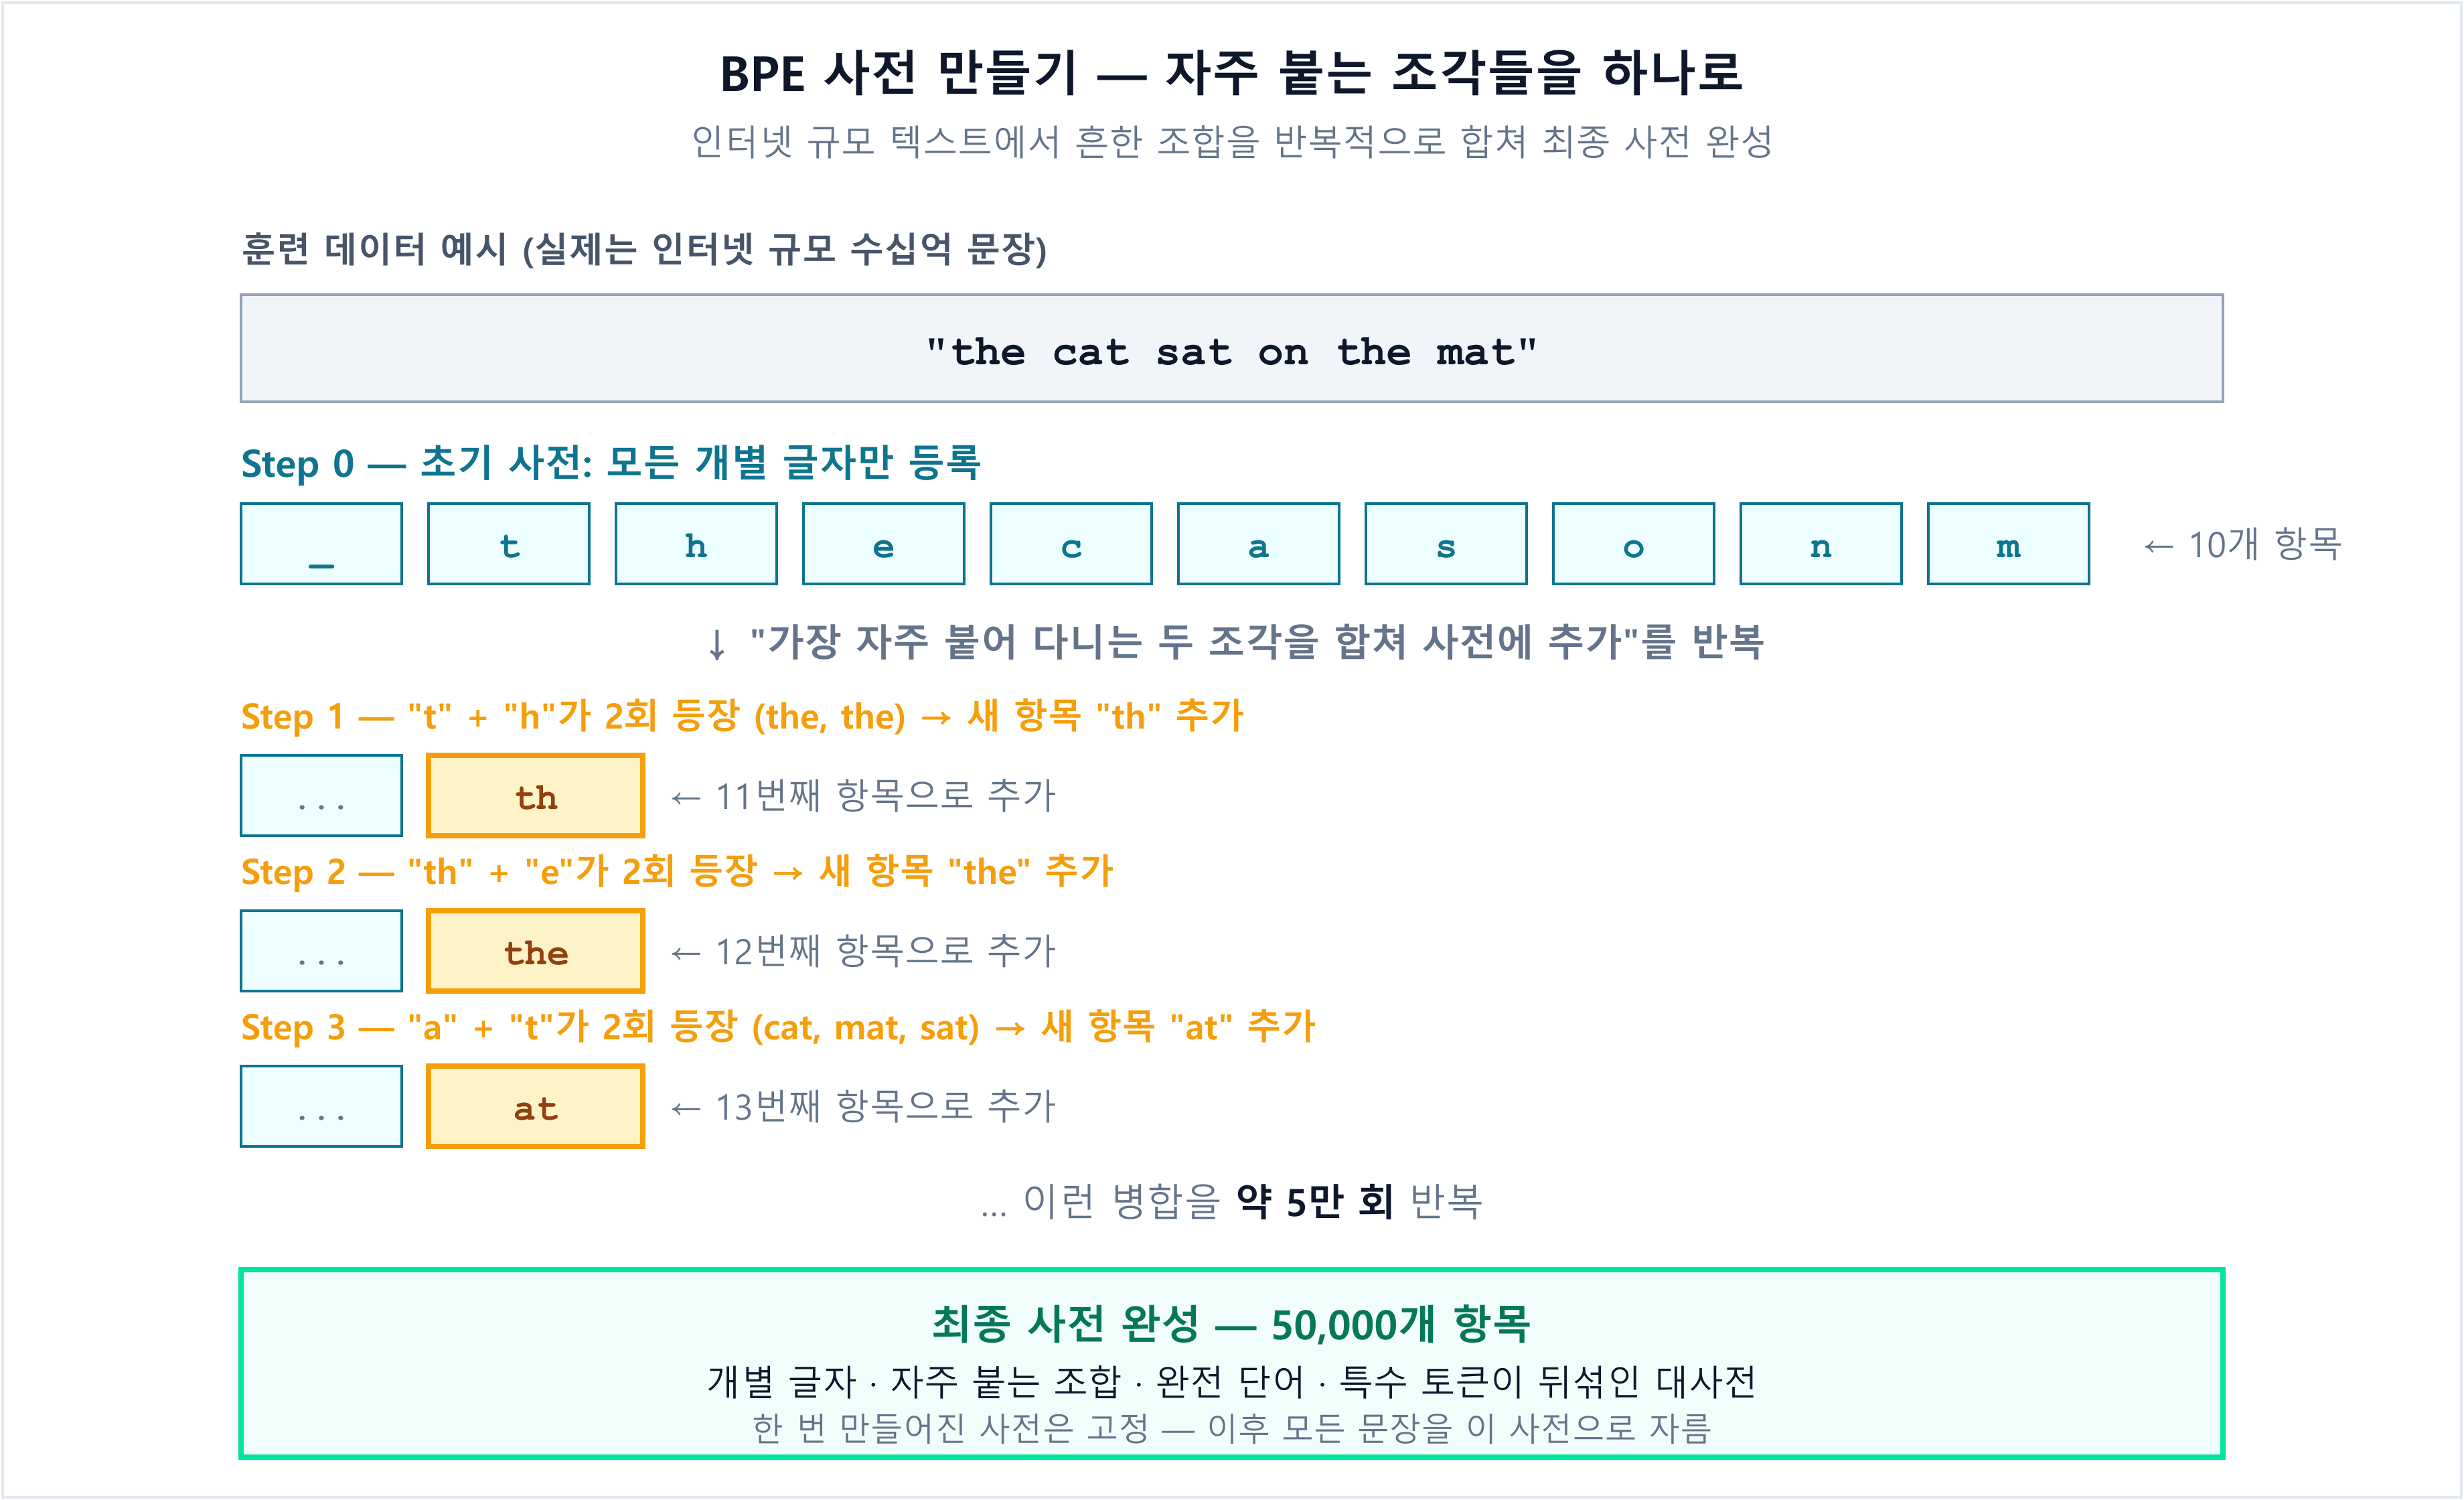
이 방식은 자주 등장하는 조합은 한 토큰으로 뭉치고, 드문 조합은 잘게 쪼개는 절묘한 균형을 만들어요. 그래서 앞 토큰화 그림에서 영어 "Chat"이 통째로 하나가 되고, 한글 "놀라워요"는 여러 조각으로 나뉜 거예요 — 사전 훈련 데이터에 한글이 상대적으로 적었기 때문이에요. 사전이 완성되면 그다음부턴 모든 문장을 이 사전으로 잘라내는 일만 반복합니다.
💡 대표 모델의 사전 크기 — GPT-3 ≈ 5만, GPT-3.5·GPT-4 ≈ 10만, GPT-4o ≈ 20만, LLaMA 2 = 3만 2천, DeepSeek-V3 ≈ 12만 8천. 크면 흔한 단어를 통째로 담을 수 있어 토큰 수 절약, 대신 임베딩 테이블이 커져 파라미터·메모리 부담 ↑ — 트레이드오프예요.
그런데 여기서 문제가 하나 생겨요. 모든 단어를 "한 번에" 펼쳐 놓고 보면, 단어의 순서 정보가 사라집니다. "개가 사람을 물었다"와 "사람이 개를 물었다"가 같은 단어 뭉치로 보이면 큰일이죠. 그래서 각 단어에 "너는 몇 번째 자리야"라는 위치 신호를 더해줍니다. 이걸 포지셔널 인코딩(positional encoding)이라고 해요.
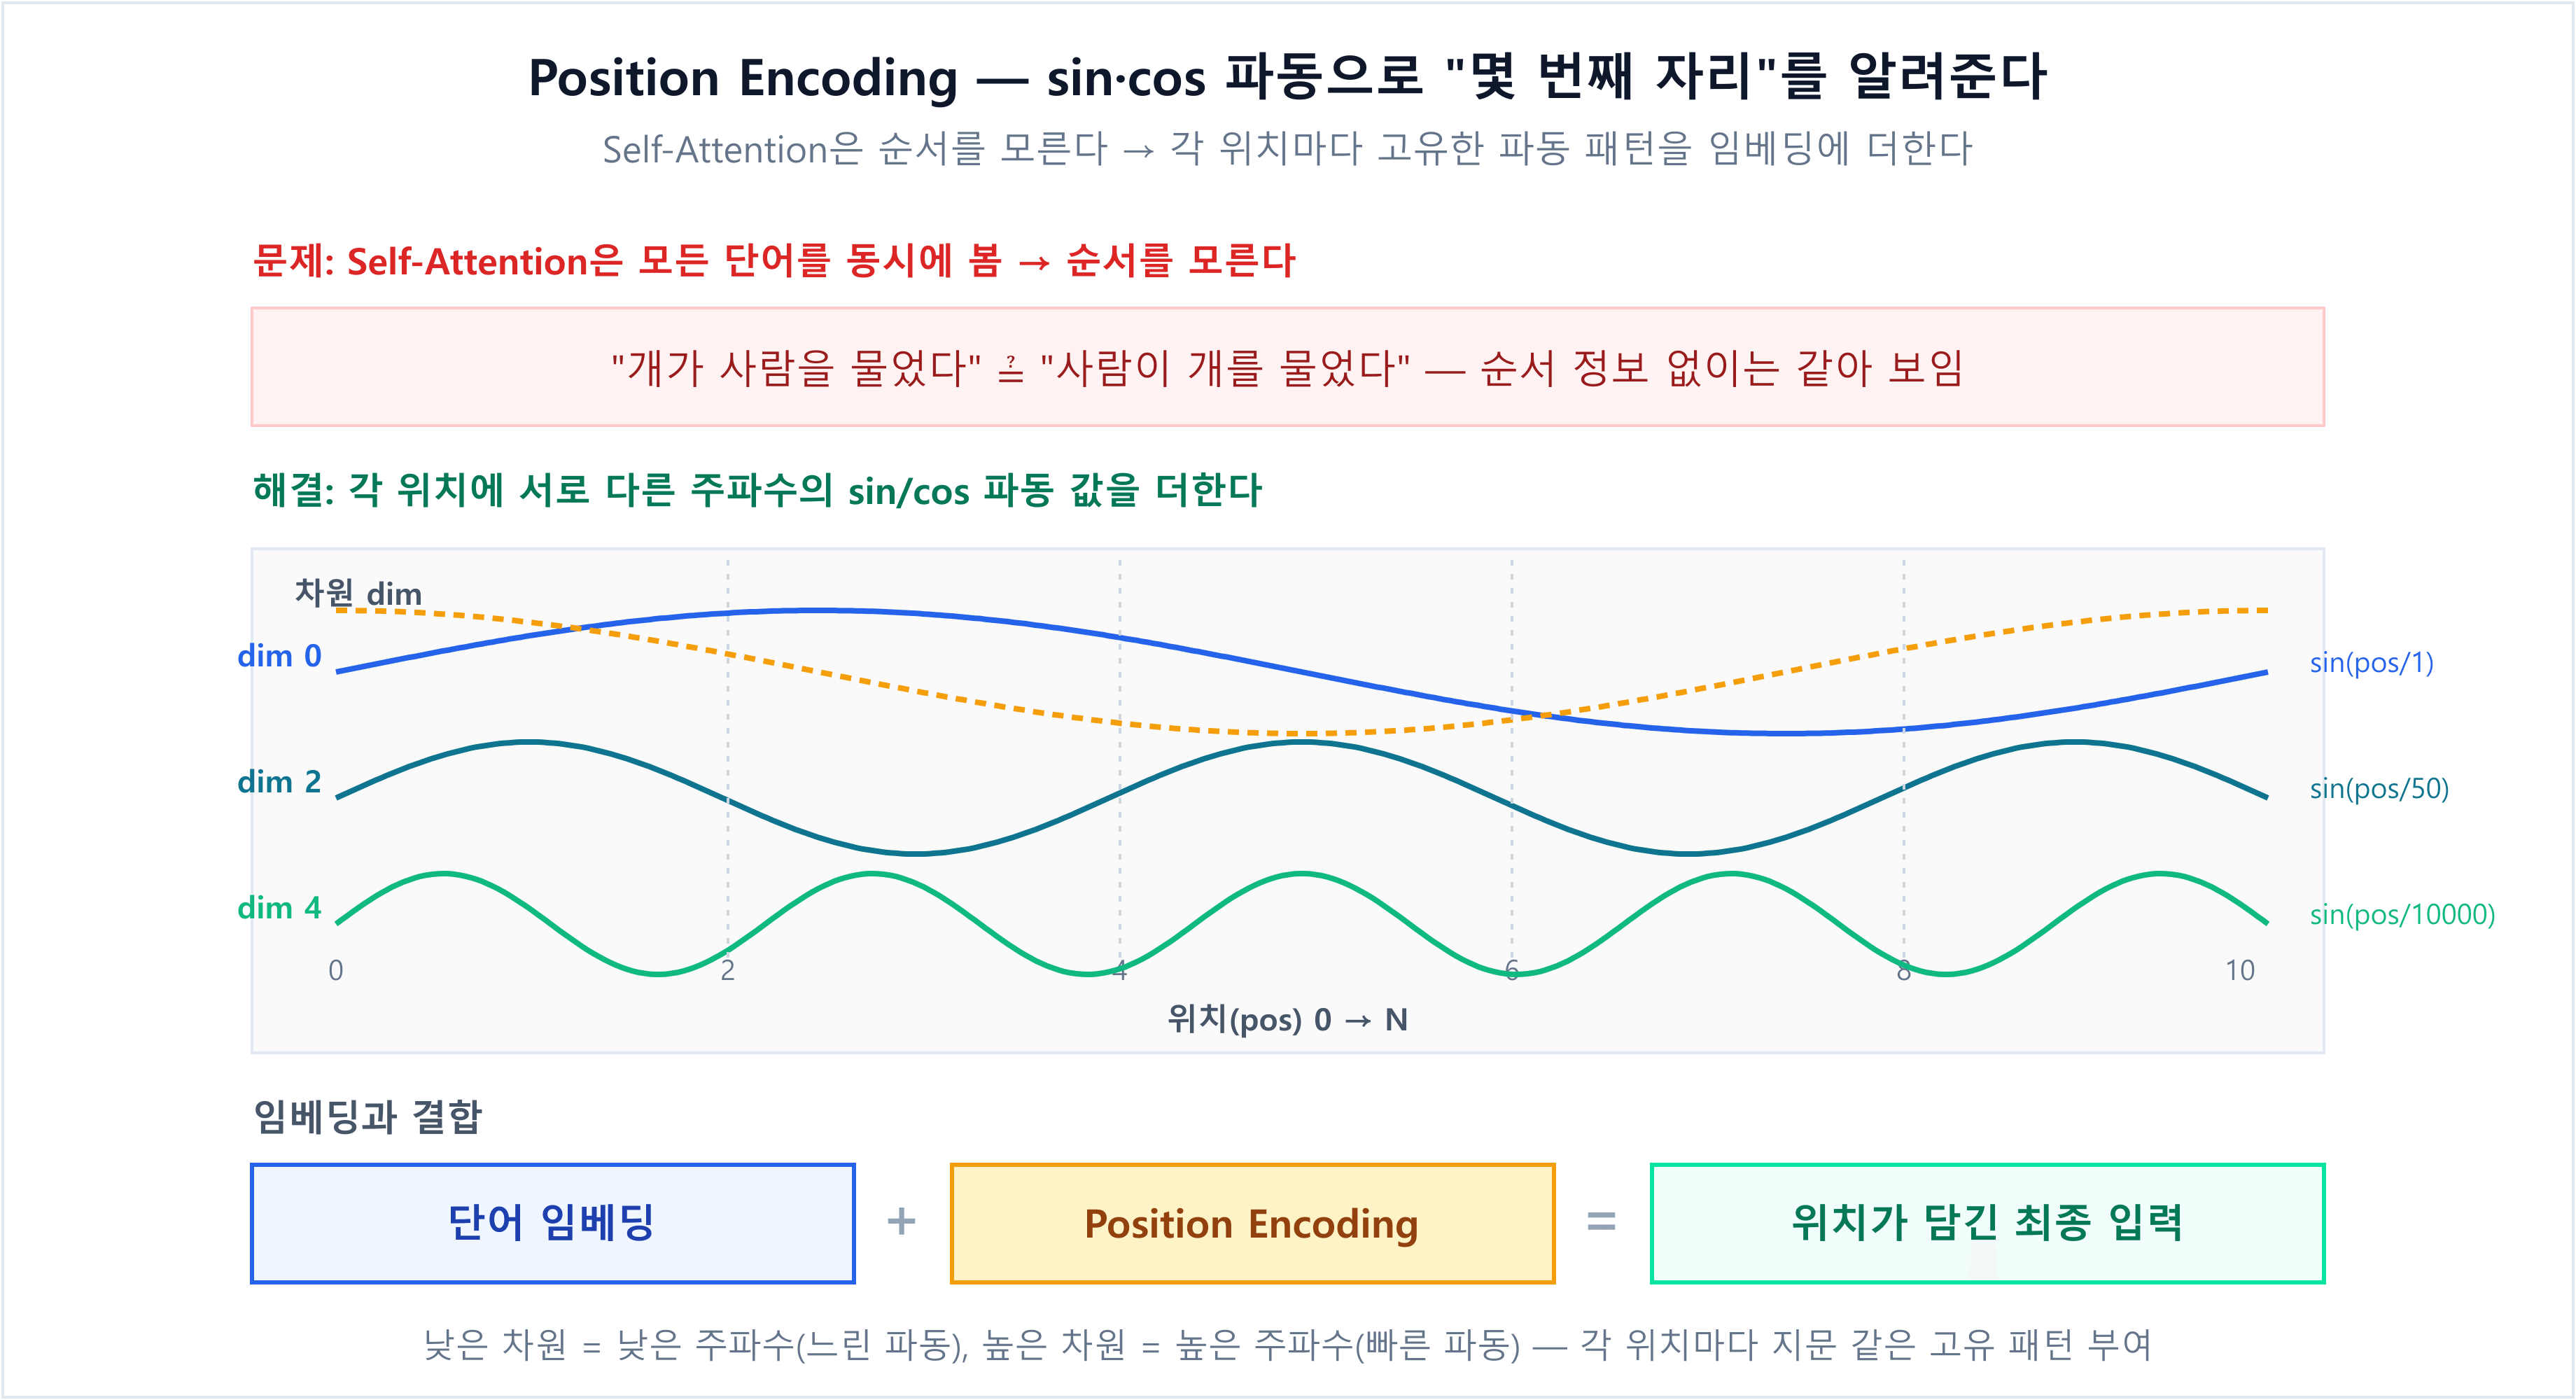
그럼 저 파동에 넣는 위치 번호(pos)는 뭘까요? 아주 단순합니다 — 문장에서 몇 번째 자리에 있는 토큰인가예요. 앞 예시 "ChatGPT는 놀라워요!"에서 "Chat"은 pos=0, "G"는 pos=1, "!"는 pos=8 하는 식으로요.
여기서 헷갈리기 쉬운 지점 하나 — 토큰 ID와 위치 번호는 완전히 다른 개념이에요. 토큰 ID는 "어떤 단어야?"를 알려주는 사전 색인 번호이고, 위치 번호는 "몇 번째 자리야?"를 알려주는 문장 안 순번입니다.
비유로 정리 — 학번과 자리 번호
토큰 ID = 학번 — 그 학생이 누구인지. 어느 교실에 가도 학번은 그대로. "Chat"은 언제 어디서든 5195번
위치 번호 = 오늘의 자리 번호 — 오늘 어디 앉았는지. 매 문장마다 새로 매김. 같은 "Chat"이라도 문장 첫머리면 pos=0, 뒤쪽에 다시 나오면 pos=7
예를 들어 "Chat 봇도 Chat이야" 같은 문장을 보면 "Chat"이 두 번 나오죠. 두 "Chat"의 토큰 ID는 5195로 동일합니다 — 사전상 같은 단어니까요. 하지만 위치 번호는 0과 2로 다르죠. 그래서 임베딩(토큰 ID로 꺼낸 의미 벡터) + Position Encoding(위치 번호로 계산한 자리 벡터)을 더한 최종 벡터는 서로 달라져요. 모델이 두 "Chat"을 문맥 속에서 구분할 수 있는 비결이 여기 있습니다.
※ 원 논문은 위치마다 고유한 sin·cos 파동 패턴을 신호로 더했어요. 요즘 모델은 학습형 위치 임베딩, 회전형(RoPE) 등 변형을 많이 쓰지만, "순서 정보를 명시적으로 넣어준다"는 목적은 똑같습니다.
STEP 2 / 5Self-Attention — '그것'이 무엇을 가리키는지 아는 법
이제 핵심 직관이에요. 다음 문장을 보세요.
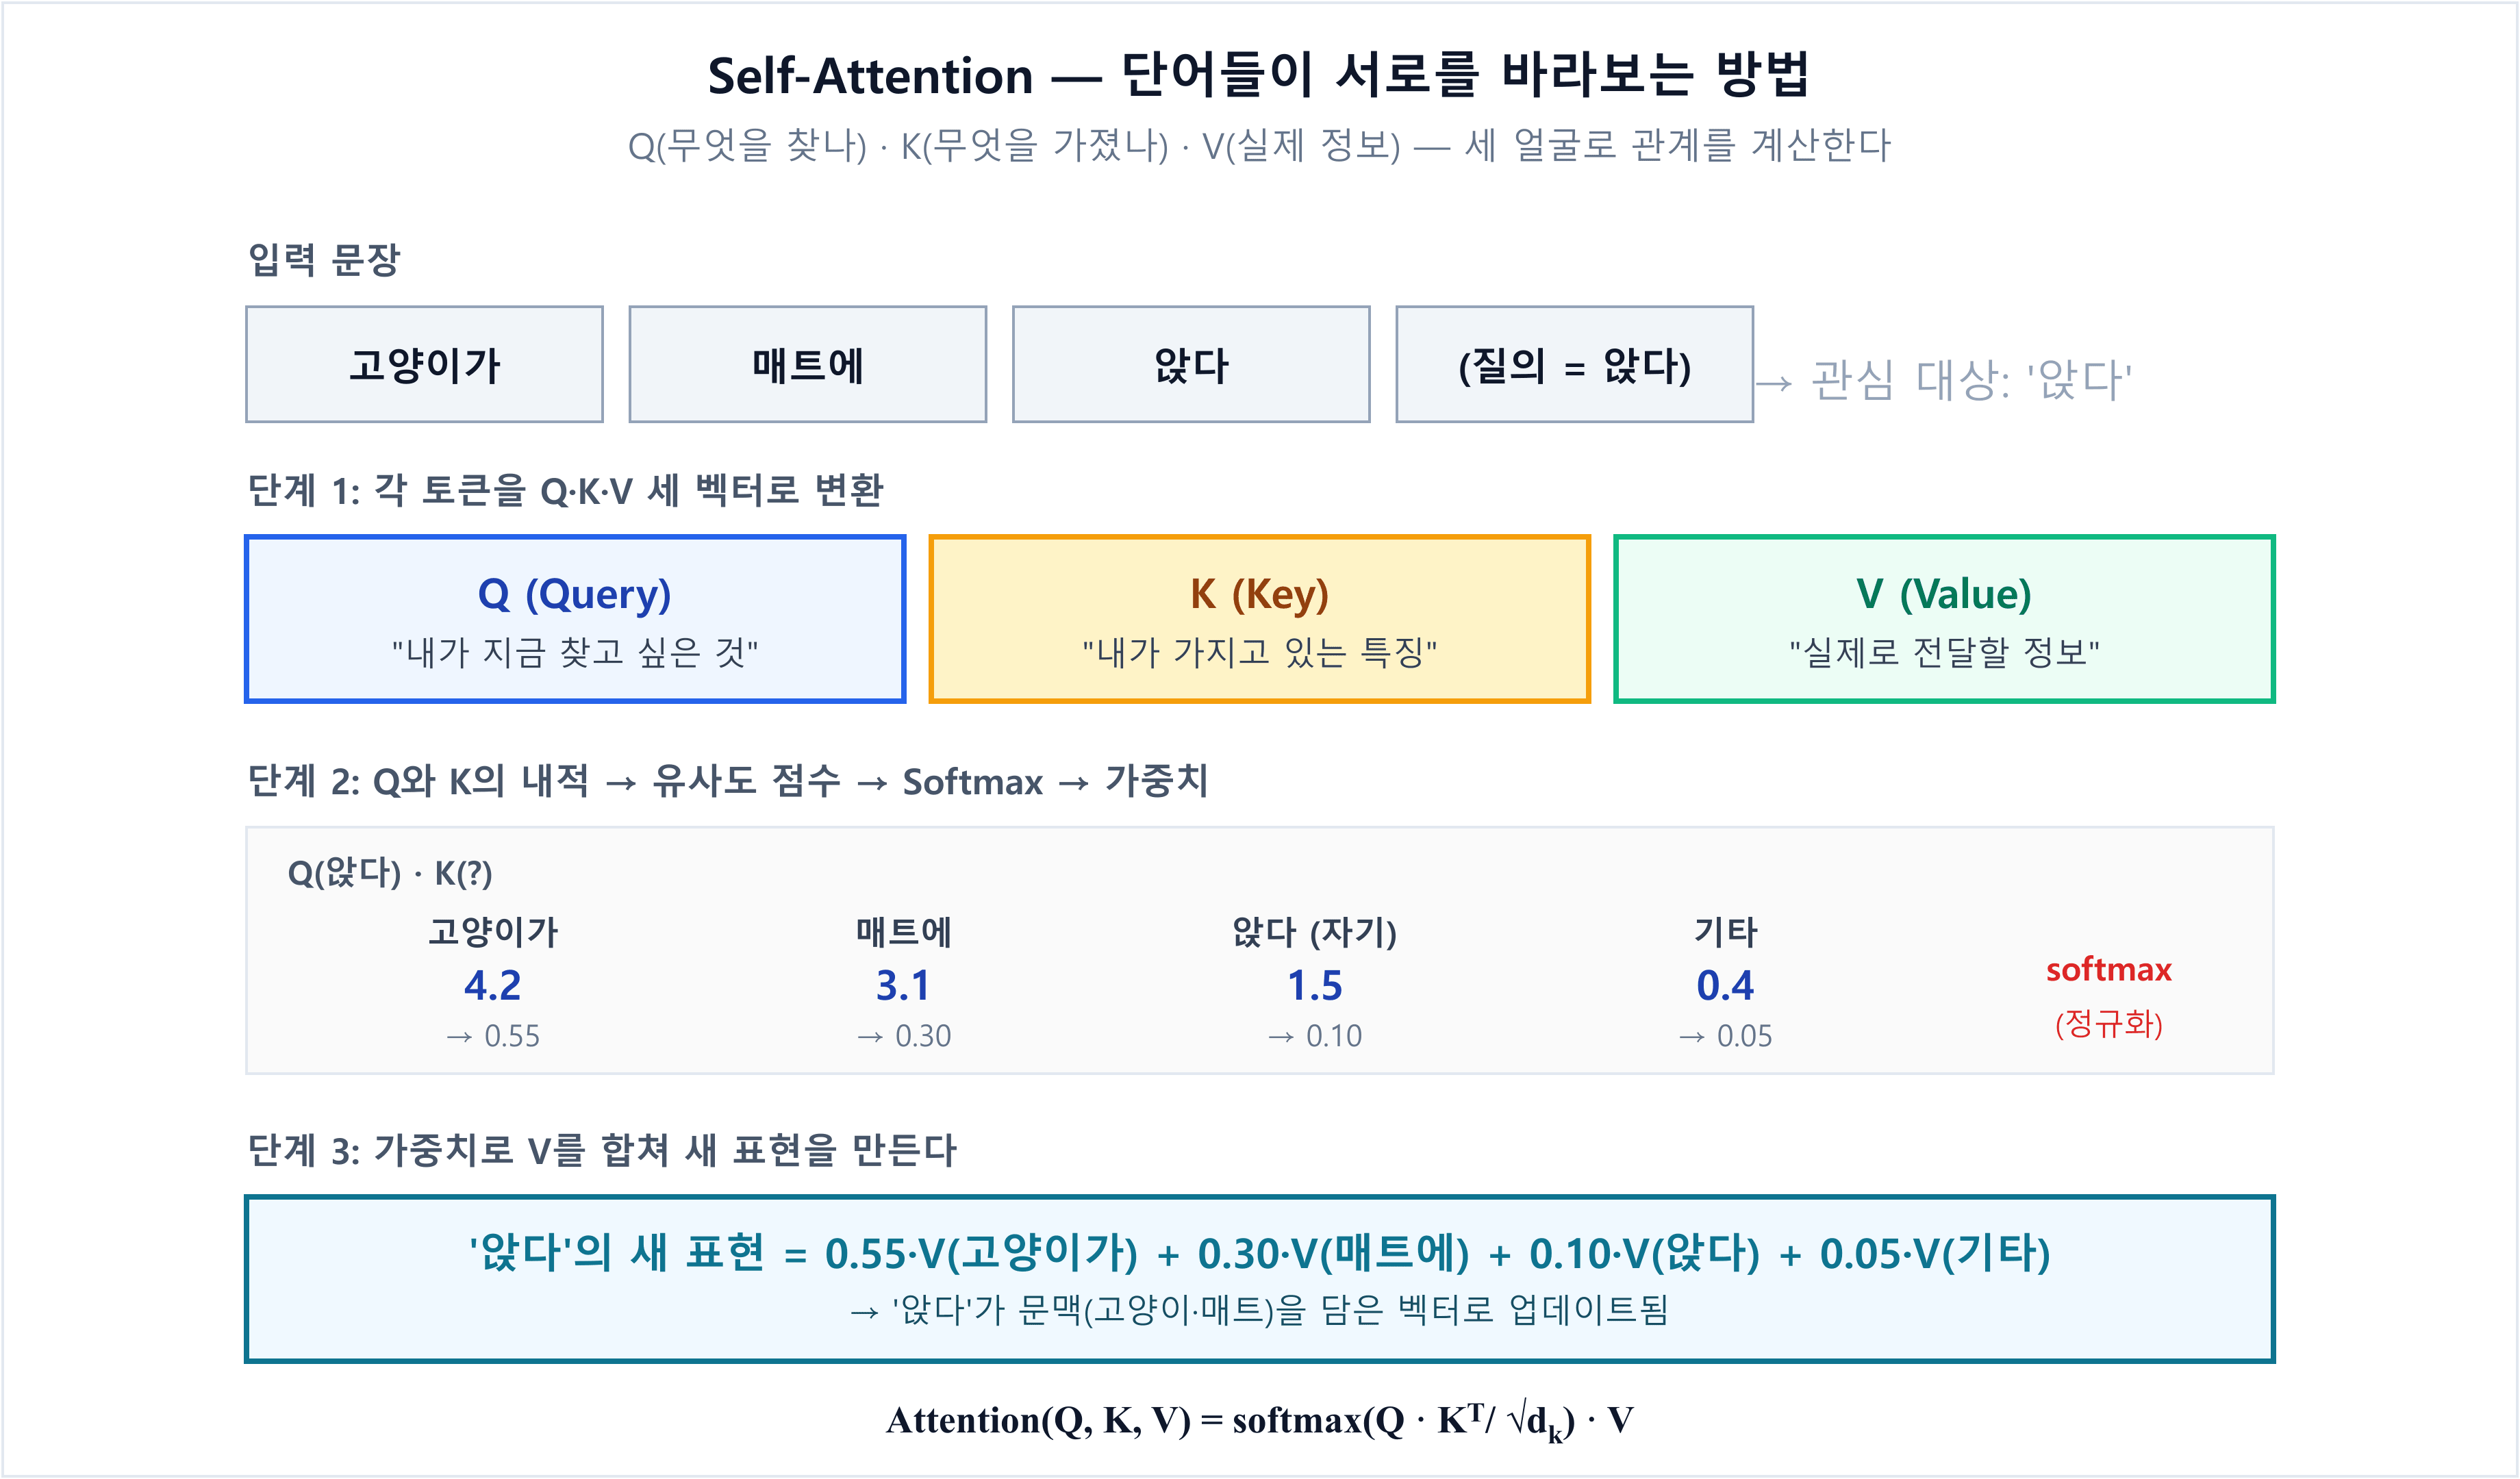
여기서 '그것'은 강아지일까요, 길일까요? 사람은 단번에 '강아지'라고 알아요. 모델도 이걸 알아내야 제대로 이해한 거예요. 어떻게? '그것'이라는 단어가 문장의 다른 모든 단어를 둘러보며 "나와 가장 관련 깊은 게 누구지?"를 묻는 거예요. 그리고 '강아지'에 가장 높은 관련도 점수를 줍니다.
이렇게 한 문장 안에서 단어들이 서로를 바라보며 관련도를 매기는 것을 셀프 어텐션(Self-Attention)이라고 해요. '셀프(자기)'인 이유는, 다른 문장이 아니라 자기 문장 안에서 서로를 참조하기 때문이에요. 모든 단어가 모든 단어에 대해 이 점수를 매기므로, 거리가 멀든 가깝든 관계를 직접 포착할 수 있습니다 — RNN이 못 했던 바로 그 일이죠.
💡 한 줄 요약 — 어텐션은 결국 "각 단어가 다른 단어들의 정보를 얼마씩 가져올지 비중을 정하는 일"이에요. '그것'은 '강아지'의 정보를 듬뿍, '길'의 정보는 조금만 섞어서 자기 의미를 완성합니다.
STEP 3 / 5Q·K·V — 도서관 검색으로 이해하는 어텐션
그럼 "관련도 점수"는 어떻게 계산할까요? Transformer는 각 단어를 세 가지 역할(얼굴)로 변환해요. 이름은 어렵지만 도서관 검색에 비유하면 한 번에 이해됩니다.
Q — Query(질문): 내가 지금 찾고 있는 것. "나는 어떤 단어와 관련 있지?" (검색창에 친 검색어)
K — Key(열쇠): 각 단어가 내건 "나는 이런 단어야"라는 색인표. (책마다 붙은 표제어)
V — Value(값): 그 단어가 실제로 품은 내용. (책의 본문)
작동 방식은 이래요. 내 질문(Q)을 다른 모든 단어의 색인표(K)와 맞춰봐서, 잘 맞을수록 높은 점수를 줍니다. 그 점수를 비중으로 삼아 각 단어의 내용(V)을 섞어 오죠. '그것'의 질문이 '강아지'의 색인과 잘 맞으면, 강아지의 내용을 듬뿍 가져오는 거예요. 이 전부가 단 한 줄의 식으로 정리됩니다.
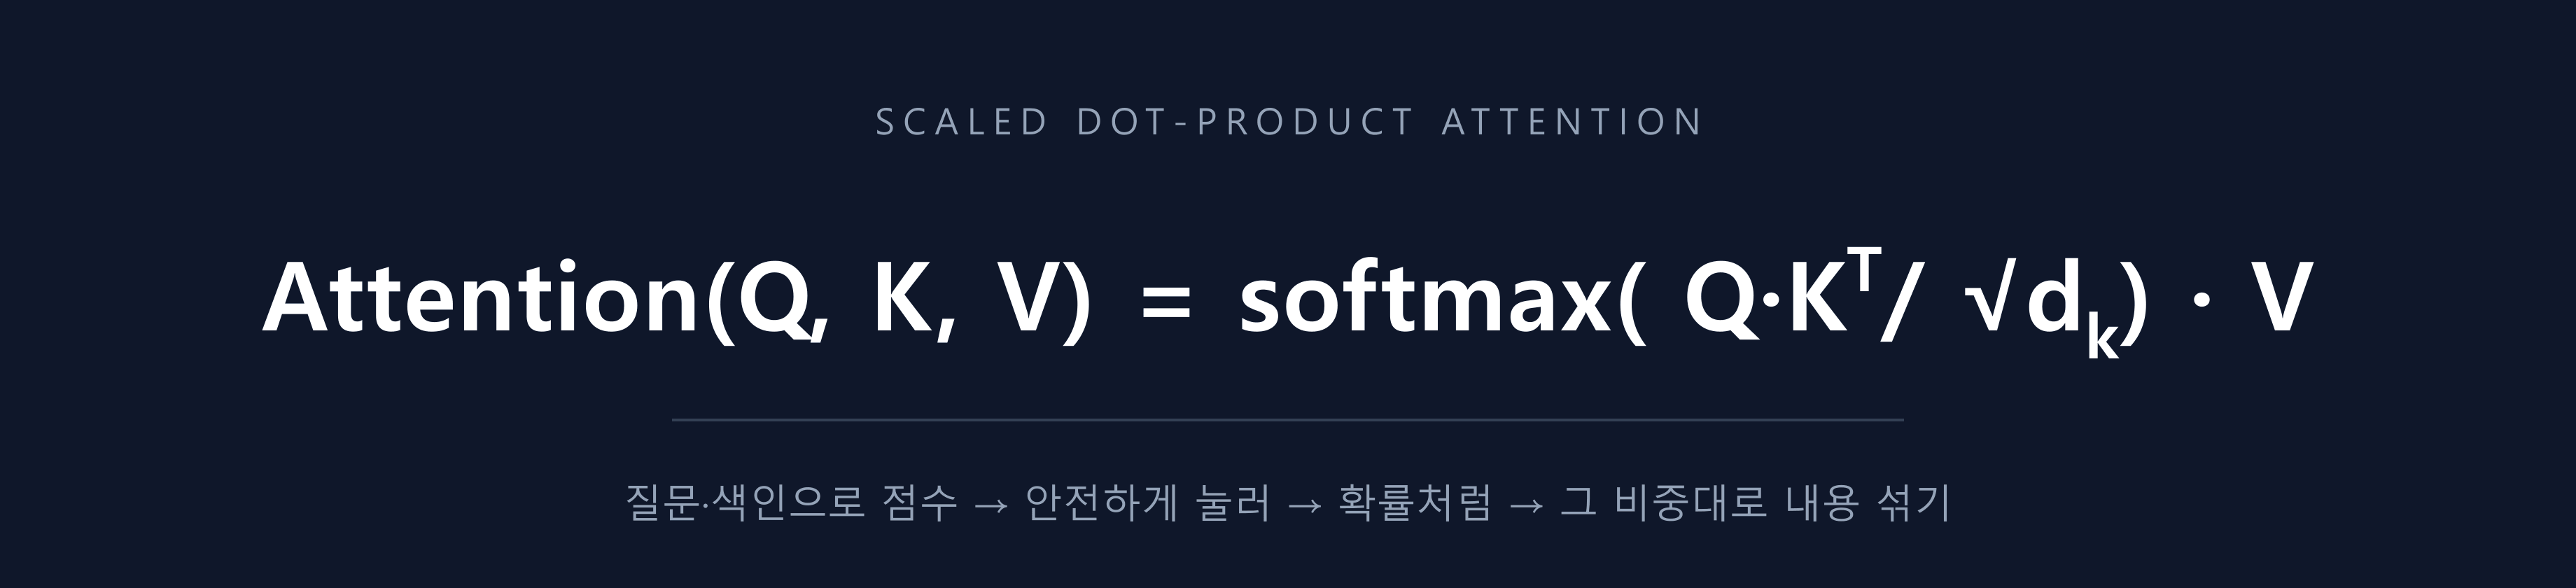
조각조각 뜯어보면 하나도 안 무서워요.
- Q·Kᵀ — 질문과 색인을 맞춰본 관련도 점수 (두 벡터의 내적: 방향이 비슷할수록 큰 값)
- ÷ √dₖ — 점수가 너무 커지지 않게 눌러주는 안전장치. 안 그러면 다음 단계가 한쪽으로 쏠려 학습이 불안정해져요
- softmax(...) — 점수들을 "합이 1인 비중"으로 변환. 8편의 Sigmoid, 9편의 Softmax가 또 등장하죠 — 점수를 확률처럼 만드는 그 함수예요
- ... · V — 그 비중대로 각 단어의 내용을 섞어 최종 결과를 만듦
즉 이 한 줄은 "질문과 색인을 맞춰 점수를 내고(Q·Kᵀ), 적당히 눌러(÷√dₖ) 비중으로 바꾼 뒤(softmax), 그 비중대로 내용을 섞는다(·V)"는 네 동작의 요약일 뿐이에요. 8편에서 약속한 "가중합 → 확률"의 골격이 여기서도 그대로 살아 있습니다.
STEP 4 / 5멀티헤드 + 블록 한 조각의 나머지 부품
한 번의 어텐션은 한 가지 관점만 봐요. 그런데 언어는 여러 층위가 동시에 작동하죠 — 문법 관계, 의미 관계, 시제 관계처럼요. 그래서 Transformer는 어텐션을 여러 개 병렬로 돌립니다. 이것이 멀티헤드 어텐션(Multi-Head Attention)이에요. (원 논문은 8개의 '헤드'를 썼어요.)
한 명이 문장을 보는 것보다, 8명이 각자 다른 관점으로 동시에 보고 의견을 합치는 셈이에요. 한 헤드는 주어–동사 관계에, 다른 헤드는 수식 관계에 집중하는 식으로 역할이 갈려 표현력이 크게 올라갑니다.
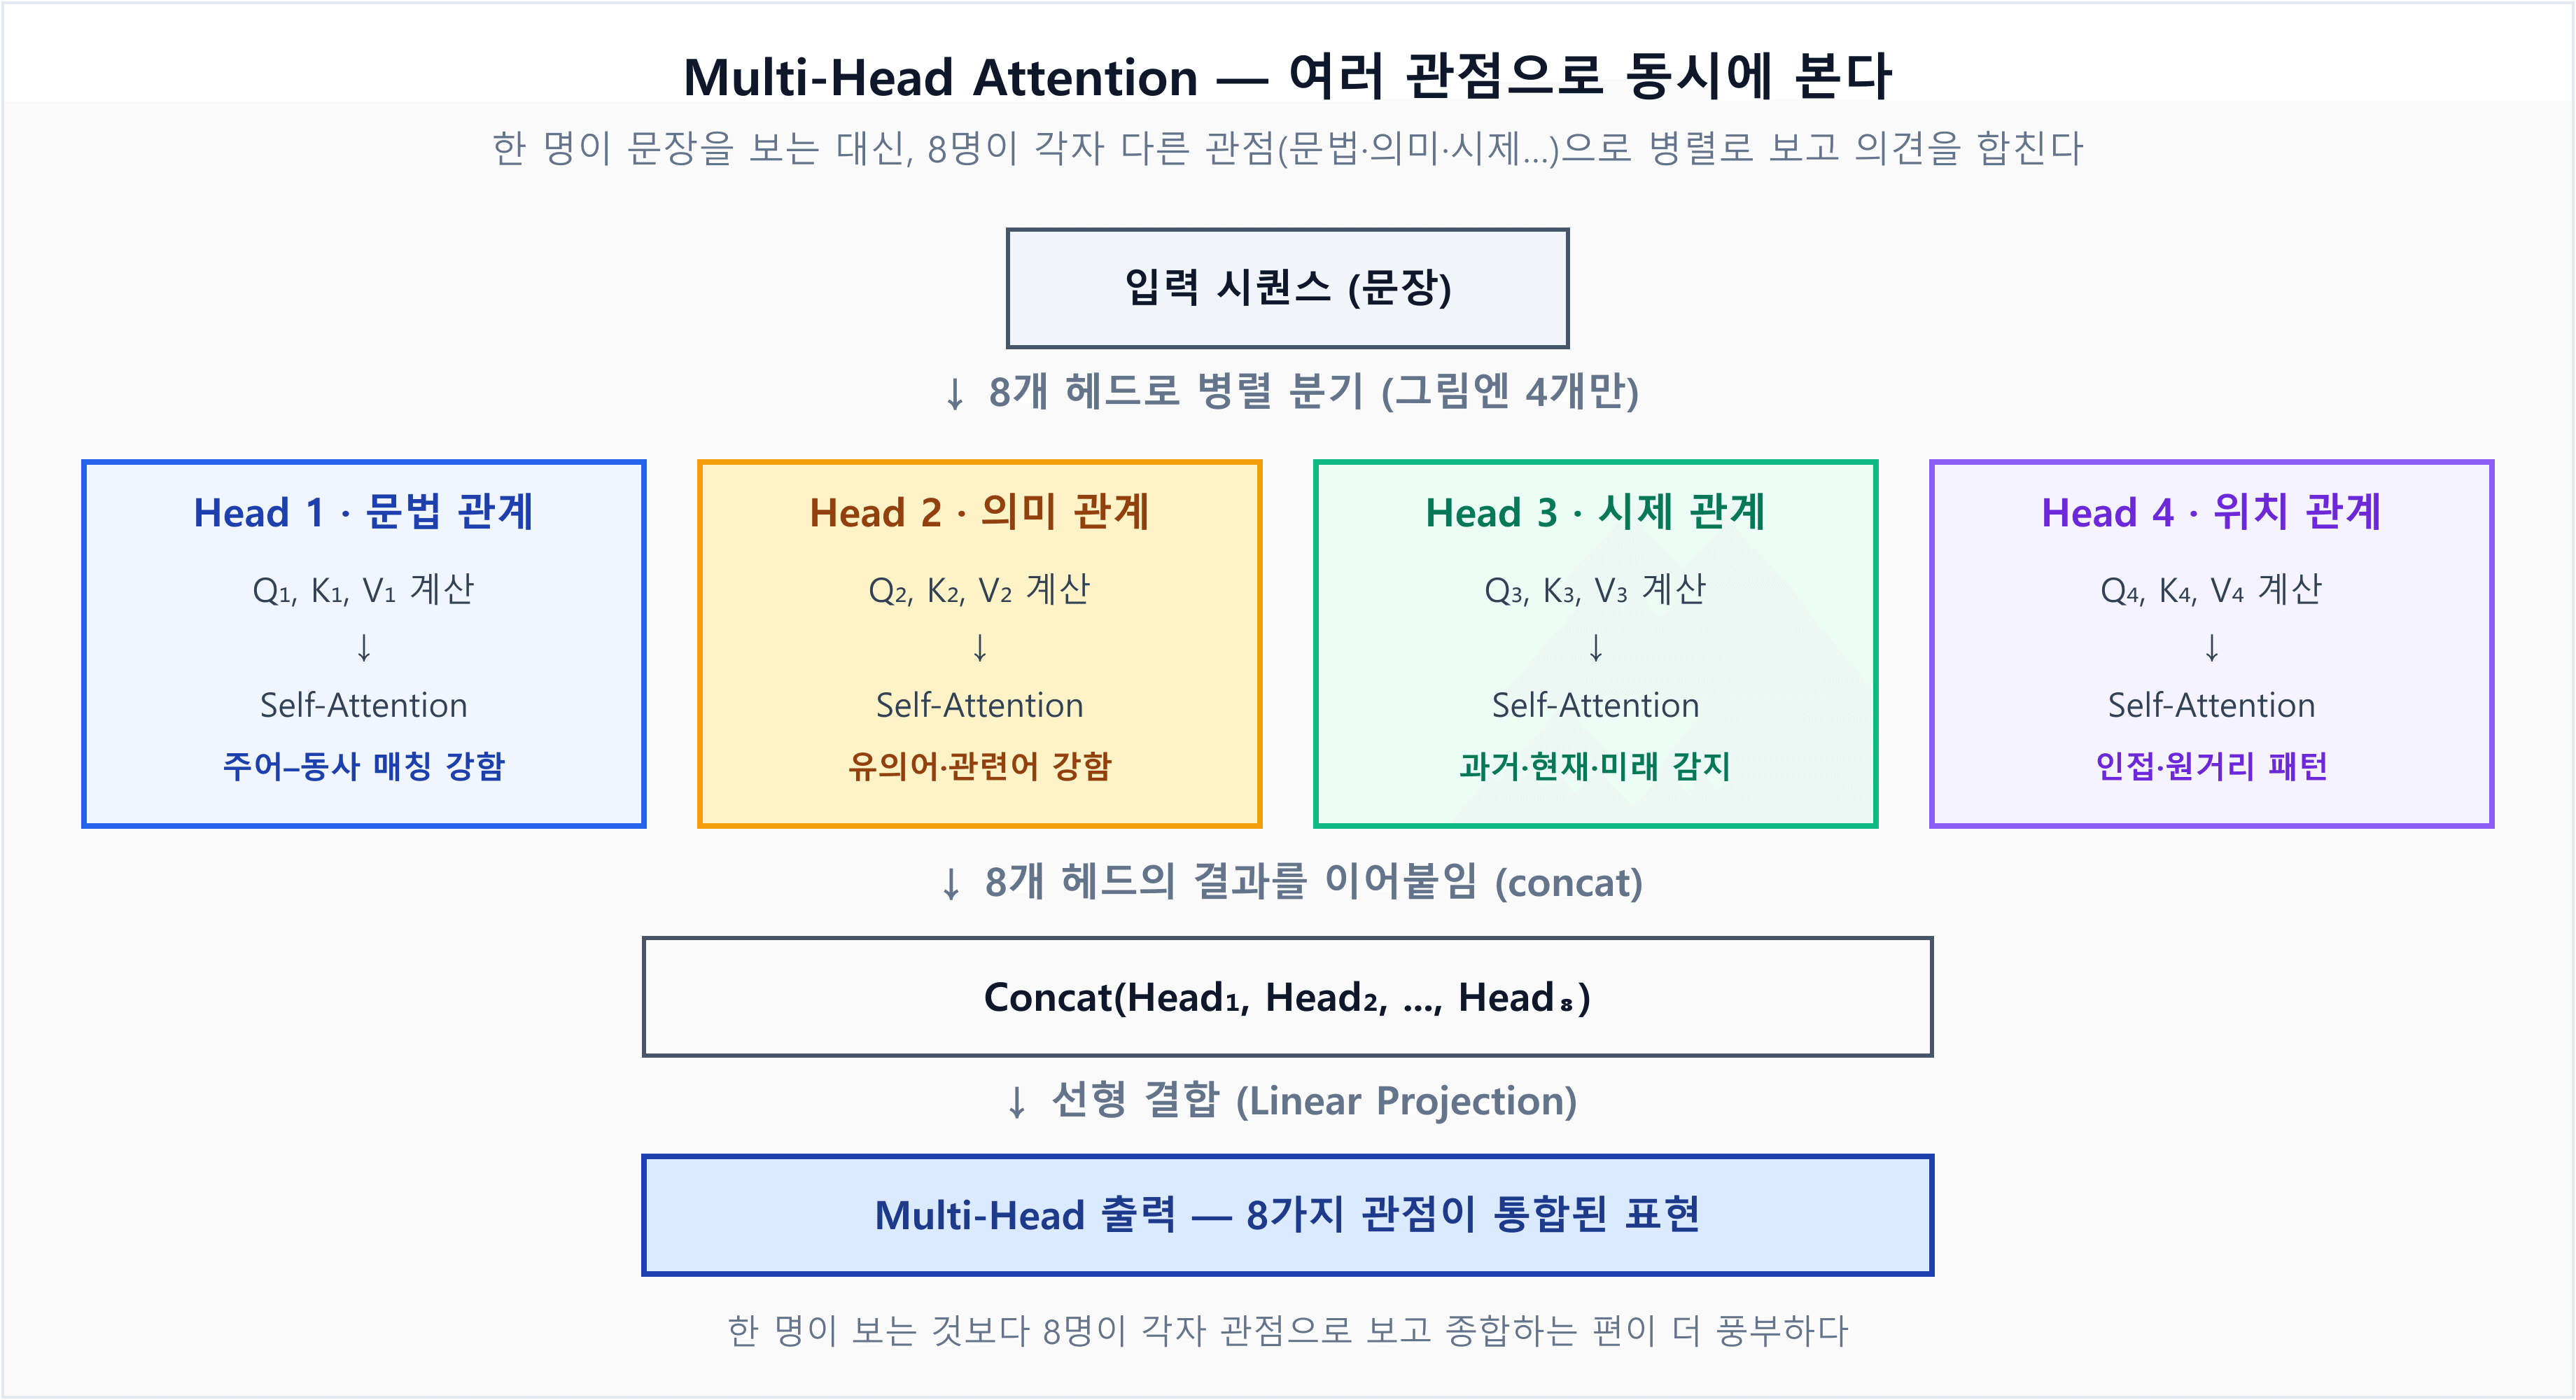
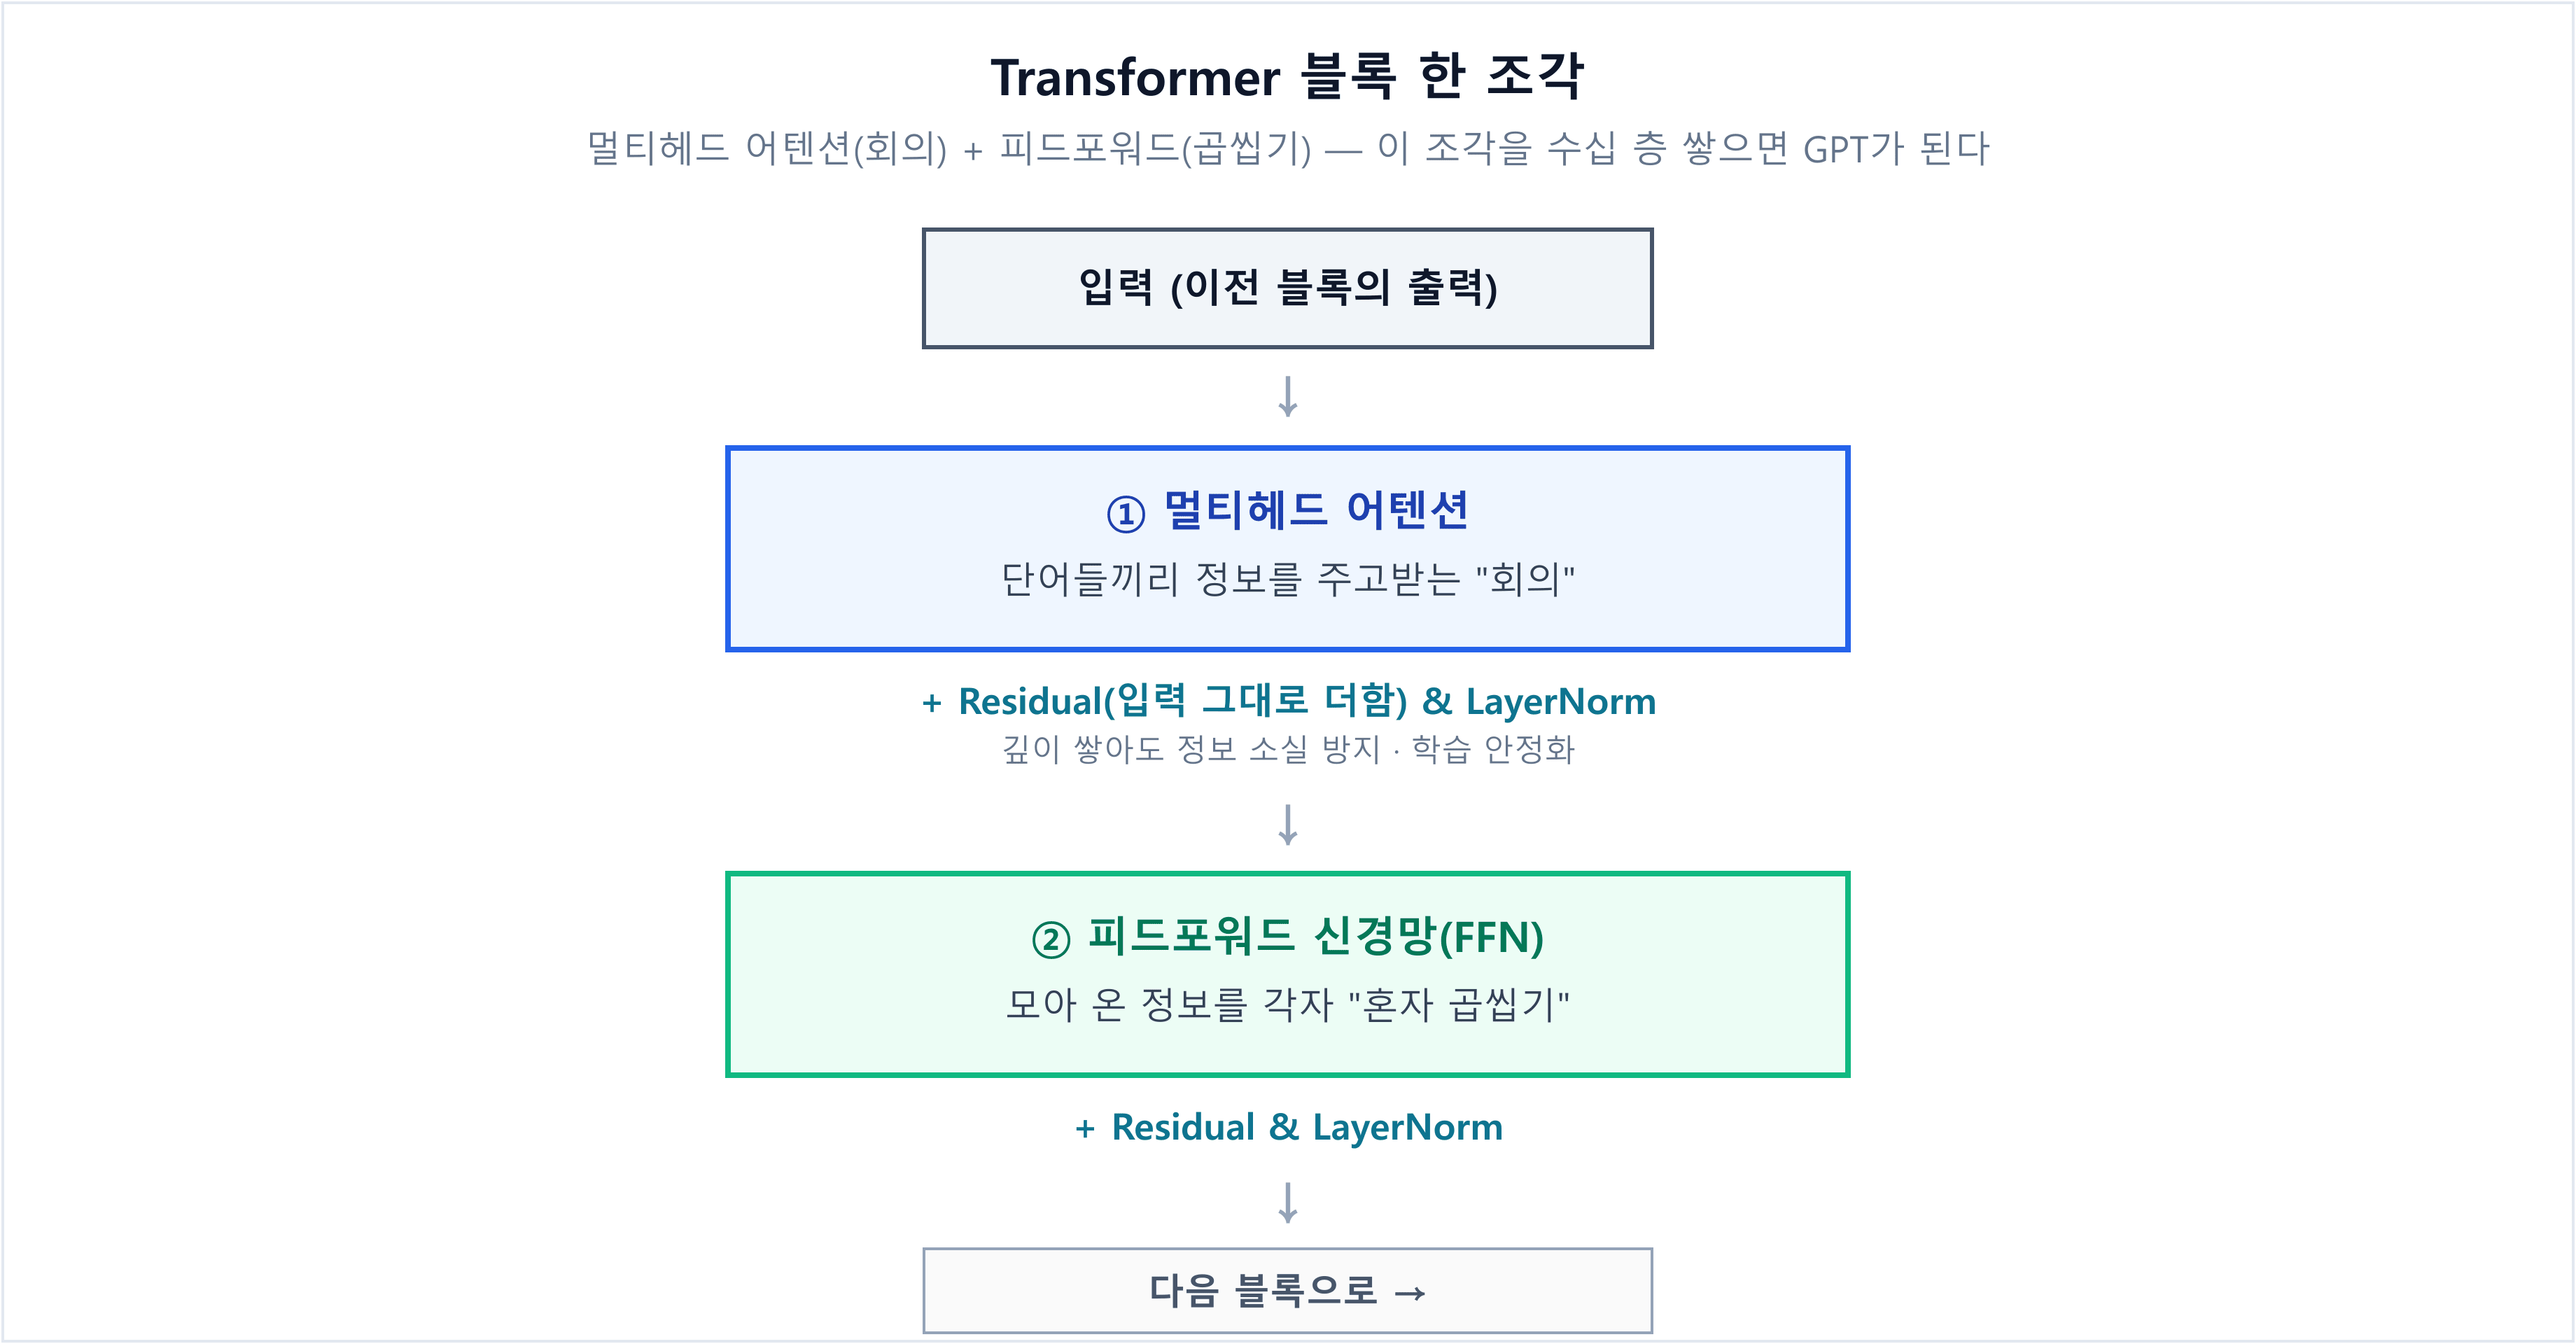
멀티헤드 어텐션은 Transformer 블록이라는 부품의 절반이에요. 한 블록은 이렇게 생겼습니다.
두 가지 보조 부품도 기억해 두세요.
- 잔차 연결(Residual): 각 단계의 출력에 입력을 그대로 더해 줍니다. 깊이 쌓아도 정보가 사라지지 않게 해주는 '우회 고속도로'예요.
- 레이어 정규화(LayerNorm): 층을 지날수록 숫자가 튀는 걸 잡아 학습을 안정시켜요.
※ 흔히 어텐션은 "어떤 정보를 가져올지 고르는 라우팅", FFN은 "지식을 저장·처리하는 곳"으로 비유돼요. 깔끔한 이분법은 아니지만 직관을 잡는 데 유용합니다. 이 부품들을 코드로 하나씩 조립하는 과정은 NumStats 'LLM 처음부터 만들기' Chapter 4에서 다룹니다.
STEP 5 / 5블록을 쌓으면 GPT가 된다
놀라운 사실은, 이 블록을 똑같이 여러 층 쌓기만 하면 GPT가 된다는 거예요. GPT-2는 이런 블록을 수십 층, 더 큰 모델은 수십~백 층 넘게 쌓았어요. 레고처럼 같은 조각을 반복하는 거죠. 9편에서 본 "비싼 사전학습"은 결국 이 거대한 블록 탑의 숫자들을 다음 토큰 예측으로 채워 넣는 과정이었습니다.
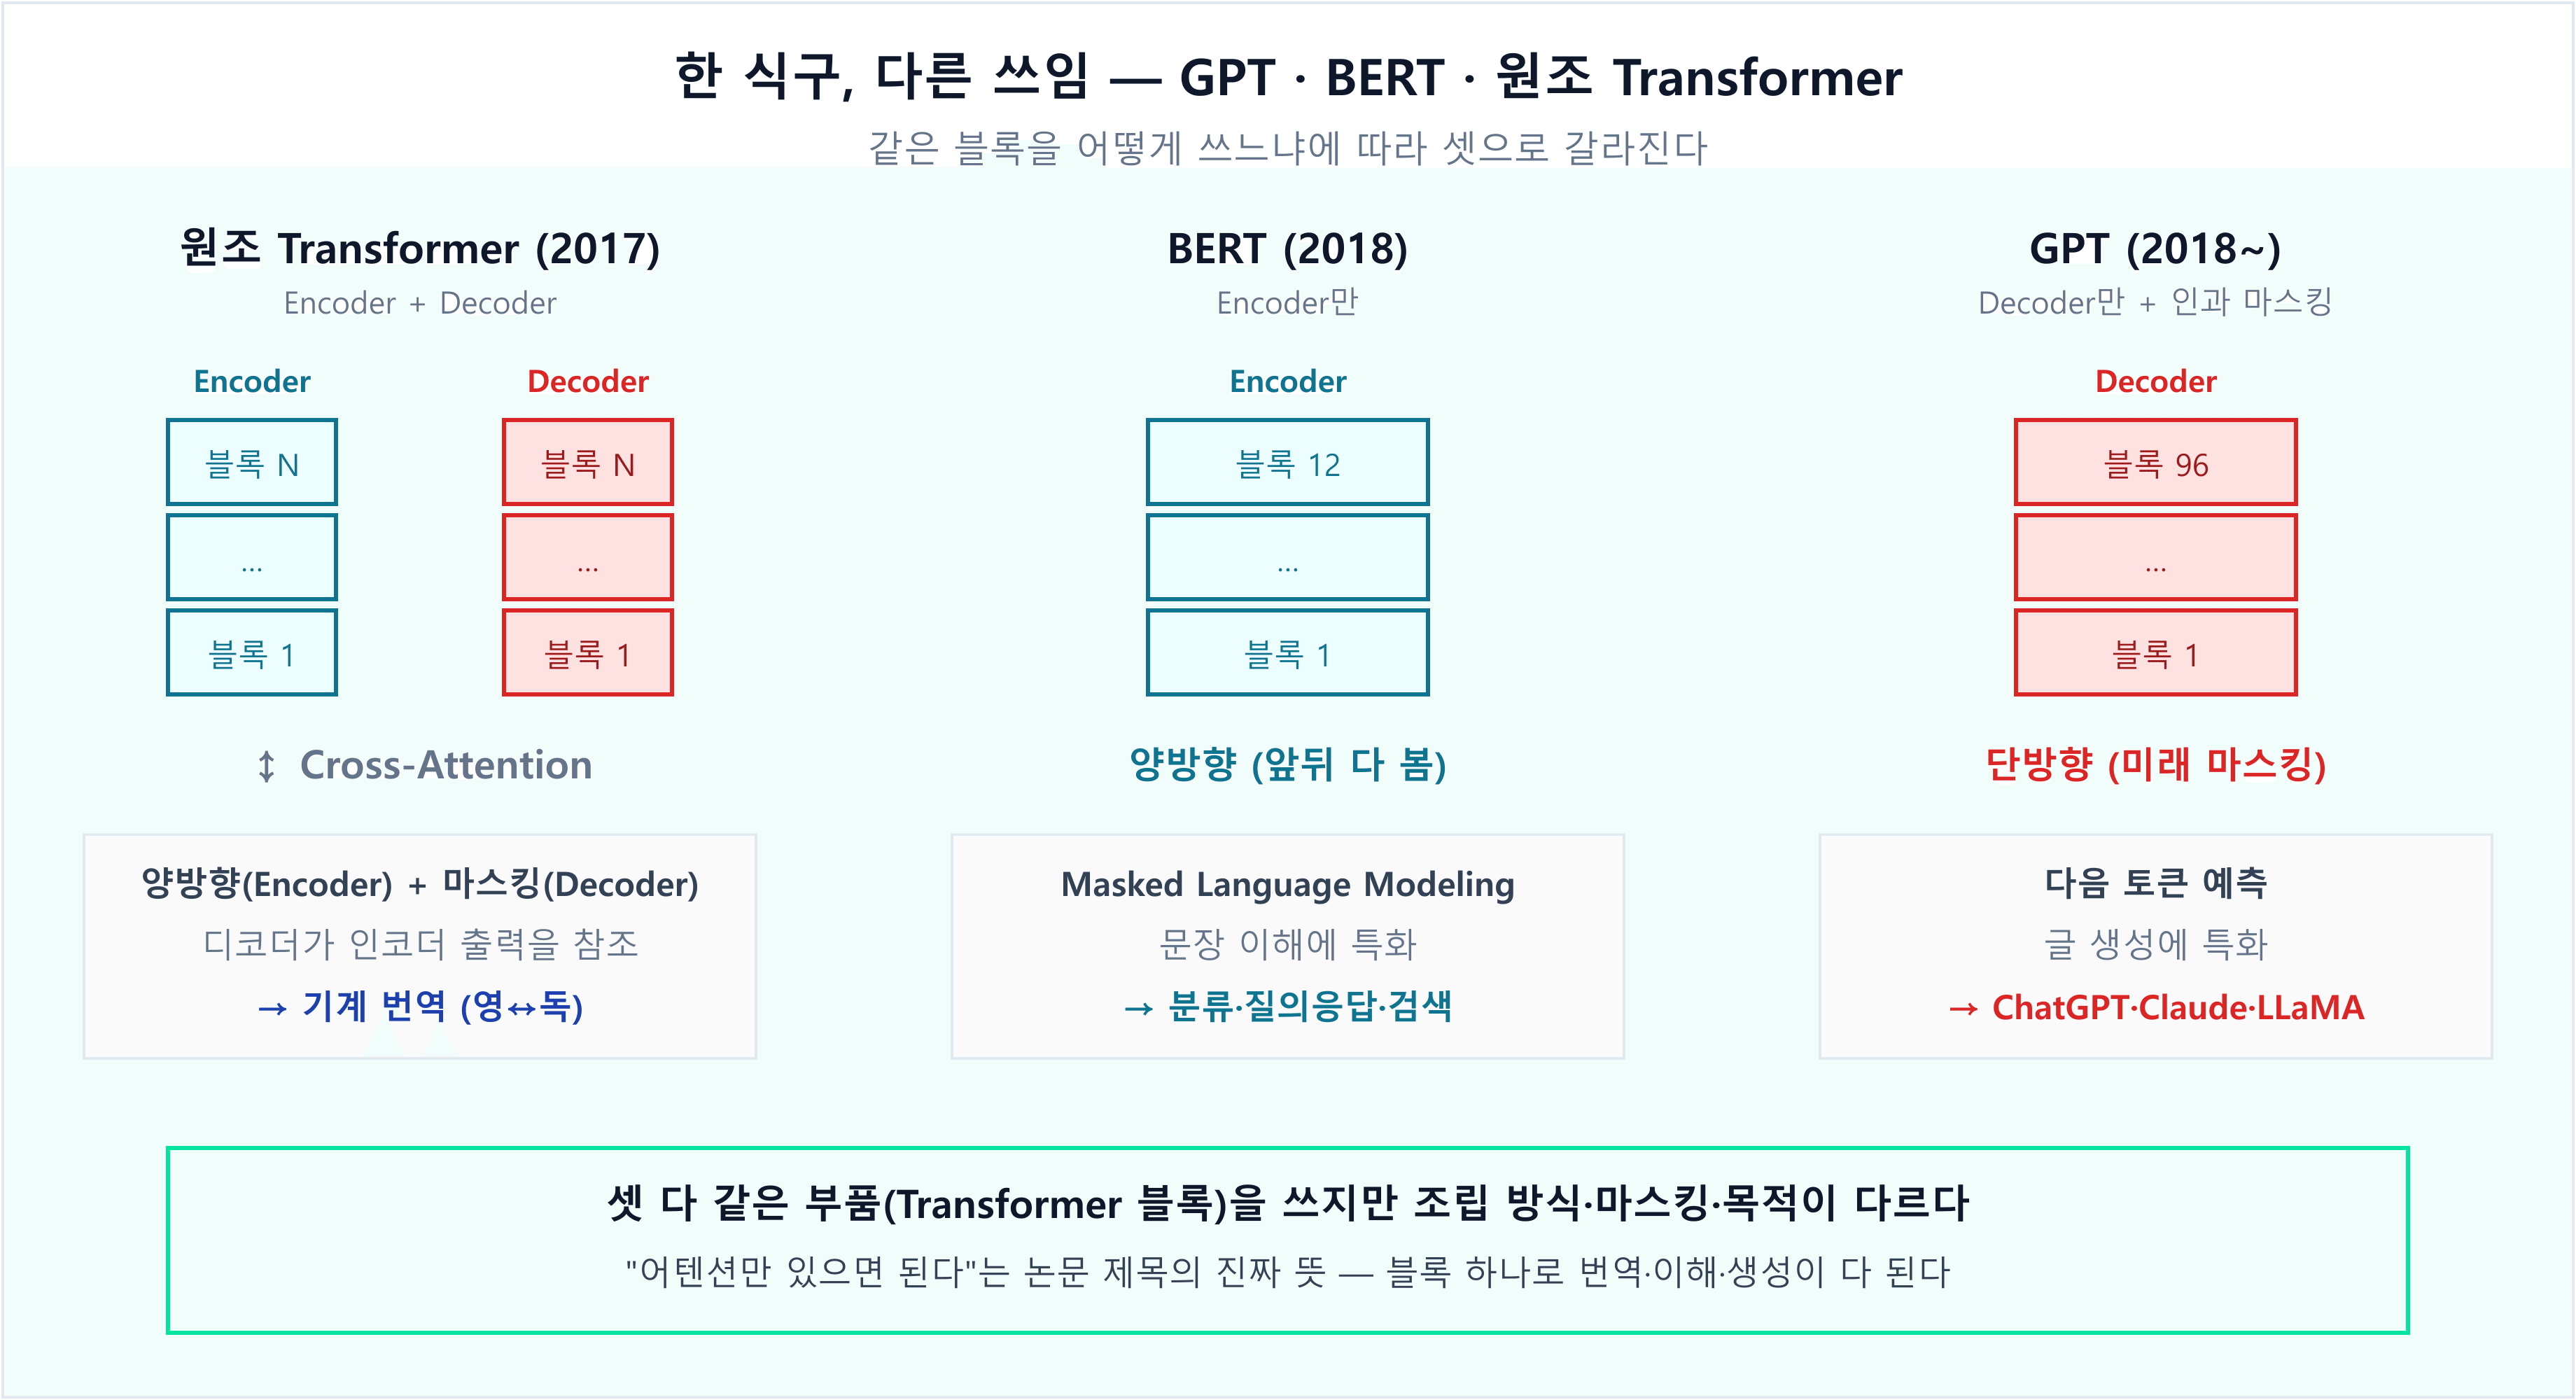
GPT 같은 생성 모델에는 한 가지 규칙이 더 붙어요. 다음 단어를 맞히는 훈련이니, 각 단어는 자기보다 뒤(미래)의 단어를 미리 보면 안 됩니다(컨닝 금지). 그래서 미래 단어로 향하는 어텐션을 가리는데, 이를 인과 마스킹(causal masking)이라고 해요. 맨 위 블록을 통과한 결과는 마지막에 Softmax를 거쳐 "다음 토큰은 무엇일까"의 확률이 됩니다 — 9편의 그 장면으로 정확히 이어지죠.
그래서 왜 "Attention Is All You Need"인가
사실 어텐션이라는 개념 자체는 2017년 이전에도 있었어요. 다만 그때는 RNN을 보조하는 장치였죠. 2017년 논문의 진짜 혁명은 "RNN도 CNN도 다 빼고, 어텐션만 남겨도 된다"를 증명한 데 있었어요. 제목 그대로, 필요한 건 어텐션뿐이었던 거예요.
이게 왜 그토록 중요했을까요? 병렬 처리 때문이에요. 순서대로 읽던 RNN과 달리, 어텐션은 모든 단어를 한 번에 계산해요. 덕분에 수천 개의 GPU로 동시에 학습할 수 있게 됐고, 모델과 데이터를 마음껏 키우는(scaling) 길이 열렸습니다. "더 키우면 더 똑똑해진다"는 LLM 시대의 공식이 바로 이 병렬성 위에서 가능해진 거예요.
🔗 시즌 1을 한 줄로 — 동전 던지기(확률) → 정규분포 → 베이즈 → 조건부 확률 → 로지스틱 회귀(가중합→확률) → ChatGPT 학습(다음 토큰 예측) → 그리고 오늘, 그 모든 걸 떠받친 Transformer. 작은 확률 한 조각이 어떻게 ChatGPT까지 이어지는지, 이제 한 줄로 연결되시나요?
✅ 30초 복습 — 오늘 배운 것
- ✔Transformer는 순차 처리 대신 병렬 처리를 한다.
- ✔핵심은 Self-Attention — 모든 단어가 서로를 동시에 바라본다.
- ✔Q · K · V로 단어 사이 관련도를 계산하고, 그 비중대로 정보를 섞는다.
- ✔Multi-Head로 여러 관점을 한 번에 본다 (원 논문 8개 헤드).
- ✔이 블록을 여러 층 쌓고 다음 토큰 예측으로 학습하면 GPT가 된다.
Transformer를 이론부터 체계적으로
넘스탯(NumStats) LLM 이론 학습에서는 토큰화·임베딩·Attention·Transformer·파인튜닝·프롬프트 엔지니어링까지
LLM의 핵심 이론을 실제 사례와 함께 단계별로 정리할 수 있습니다.
numlm.com/theory_large_language_model
한 발 더 들어가고 싶다면
시즌 1을 완주하셨어요! 다음 시즌에서 더 깊이 만나볼 주제들이에요.
- 11편 — 신경망과 역전파: 이 글의 "숫자를 조금씩 고친다"가 실제로 어떻게 일어나는지, 학습의 엔진을 해부합니다
- 13편 — Attention 메커니즘 완벽 이해: 오늘 직관으로 본 Q·K·V를 한 단계 더 깊이
- 14편 — RAG 완벽 가이드: 학습이 끝난 Transformer에 외부 지식을 붙이는 법
- 직접 만들기: NumStats 'LLM 처음부터 만들기'에서 Transformer 블록을 코드로 조립 (Chapter 3·4)
참고 자료
본문은 다음 표준 자료를 기준으로 작성했습니다.
- Vaswani et al. (2017) — "Attention Is All You Need" (NeurIPS). Transformer 원전. 멀티헤드·포지셔널 인코딩·인코더-디코더 구조와 어텐션 공식의 출처
- Bahdanau, Cho, Bengio (2015) — "Neural Machine Translation by Jointly Learning to Align and Translate". Transformer 이전, '어텐션' 개념을 처음 도입한 연구
- Radford et al. (2018·2019) — GPT / GPT-2. 디코더 전용 + 인과 마스킹 구조의 출처
- Devlin et al. (2019) — "BERT". 인코더 전용·양방향 모델의 대표 사례
- Jay Alammar — "The Illustrated Transformer". 그림으로 보는 가장 친절한 해설
- NumStats — LLM 이론 학습 / LLM 처음부터 만들기: numlm.com/theory_large_language_model
마무리 — 그리고 시즌 1을 닫으며
오늘 본 내용을 한 줄로 요약하면 이거예요. "문장의 모든 단어가 서로를 동시에 바라보며 관련도만큼 정보를 섞는다 — 그게 어텐션이고, 그걸 쌓은 게 Transformer다." 무서운 수식처럼 보이던 것도, 결국 8편의 "가중합 → 확률" 한 골격의 변주였을 뿐이에요.
이렇게 시즌 1이 마무리됩니다. "확률을 모르고 AI 시대를 살 수 있을까?"라는 질문에서 출발해, 동전 한 닢의 확률에서 ChatGPT의 뼈대까지 한 줄로 이어왔어요. 여기까지 따라오신 여러분은 이제 AI 뉴스를 들을 때 "아, 저건 어텐션을 키운 거구나" "저건 정렬을 손본 거구나"라며 구조로 읽어낼 수 있습니다.
그리고 그 출발점은, 동전 한 닢의 확률이었습니다.
시즌 2에서, 더 깊은 이야기로 다시 만나요. — 넘스탯(NumStats)
넘스탯(NumStats) — 확률부터 LLM까지, 원리부터 제대로 배우는 자기주도 학습 플랫폼
#NumStats #넘스탯 #Transformer #트랜스포머 #Attention #어텐션 #SelfAttention #멀티헤드 #GPT #AttentionIsAllYouNeed #LLM #딥러닝
※ 이 글은 LLM 도구를 활용해 초안을 작성한 뒤, 학술 출처와 수치 정확성은 발행 전 직접 검증·편집했습니다. 본문에 사실과 다른 부분을 발견하시면 댓글로 알려주시면 즉시 반영하겠습니다.