ChatGPT는 어떻게 만들어지나요? | NumStats — 사전학습·SFT·RLHF 완벽 정리
인터넷의 모든 글을 읽힌 다음, 사람의 피드백으로 예의를 가르친다 — ChatGPT가 만들어지는 과정을 8단계로 끊어, 중·고생도 이해할 수 있게 풀어봅니다.
LLM 입문·사전학습 · RLHF·10분 읽기
지난 8편에서 로지스틱 회귀를 두고 "입력을 가중합한 뒤 0~1 사이 확률로 짜내는 도구"라고 했어요. 그리고 마지막에 이렇게 약속했죠. "이 단순한 도구가 거대하게 쌓이면 ChatGPT가 된다"고요.
오늘 그 약속을 지킬 차례예요. 그런데 막상 "ChatGPT는 어떻게 만들어지나요?"라고 물으면, 답이 한 단어로 안 나와요. 모델 하나를 학습시키는 게 아니라, 여러 단계를 차례로 거쳐 "사람처럼 대답하는 조수"로 길들이는 과정이기 때문이에요.
인터넷을 읽고 → 모범 답안을 따라 하고 → 사람의 평가로 다듬어진
긴 '교육 과정'의 결과물입니다."
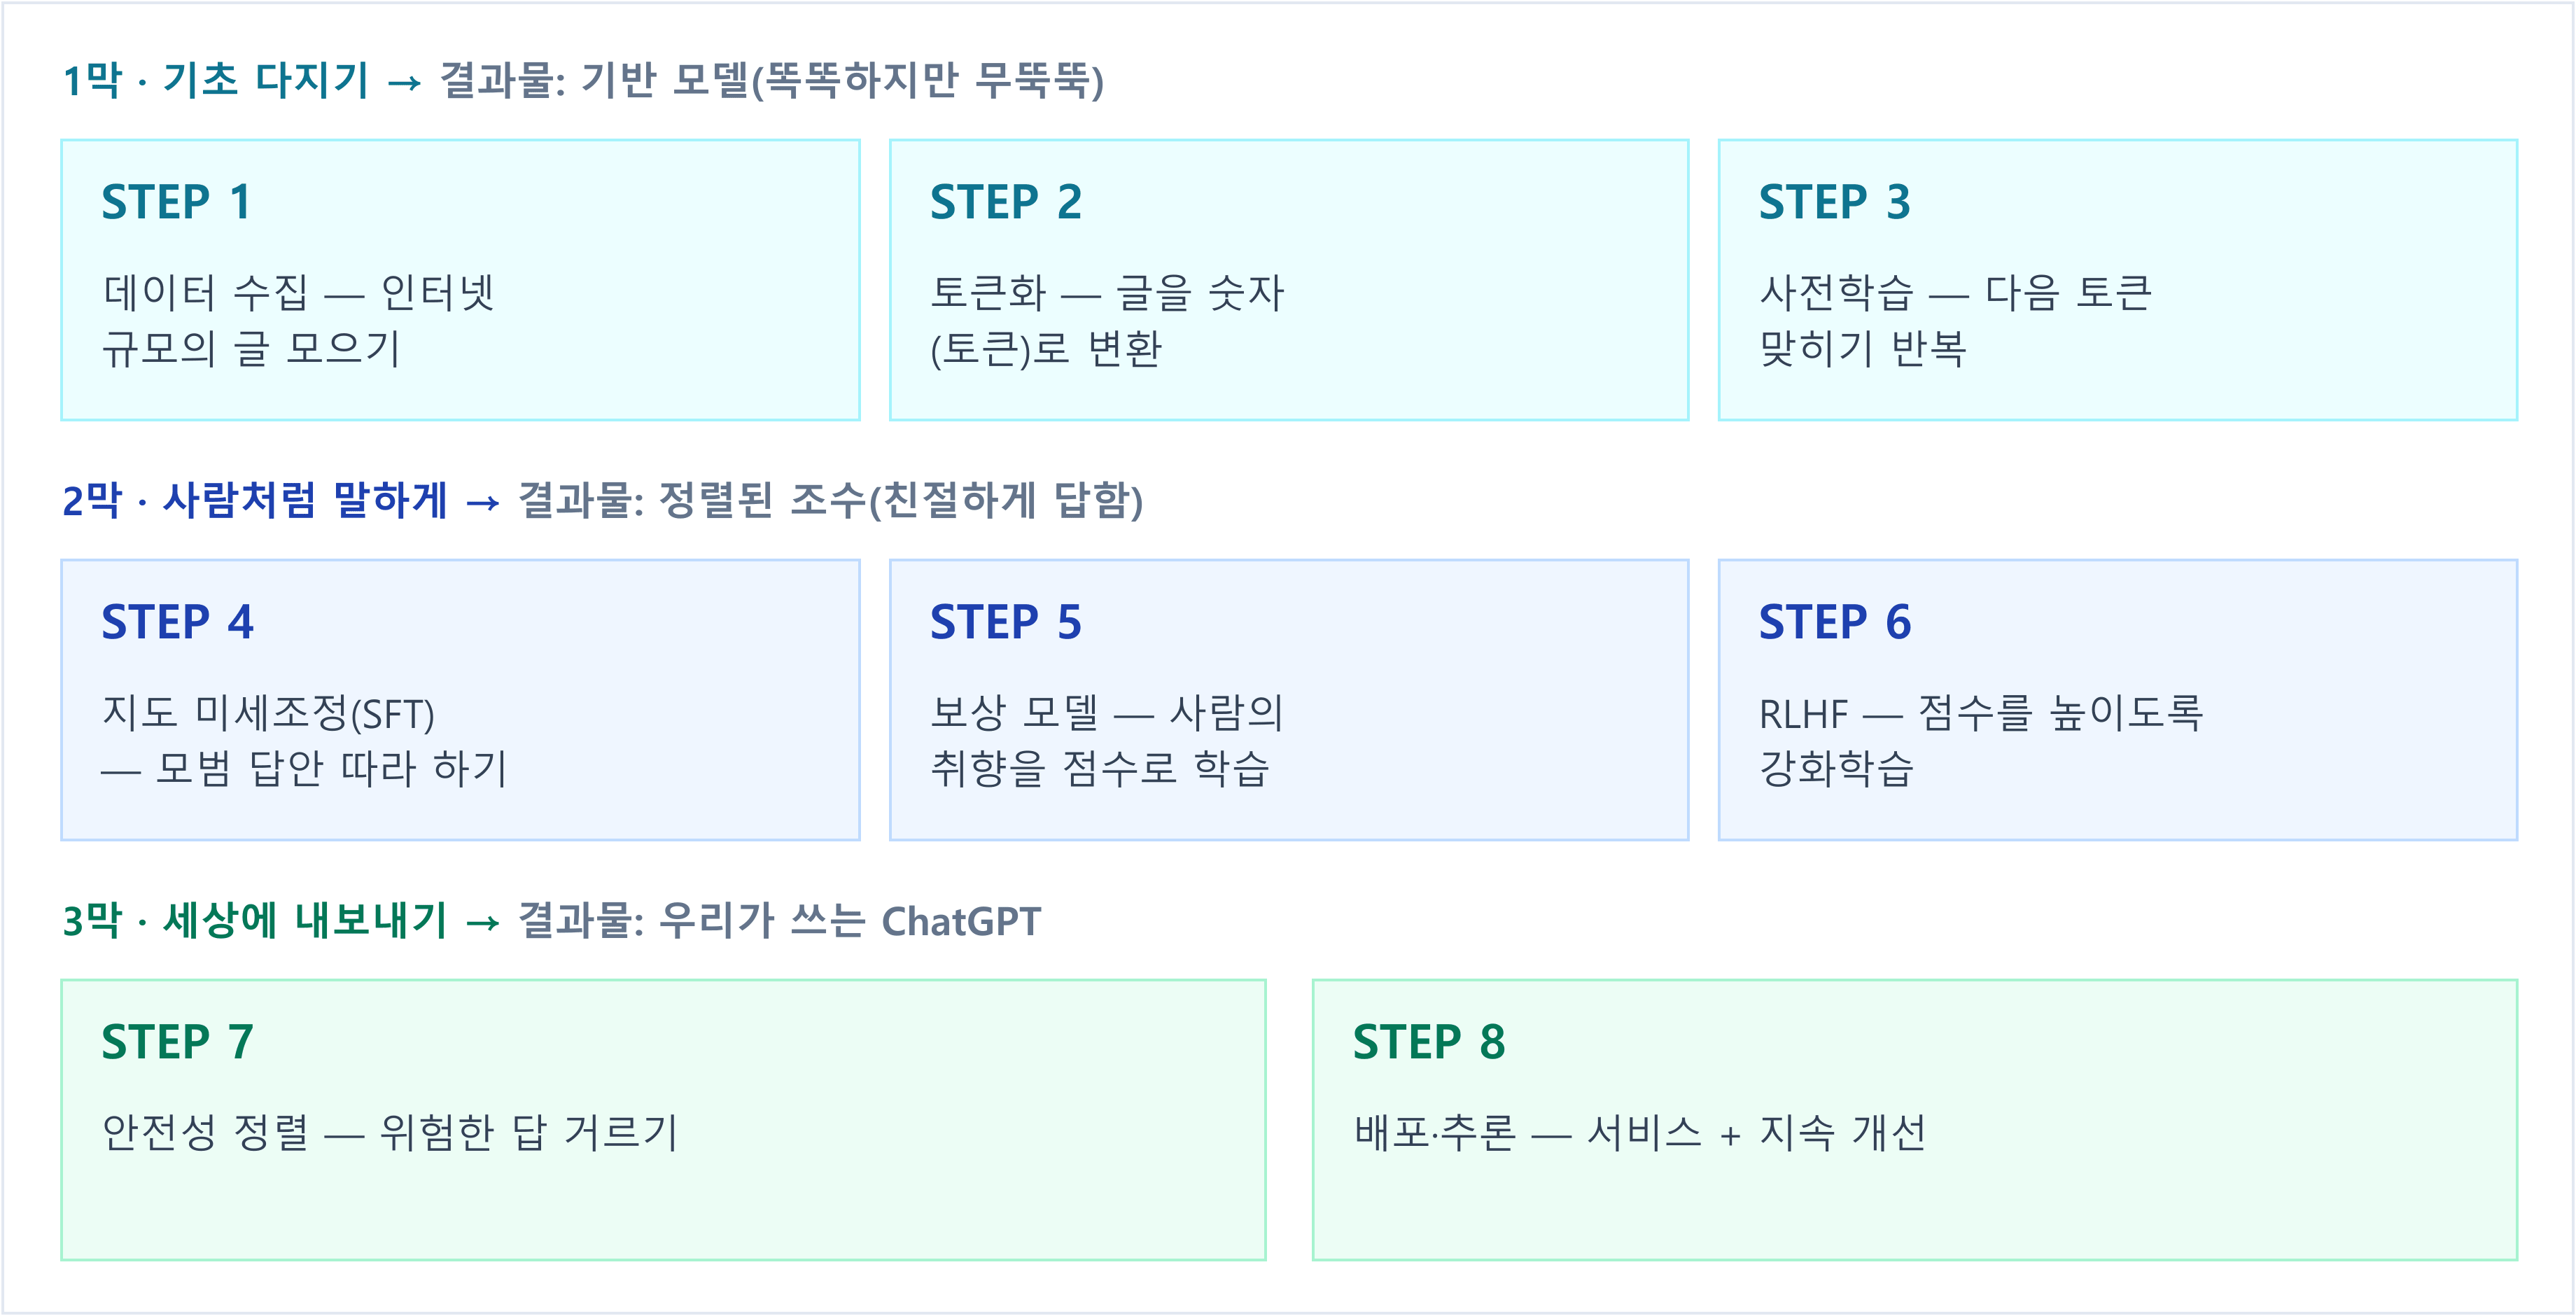
그 교육 과정을 NumStats는 8단계로 끊어 설명합니다. 크게 보면 세 막(幕)이에요. ① 기초 다지기(데이터·토큰화·사전학습) → ② 사람처럼 말하게 만들기(SFT·보상 모델·RLHF) → ③ 세상에 내보내기(안전성·배포). 하나씩 풀어볼게요.
먼저 솔직하게 — OpenAI는 ChatGPT의 정확한 데이터·파라미터 수·세부 설정을 공개하지 않았어요. 다만 그 뼈대가 된 InstructGPT 논문(2022)과 ChatGPT 출시 공지(2022년 11월)에서 "어떤 방법으로 학습했는지"는 분명히 밝혔습니다. 이 글은 공개된 그 레시피를 기준으로 설명하며, 추정치에는 "약·추정" 표시를 붙였습니다.
🎬 영상으로 먼저 보기 · 4분
LLM 이해하기 — 4분이면 전체 그림이 잡힙니다
아래 8단계를 읽기 전에, LLM이 무엇이고 어떻게 만들어지는지 큰 그림을 4분 만에 잡아보세요. NumStats 'LLM 처음부터 만들기' 시리즈의 첫 화(EP01)입니다.
전체 지도 — ChatGPT가 만들어지는 8단계
세부 설명에 들어가기 전에 큰 그림부터 한 장으로 봅시다. 각 단계가 무엇을 만들어 다음 단계에 넘기는지 화살표로 따라가 보세요.
STEP 1 / 8데이터 수집 — 인터넷이라는 거대한 교과서
모든 것은 읽을거리에서 시작해요. 위키백과, 책, 뉴스, 블로그, 토론 게시판, 코드 저장소까지 — 인터넷 규모의 방대한 텍스트를 모읍니다. 단, 모은 그대로 쓰지는 않아요. 중복 문서를 지우고, 욕설·개인정보·저품질 글을 걸러내는 정제(cleaning) 과정을 거칩니다.
왜 이렇게 공들일까요? 머신러닝의 오래된 격언 그대로예요. "쓰레기를 넣으면 쓰레기가 나온다(Garbage In, Garbage Out)." 모델이 읽는 글의 질이 곧 모델의 상식의 질이 됩니다.
📊 감 잡기 — ChatGPT의 조상 격인 GPT-3는 공개 논문 기준 약 3,000억 개(300B) 토큰 규모의 텍스트로 학습됐어요. 토큰을 대략 단어 조각이라고 보면, 사람이 평생 읽어도 못 읽을 양을 단 한 모델이 통과한 셈입니다. (ChatGPT 자체의 데이터 규모는 비공개)
STEP 2 / 8토큰화 — 글자를 숫자로 바꾸기
중요한 사실 하나. 모델은 글자를 읽지 못해요. 신경망은 숫자만 다루는 계산기예요. 그래서 글을 잘게 쪼갠 조각, 즉 토큰(token)으로 나누고 각 토큰에 고유 번호를 붙입니다. 이 과정이 토큰화(tokenization)예요.
토큰은 꼭 단어 하나가 아니에요. 자주 쓰는 조각은 통째로, 드문 단어는 더 잘게 쪼개는 BPE(Byte Pair Encoding) 방식을 많이 씁니다. 예를 들어 "playing"은 "play" + "ing"처럼 둘로 나뉠 수 있어요. 덕분에 사전(vocabulary)은 작게 유지하면서도 처음 보는 단어까지 표현할 수 있습니다.
한 문장이 모델 눈에 보이는 모습
"넘스탯은 재미있다" → [넘, 스탯, 은, 재미, 있다] → [1827, 9043, 12, 5521, 880]
※ 위 토큰 분리와 번호는 개념을 보여주기 위한 예시예요. 실제 분리 방식과 번호는 모델이 쓰는 토크나이저마다 다릅니다. 토큰화를 더 깊이 보고 싶다면 NumStats 'LLM 처음부터 만들기' Chapter 2에서 다룹니다.
STEP 3 / 8사전학습 — 다음 단어 맞히기를 수억 번 반복
이제 핵심입니다. 사전학습(Pretraining)에서 모델이 하는 일은 놀랍도록 단순해요. "앞 문장을 보고 다음 토큰을 맞혀라." 딱 이 한 가지를, 수집한 글 전체에 대해 수억·수십억 번 반복합니다.
→ 모델: '먹었다' 80% · '마셨다' 12% · '던졌다' 0.1% …
정답("먹었다")에 높은 확률을 주면 칭찬받고, 엉뚱한 답에 높은 확률을 주면 혼나면서 내부 숫자(가중치)를 조금씩 고쳐 나가요. 이렇게 빈칸을 메우는 연습만으로 모델은 문법, 사실, 추론, 심지어 코드까지 스스로 익힙니다. 정답을 사람이 일일이 달아줄 필요가 없어요 — 글 자체가 정답이거든요. 이걸 자기지도학습(self-supervised learning)이라고 불러요.
🔗 8편과 이어지는 지점 — "다음 토큰 맞히기"는 사실 수만 개 후보 중 하나를 고르는 거대한 분류 문제예요. 모델은 마지막에 Softmax로 사전 전체에 확률을 나눠줍니다. 8편의 Sigmoid가 "예/아니오" 두 갈래의 확률을 냈다면, Softmax는 수만 갈래의 확률을 내는 그 일반화 버전이에요. 즉 ChatGPT의 심장도 결국 "가중합 → 확률"이라는 8편의 골격 위에 서 있습니다.
사전학습이 끝나면 기반 모델(base model)이 완성돼요. 지식은 어마어마하지만, 아직 무뚝뚝합니다. "피자 만드는 법 알려줘"라고 물으면 친절히 답하는 게 아니라, 인터넷 어딘가에 있을 법한 글을 그냥 이어 써버려요. 예컨대 "…알려줘. 그리고 파스타 만드는 법도 알려줘."처럼요. 질문에 "답하는 법"은 아직 배우지 못한 상태입니다. 그래서 2막이 필요해요.
💸 왜 아무나 못 만들까 — 사전학습은 8단계 중 단연 가장 비싸고 오래 걸려요. 수천 개의 고성능 GPU를 수주~수개월 돌려야 하고, 비용은 수십억 원대 이상으로 추정됩니다. 거대 기업·연구소만 처음부터 학습할 수 있는 이유예요. (이후 단계들은 상대적으로 훨씬 저렴합니다.)
STEP 4 / 8지도 미세조정(SFT) — 모범 답안을 따라 하는 견습 기간
무뚝뚝한 기반 모델을 "질문에 답하는 조수"로 바꾸는 첫 단계가 지도 미세조정(SFT, Supervised Fine-Tuning)이에요. 방법은 의외로 사람 냄새가 나요. 사람이 직접 "이상적인 질문–답변 쌍(모범 답안)"을 다수 작성한 뒤, 모델에게 그 스타일을 따라 하게 가르칩니다.
비유하면 견습생 교육이에요. 요리는 이미 할 줄 아는(사전학습) 신입에게, 선배가 "손님이 이렇게 물으면, 이렇게 친절히 답하는 거야"라며 모범 응대를 보여주는 거죠. 모델은 그 예시들을 흉내 내며 "질문에는 답을 한다"는 형식을 익힙니다.
사전학습 vs SFT — 한 줄 비교
사전학습: 인터넷의 모든 글을 읽음 → 말재주(지식)를 얻음
SFT: 사람이 쓴 모범 답안만 따라 함 → 예의(대화 형식)를 얻음
STEP 5 / 8보상 모델 — 사람의 '취향'을 점수로 만들기
SFT까지 마친 모델은 답은 하지만, 아직 "더 좋은 답"과 "그저 그런 답"을 스스로 구분하진 못해요. 그렇다고 사람이 모델의 모든 답을 평생 채점할 수도 없죠. 그래서 기발한 우회로를 씁니다. 사람의 채점 취향을 흉내 내는 '자동 채점기'를 따로 만드는 거예요. 이것이 보상 모델(Reward Model)입니다.
만드는 법은 이래요. 같은 질문에 모델이 답변 후보를 여러 개 내놓으면, 사람이 좋은 순서대로 순위를 매깁니다(A > C > B …). 이렇게 모은 "사람의 선호 순위" 데이터를 가지고, 어떤 답변에든 점수를 매겨주는 별도의 모델을 학습시켜요.
보상 모델이 배우는 것
질문: "친구에게 사과하는 문자 써줘"
답변 A (따뜻하고 구체적) → 사람 평가 👍 → 보상 점수 높음
답변 B ("그냥 미안하다고 해") → 사람 평가 👎 → 보상 점수 낮음
이제 우리에겐 사람을 대신해 답변에 점수를 줄 수 있는 채점기가 생겼어요. 다음 단계에서 이 채점기를 코치로 삼습니다.
STEP 6 / 8RLHF — 사람의 피드백으로 다듬는 결정적 한 방
드디어 ChatGPT를 ChatGPT답게 만든 단계, RLHF예요. 풀어 쓰면 Reinforcement Learning from Human Feedback — 사람의 피드백으로부터 하는 강화학습입니다. (7편 퀴즈에 나온 그 'H = Human'이 바로 여기예요.)
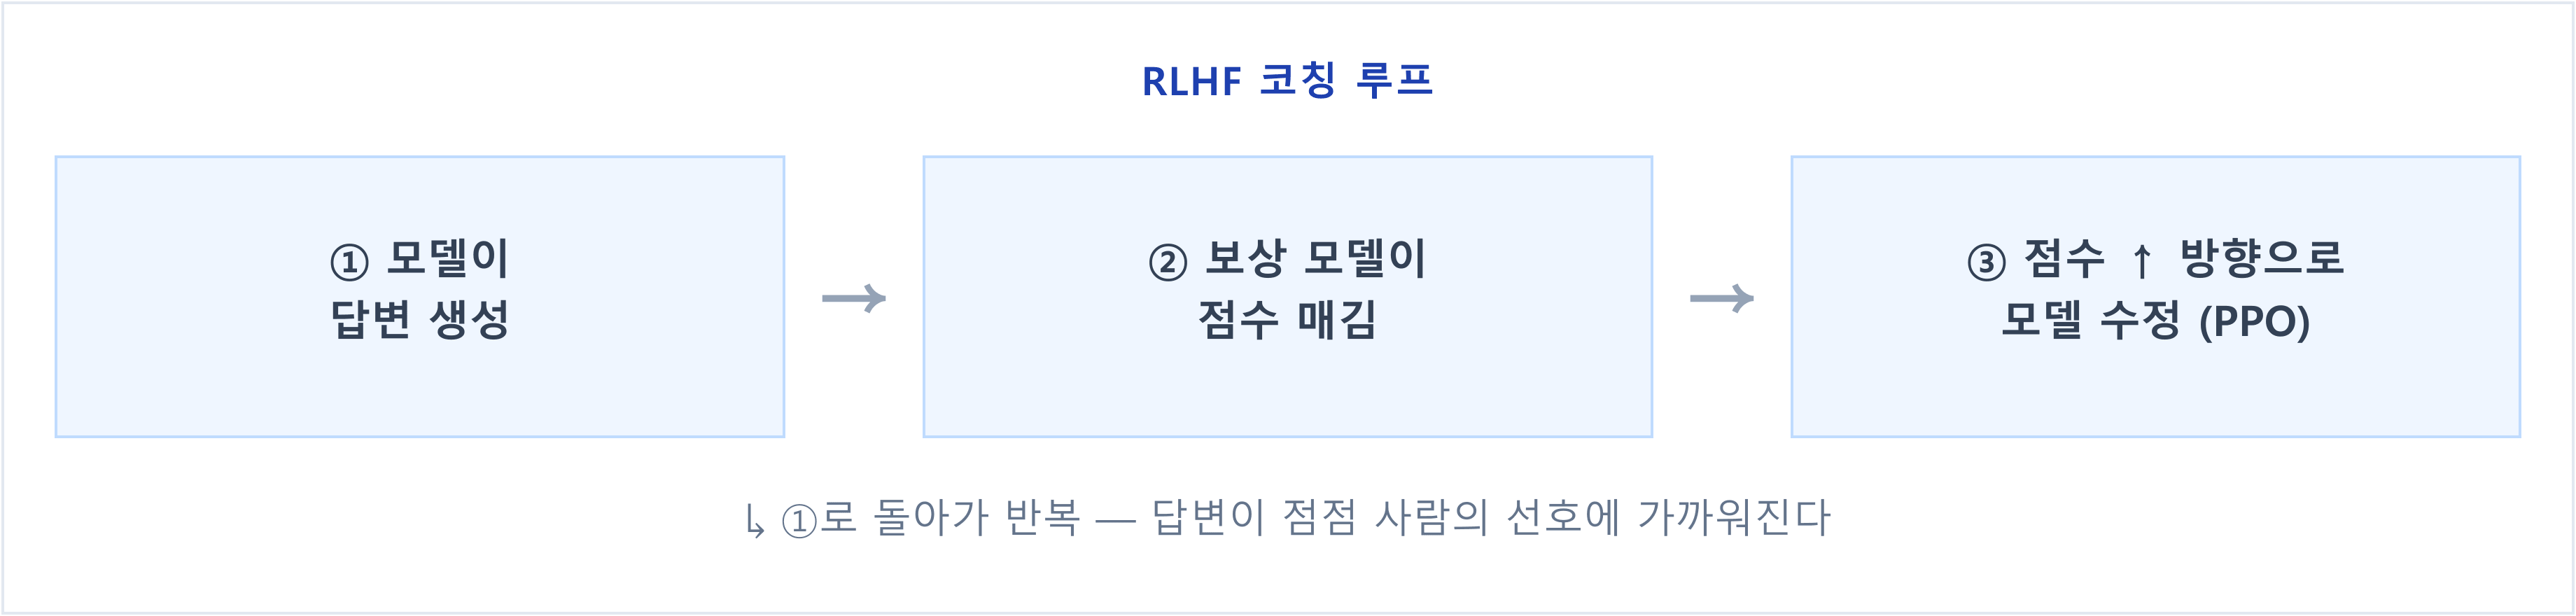
원리는 코칭 루프예요. ① 모델이 질문에 답을 한다 → ② STEP 5의 보상 모델이 그 답에 점수를 매긴다 → ③ 점수가 높아지는 방향으로 모델을 조금씩 수정한다. 이 과정을 끝없이 반복하면, 모델은 점점 "사람이 좋아할 만한 답"을 스스로 내놓게 됩니다. 이때 모델을 업데이트하는 대표적 알고리즘이 PPO(Proximal Policy Optimization)예요.
한 가지 안전장치가 있어요. 점수만 좇다 보면 모델이 점수는 높지만 이상한 답(예: 의미 없이 칭찬만 늘어놓기)으로 새는 '꼼수'를 부릴 수 있어요. 그래서 원래의 SFT 모델에서 너무 멀어지지 않도록 제동을 거는 장치(KL 페널티)를 함께 둡니다. "더 잘하되, 원래 성격은 잃지 마"라는 안전벨트인 셈이에요.
💡 왜 이 단계가 결정적이었나 — 같은 GPT-3급 모델이라도, RLHF로 다듬은 버전이 훨씬 더 도움이 되고 거짓·유해한 답이 적다고 OpenAI는 InstructGPT 연구에서 보고했어요. 놀라운 점은, RLHF로 다듬은 훨씬 작은 모델의 답을 사람들이 다듬지 않은 거대 모델의 답보다 더 선호했다는 것. "크기보다 정렬(alignment)"이라는 교훈이 여기서 나왔습니다.
STEP 7 / 8안전성 정렬 — "그건 도와줄 수 없어요"를 가르치기
똑똑하고 친절한 것만으로는 부족해요. 폭탄 제조법, 혐오 표현, 개인정보 유출 같은 위험한 요청은 거절할 줄 알아야 합니다. 그래서 전문가들이 일부러 모델을 공격적으로 떠보며 약점을 찾는 레드티밍(red-teaming)을 하고, 그렇게 찾은 위험 사례에 대해 "이건 도와줄 수 없어요"라고 답하도록 추가로 가르칩니다.
※ 사실 안전성은 깔끔하게 떨어진 '7번째 단계'라기보다, SFT와 RLHF 전반에 녹아 있는 목표예요. 이해를 돕기 위해 따로 떼어 설명했습니다. 또한 RLHF만이 정렬의 유일한 방법은 아니에요 — Anthropic의 Constitutional AI(원칙 기반 자기 교정)나 DPO 같은 더 단순한 대안도 활발히 쓰입니다.
이 단계가 바로 시즌 1 로드맵에서 예고한 "AI 안전성과 정렬(alignment)"의 핵심이에요. 모델의 능력을 사람의 가치와 의도에 맞추는 일, 그게 정렬입니다.
STEP 8 / 8배포·추론 — 세상에 내보내고, 계속 배우기
학습이 끝난 모델을 실제로 쓰는 단계가 추론(inference)이에요. 우리가 질문을 입력하면, 모델은 배운 대로 토큰을 하나씩 이어 붙이며 답을 만들어 갑니다. 이때 Temperature(창의력 다이얼)나 Top-k(후보 제한) 같은 설정으로 답의 무작위성을 조절해요.
그리고 끝이 아니에요. 사용자들의 평가(👍/👎)와 상호작용은 다시 다음 버전을 개선하는 재료가 됩니다. 또 모델이 모르는 최신 정보나 사실 확인이 필요한 질문에는, 외부 문서를 먼저 검색해 근거로 삼는 RAG(검색 증강 생성)를 붙여 약점을 보완하죠.
⚠️ 끝까지 남는 한계 — 할루시네이션 — 이 모든 단계를 거쳐도 LLM은 "사실인지"가 아니라 "그럴듯한지"를 기준으로 다음 토큰을 고르는 기계예요. 그래서 없는 내용을 자신 있게 지어내는 환각(hallucination)이 구조적으로 남습니다. 출처를 요구하고, 중요한 정보는 교차 검증하는 습관이 필요한 이유예요.
한 문장으로 복기하기
8단계를 한 호흡에 꿰어 볼게요.
모범 답안을 따라 하게 한 다음(4), 사람의 취향을 점수로 만들어(5) 그 점수로 다듬고(6) →
위험한 답을 거르도록 정렬한 뒤(7), 세상에 내보내 계속 배운다(8).
핵심 통찰은 이거예요. ChatGPT의 능력은 두 종류의 학습이 합쳐진 결과예요. 지식은 인터넷에서(1~3막의 사전학습), 태도는 사람에게서(4~7막의 SFT·RLHF) 왔습니다. 그래서 ChatGPT는 "인류가 쓴 글"과 "사람의 피드백"이 함께 빚어낸 합작품인 셈이에요.
LLM을 한 줄씩, 직접 만들어 보고 싶다면
이 글이 "큰 지도"였다면, 넘스탯(NumStats) LLM 처음부터 만들기는 그 지도를 한 걸음씩 걷는 코스예요.
토큰화 · 어텐션 · GPT 조립 · 사전학습 · 파인튜닝까지 8개 챕터로, 퀴즈와 함께 차근차근 익힐 수 있습니다.
numlm.com/llm-from-scratch
한 발 더 들어가고 싶다면
ChatGPT 학습의 큰 그림을 잡았다면, 다음으로 만나볼 만한 주제들이에요.
- 8편 — 로지스틱 회귀: "가중합 → 확률"이라는, 사전학습의 다음 토큰 예측까지 이어지는 가장 작은 부품
- 다음 10편 — Transformer 구조 쉽게 설명: 이 글에서 "신경망"이라고 뭉뚱그린 그 안쪽, Attention이라는 심장을 직접 열어봅니다
- RAG와 할루시네이션: 학습이 끝난 모델의 약점을 외부 지식으로 메우는 법 (시즌 2)
- AI 안전성과 정렬: RLHF가 왜 ChatGPT를 만든 진짜 열쇠였는지 깊이 들여다보기 (시즌 4)
참고 자료
본문의 학습 절차는 OpenAI가 공개한 다음 원자료를 기준으로 작성했습니다.
- OpenAI (2022) — "Introducing ChatGPT" (openai.com 출시 공지). ChatGPT가 InstructGPT와 "동일한 방법(RLHF)이되 데이터 수집 방식에 약간의 차이를 둬" 학습됐음을 밝힌 1차 자료
- Ouyang et al. (2022) — "Training language models to follow instructions with human feedback" (InstructGPT 논문). SFT → 보상 모델 → PPO의 3단계 레시피 원전
- Christiano et al. (2017) — "Deep Reinforcement Learning from Human Preferences". RLHF의 출발점이 된 연구
- Brown et al. (2020) — "Language Models are Few-Shot Learners" (GPT-3 논문). 사전학습 데이터 규모(약 3,000억 토큰)와 1,750억 파라미터의 출처
- Vaswani et al. (2017) — "Attention Is All You Need". 모든 현대 LLM의 골격인 트랜스포머 원전 (10편에서 다룸)
- NumStats — LLM 처음부터 만들기: numlm.com/llm-from-scratch (8개 챕터 · 43개 에피소드)
마무리
ChatGPT는 마법이 아니라 차곡차곡 쌓인 8단계의 결과물이에요. 인터넷을 읽혀 상식을 만들고(사전학습), 사람의 모범과 피드백으로 태도를 다듬는다(SFT·RLHF) — 이 두 축만 기억하면, 앞으로 어떤 새 모델 소식을 들어도 "아, 이건 사전학습을 키운 거구나" "이건 정렬을 손본 거구나"라며 정리할 수 있습니다.
다음 10편에서는 이 모든 단계의 무대였던 신경망, 그 안쪽의 Transformer를 열어볼게요. "Attention is All You Need"라는 도발적인 제목이 무슨 뜻인지, 함께 풀어봅시다.
나머지 절반은 사람의 피드백에서 왔습니다.
넘스탯(NumStats)에서 다음 글로 만나요.
넘스탯(NumStats) — 확률부터 LLM까지, 원리부터 제대로 배우는 자기주도 학습 플랫폼
#NumStats #넘스탯 #ChatGPT #챗지피티 #LLM #거대언어모델 #사전학습 #RLHF #파인튜닝 #인공지능학습원리 #GPT
※ 이 글은 LLM 도구를 활용해 초안을 작성한 뒤, 학술 출처와 수치 정확성은 발행 전 직접 검증·편집했습니다. ChatGPT의 비공개 내부 사항은 공개된 InstructGPT 레시피를 기준으로 설명했으며, 추정치는 본문에 명시했습니다. 사실과 다른 부분을 발견하시면 댓글로 알려주시면 즉시 반영하겠습니다.