로지스틱 회귀 쉽게 이해하기 | 넘스탯(NumStats) — Sigmoid와 이진 분류의 모든 것
합격할까, 떨어질까? 스팸일까, 정상일까? — 매일 일어나는 '예/아니오' 결정 뒤에 숨은 단 하나의 수학, 로지스틱 회귀(Logistic Regression)를 풀어봅니다.
머신러닝 입문·이진 분류·8분 읽기
지난 7편에서 "머신러닝 모델이 배우는 것은 P(정답 | 입력)"이라고 했어요. 모델은 입력을 받아 "정답일 확률"을 출력하는 함수라는 얘기였죠.
그런데 호기심 많은 분이라면 자연스럽게 물을 거예요. "그래서 그 확률을 실제로 어떻게 구하는데요?" 92%, 78% 같은 숫자가 도대체 어디서 나오는 걸까요?
로지스틱 회귀(Logistic Regression)입니다."
이름은 어려워 보이지만, 핵심 아이디어는 놀랍도록 간단해요. 입력값들을 적당히 더하고, 그 결과를 0과 1 사이의 확률로 짜내는 함수에 넣으면 끝. 92%, 78% 같은 출력이 단 두 단계로 만들어집니다. 그 "짜내는 함수"가 어떤 모양인지는 잠시 후 만나볼게요.
오늘은 합격 확률·진단 확률·스팸 확률이 모두 이 한 가지 도구로 계산된다는 사실을 풀어보겠습니다. 수식 외우기 없이, 직관으로요. 그 전에, 모두를 헷갈리게 하는 그 이름부터 풀고 가죠.
이름부터 풀고 가자 — ‘로지스틱’과 ‘회귀’의 진짜 뜻
로지스틱 회귀는 이름만 보면 이 글에서 가장 어렵게 느껴져요. 그런데 사실 이 이름은 내용을 잘 설명하지 못하는 대표적인 사례예요. 본론에 들어가기 전에 두 단어만 풀어두면, 이후 모든 설명이 거짓말처럼 쉽게 읽힙니다.
‘로지스틱(Logistic)’ — 논리(logic)가 아니에요
많은 분이 logic(논리)을 떠올리지만, 전혀 관계없어요. 방금 언급한 그 S자 곡선의 고유한 이름, 즉 로지스틱 함수(logistic function)에서 그대로 따온 말일 뿐이에요. 깊은 뜻을 찾을 필요 없이 “S자 곡선을 쓰는” 정도로 이해하면 충분합니다.
‘회귀(Regression)’ — ‘돌아감’이 아니에요
진짜 함정은 여기예요. ‘회귀’는 한자로 ‘돌아감(回歸)’인데, 예측·분류와 무슨 상관일까요? 결론부터 말하면 이름이 잘못 붙은 역사적 사고라서, 글자 뜻에서 의미를 캐려 하면 영원히 안 풀려요.
유래는 19세기 통계학자 골턴(Francis Galton)에게 있어요. 그는 “키 큰 부모의 자녀는 부모만큼 크지 않고 평균 쪽으로 되돌아간다(regress)”는 현상을 연구하며 두 변수의 관계를 직선으로 그었어요. 그런데 후대 학자들이 그 ‘직선을 긋는 방법’ 전체를 그냥 ‘회귀’라고 불러버린 거예요. 정작 ‘돌아감’이라는 원래 뜻은 떨어져 나가고, 지금은 “입력으로 숫자를 예측하는 식”이라는 의미만 화석처럼 남았죠.
그러니 가장 실용적인 해법은 이거예요. ‘회귀’를 머릿속에서 ‘예측’으로 바꿔 읽으세요. 로지스틱 회귀가 하는 일도 딱 그거예요. ‘합격/불합격’을 곧장 정하지 않고, 먼저 “합격 확률 0.87” 같은 숫자를 예측한 뒤, 그 확률을 일정 기준(보통 0.5)으로 잘라 비로소 ‘분류’합니다.
한 줄로 정리하면 → 로지스틱 회귀 = “S자 곡선으로 확률을 예측하는 모델”. 속은 회귀(확률을 예측), 겉은 분류(예/아니오로 자름)인 셈이에요. 이 한 줄을 깔고 아래를 읽으면 모든 게 맞아떨어집니다.
STEP 1 / 5선형 회귀로는 왜 안 될까? — 확률의 범위 문제
먼저 기초부터. 공부 시간이 늘면 합격 확률이 오른다는 건 누구나 압니다. 그럼 단순하게 "공부 시간 × 가중치 + 상수 = 합격 확률"이라고 쓰면 될까요?
이게 바로 선형 회귀(Linear Regression)예요. 그런데 한 가지 치명적 문제가 있어요.
예를 들어 공부 시간 0시간에 합격 확률 -0.1, 공부 시간 1,000시간에 합격 확률 5.2 같은 결과가 나옵니다. 음수 확률? 500%? 이런 숫자는 확률로서 의미가 없어요. 확률은 반드시 0과 1 사이에 있어야 합니다.
그래서 우리에게 필요한 건 "어떤 실수가 들어와도 결과를 0~1 사이로 짜내주는" 마법 같은 함수입니다. 그 함수가 다음에 만날 Sigmoid예요.
STEP 2 / 5Sigmoid 함수 — 모든 숫자를 확률로 바꾸는 S자 곡선
Sigmoid는 "그리스 문자 시그마(σ)를 닮은"이라는 뜻이에요. 소문자 종형 시그마(ς)가 S처럼 생긴 데서 온 이름으로, 이름 그대로 S자처럼 생긴 곡선이고 정의는 한 줄입니다.
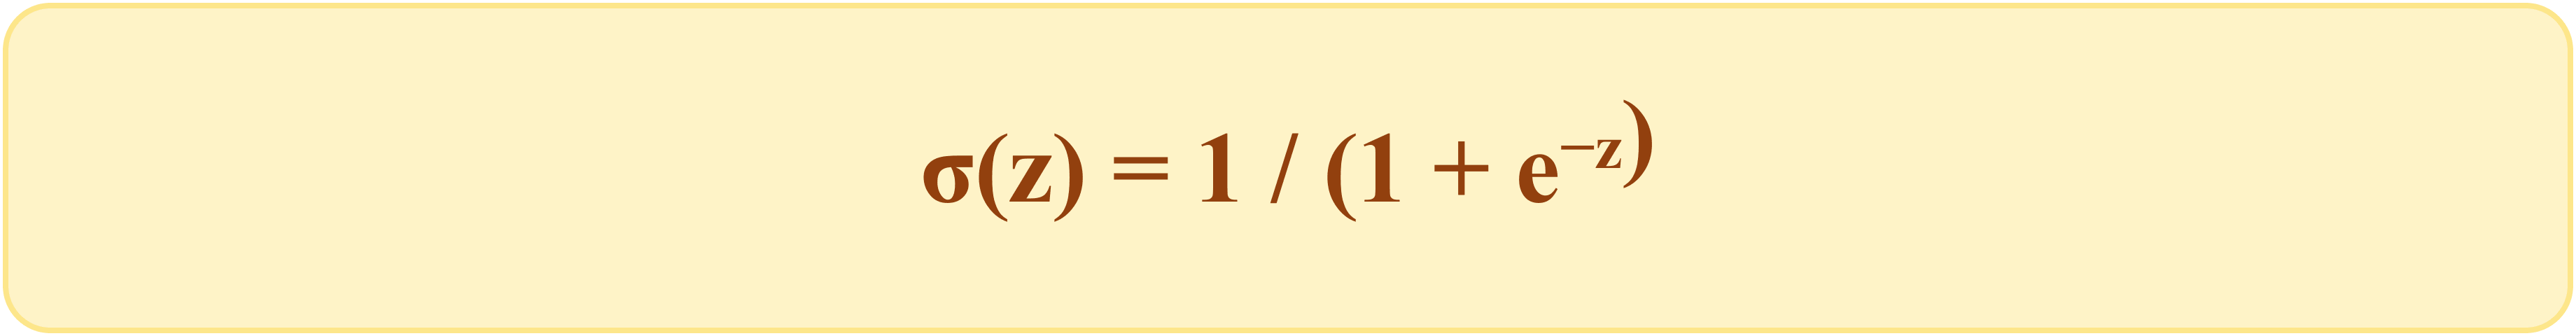
수식이 무서워 보여도 의미만 보면 단순해요. 입력 z를 받아 0과 1 사이의 값을 출력합니다. 그게 전부예요. 차트로 보면 이렇게 생겼습니다.
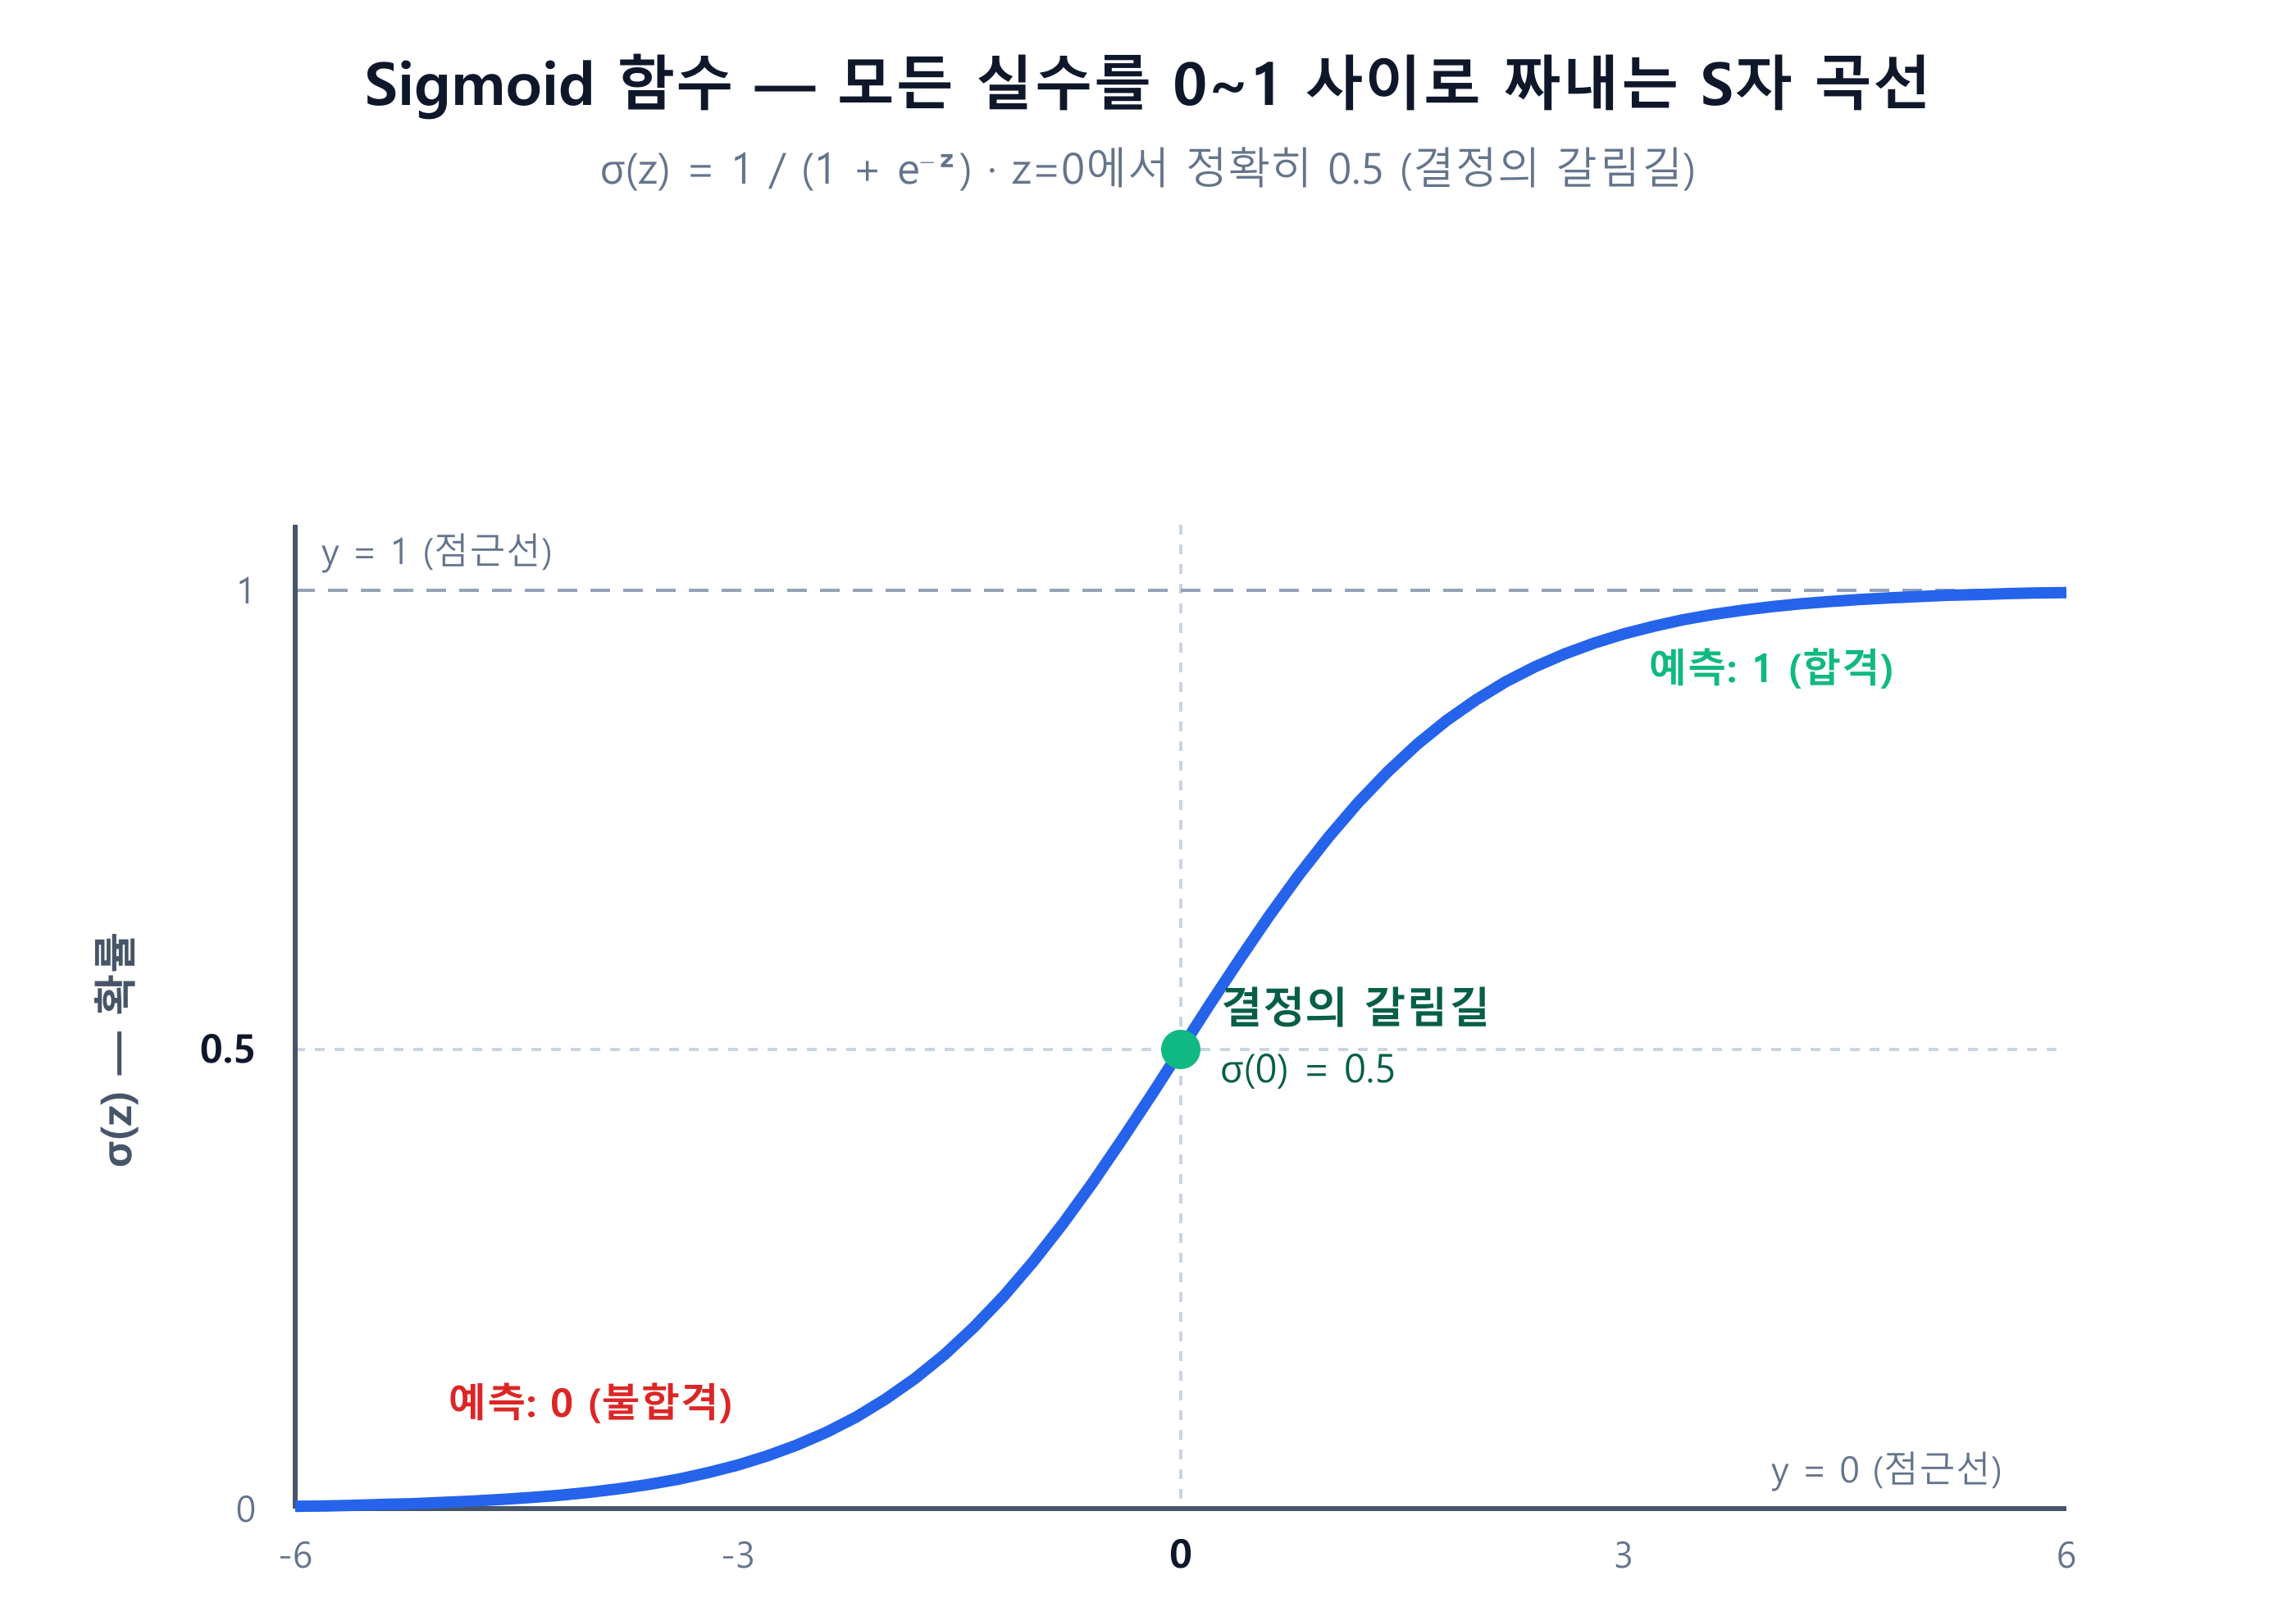
주목할 세 가지가 있어요.
- z = 0일 때 σ = 0.5 — 정중앙, 결정의 갈림길
- z가 커질수록 σ는 1에 가까워짐 (양의 무한대 → 1)
- z가 작아질수록 σ는 0에 가까워짐 (음의 무한대 → 0)
다시 말해, Sigmoid는 "확률 게이트"예요. 어떤 실수가 들어와도 깔끔하게 0과 1 사이로 짜내줍니다. 음수 확률·500% 확률 같은 비상식이 원천 봉쇄돼요.
STEP 3 / 5로지스틱 회귀 = 가중합 + Sigmoid
이제 두 조각을 합칠 시간이에요. 로지스틱 회귀는 사실 두 단계로 이루어진 단순한 파이프라인입니다.
로지스틱 회귀의 두 단계
1단계 — 가중합: z = w₁ × 공부시간 + w₂ × 모의고사 점수 + ··· + b
2단계 — Sigmoid: P(합격 | 입력) = σ(z)
1단계는 그냥 선형 회귀와 같아요. 각 입력에 가중치를 곱해서 다 더합니다. 단, 결과 z는 음수도 될 수 있고 100도 넘을 수 있어요. 확률로 쓰기엔 곤란하죠.
그래서 2단계에서 Sigmoid를 통과시킵니다. z가 어떤 값이든 출력은 0과 1 사이. 이게 바로 "정답일 확률"이에요.
학습이란 결국 가중치 w와 상수 b를 데이터로부터 찾아내는 일입니다. 합격한 사람들의 데이터에서는 σ(z)가 1에 가깝게, 떨어진 사람들의 데이터에서는 0에 가깝게 되도록 w·b를 조금씩 조정해 나가요. 7편에서 다룬 크로스 엔트로피 손실이 바로 이 조정을 위한 도구입니다.
STEP 4 / 5결정 경계 — 0.5는 누가 정한 숫자일까?
모델이 "합격 확률 72%"라고 출력했어요. 그럼 이 사람을 합격으로 볼까요, 불합격으로 볼까요? 보통은 0.5 기준이 답이에요. 0.5 이상이면 합격, 미만이면 불합격.
이 기준선을 임계값(threshold), 그리고 임계값에 의해 갈라지는 경계를 결정 경계(decision boundary)라고 불러요. 0.5가 가장 자연스러운 출발점이지만, 0.5는 절대 신성한 숫자가 아니에요. 문제에 따라 다른 값을 쓸 수 있어요.
임계값을 조정하는 두 가지 시나리오
임계값을 낮춰야 할 때 (예: 0.3) — 암 진단처럼 놓치면(FN) 치명적인 경우. "조금이라도 의심되면 양성으로 분류" → 재현율↑
임계값을 높여야 할 때 (예: 0.7) — 스팸 필터처럼 잘못 잡으면(FP) 사용자가 짜증나는 경우. "확신이 있을 때만 차단" → 정밀도↑
같은 모델, 같은 데이터인데도 임계값 하나로 모델의 성격이 완전히 달라져요. 7편에서 본 정밀도·재현율 이야기가 여기서 직접 작동합니다.
노래로 듣는 로지스틱 회귀
시그모이드의 곡선
STEP 1~4에서 본 가중합·Sigmoid·결정 경계의 개념을 멜로디와 함께 한 번 더 정리해보세요. 4편(베이즈) "로또의 진실 II"에 이은 NumStats 교육 노래 시리즈입니다.
STEP 5 / 5로지스틱 회귀가 매일 우리를 결정짓는 5가지 장면
로지스틱 회귀는 머신러닝의 "Hello, World"이지만, 그 단순함 때문에 오히려 거의 모든 산업에서 여전히 현역으로 쓰이고 있어요. 흥미로운 사례 다섯을 골라봤어요.
① 의료 진단
나이·혈압·콜레스테롤·증상 등 환자 정보를 입력해 "심장병일 확률" "당뇨일 확률"을 계산. 다양한 질병 위험도 예측 모델의 기본 골격이 바로 이 로지스틱 회귀예요. (Framingham 심혈관 위험점수처럼 Cox 비례위험모형을 쓰는 경우도 많지만, "여러 위험 요인을 가중합해 확률을 낸다"는 사고 틀은 동일합니다.)
② 신용 점수와 대출 승인
소득·직업·신용 이력·기존 대출 → "1년 내 연체할 확률". 금융 회사들은 임계값을 정해 그 이하만 대출을 승인합니다. 해석 가능성이 중요한 금융 규제 환경에서 특히 선호돼요.
③ 스팸 필터
메일 단어 빈도·발신자·시간대 → "스팸 확률". 4편에서 본 나이브 베이즈와 함께, 로지스틱 회귀도 스팸 분류의 고전적이고 효과적인 알고리즘으로 오랫동안 활용됐어요.
④ 광고 클릭률 예측 (CTR)
사용자 특성·시간대·광고 종류 → "이 광고를 클릭할 확률". Google·Meta 같은 광고 플랫폼이 한때 로지스틱 회귀로 수십억 건의 광고 노출을 결정했어요. 지금은 딥러닝과 함께 쓰이지만, 기준선 모델로 여전히 작동해요.
⑤ 신경망의 출력층
놀라울 수 있지만, 딥러닝 신경망의 마지막 출력층이 바로 로지스틱 회귀예요. 앞단의 수많은 층이 입력을 변환한 뒤, 최종 단계에서 "가중합 → Sigmoid" 구조로 확률을 출력해요. 이진 분류 신경망이 곧 "고급 로지스틱 회귀"인 셈입니다.
📌 정확성 주석 — 위 응용 사례들은 로지스틱 회귀가 핵심 또는 기준선 모델로 사용된 대표적 영역이에요. 현대 시스템에서는 흔히 트리 앙상블(XGBoost), 딥러닝과 결합되어 사용되지만, "확률을 출력하고 임계값으로 분류한다"는 사고 틀은 로지스틱 회귀에서 출발한 그대로입니다.
직접 가중치를 조절하며 결정 경계를 관찰하세요
넘스탯(NumStats) 로지스틱 회귀 실험실에서는 가중치·임계값을 슬라이더로 조절하며
Sigmoid 곡선이 어떻게 변하고 결정 경계가 어디로 움직이는지 직접 관찰할 수 있습니다.
numlm.com/ml-lab/logistic-regression
한 발 더 들어가고 싶다면
로지스틱 회귀를 이해했다면, 머신러닝의 핵심 골격을 잡은 셈이에요. 이어서 만나볼 만한 주제들:
- 7편 — 머신러닝의 확률 기초: P(정답|입력)이라는 사고 틀, 그리고 정밀도·재현율 이야기
- 다중 분류와 Softmax: Sigmoid가 0과 1 두 클래스를 가른다면, Softmax는 N개 클래스 사이의 확률을 나누어요. 로지스틱 회귀의 직접적 일반화
- 신경망과 활성화 함수: Sigmoid·ReLU·Tanh — 입력을 짜내는 다양한 함수들
- 다음 9편 — ChatGPT 학습 원리: 사전학습부터 RLHF까지, 거대 언어모델은 어떻게 만들어지는지 8단계로 풀어봅니다
참고 자료
본문 작성 시 참고한 머신러닝·통계 표준 교재들입니다.
- David W. Hosmer, Stanley Lemeshow, Rodney X. Sturdivant (2013) — Applied Logistic Regression (3rd ed., Wiley). 로지스틱 회귀의 응용 표준
- Trevor Hastie, Robert Tibshirani, Jerome Friedman (2009) — The Elements of Statistical Learning (2nd ed., Springer). 로지스틱 회귀의 수학적 기반
- Christopher M. Bishop (2006) — Pattern Recognition and Machine Learning (Springer). 확률론적 관점의 분류 모델
- Andrew Ng — Coursera Machine Learning. Sigmoid와 결정 경계의 가장 친절한 강의
- Pierre-François Verhulst (1838) — Notice sur la loi que la population suit dans son accroissement. 로지스틱 함수의 원전
- NumStats 로지스틱 회귀 실험실 — numlm.com/ml-lab/logistic-regression
마무리
오늘 본 내용을 한 줄로 요약하면 이거예요. "입력들을 적당히 더해서, 그 결과를 0~1 사이로 짜내면 확률이 된다."
로지스틱 회귀는 머신러닝의 출발점이자, 동시에 가장 멀리까지 가는 도구예요. 의료·금융·광고·신경망 — 어디를 가도 마지막에는 Sigmoid가 입력을 확률로 짜내고 있어요. 이 한 가지 사고 틀을 머릿속에 박아두면, 앞으로 만날 어떤 분류 모델도 "아, 이것도 결국 가중합 + Sigmoid구나"라는 식으로 정리됩니다.
다음 9편에서는 이 단순한 도구가 거대하게 쌓이고 변형되어 ChatGPT 같은 대규모 언어모델이 되는 8단계 과정을 풀어보겠습니다.
그 뒤에는 누군가 가중합을 만들고, Sigmoid가 짜내고 있다는 사실을.
넘스탯(NumStats)에서 다음 글로 만나요.
넘스탯(NumStats) — 확률부터 LLM까지, 원리부터 제대로 배우는 자기주도 학습 플랫폼
#NumStats #넘스탯 #로지스틱회귀 #LogisticRegression #Sigmoid #시그모이드 #이진분류 #결정경계 #머신러닝입문 #확률모델
※ 이 글은 LLM 도구를 활용해 초안을 작성한 뒤, 학술 출처와 수치 정확성은 발행 전 직접 검증·편집했습니다. 본문에 사실과 다른 부분을 발견하시면 댓글로 알려주시면 즉시 반영하겠습니다.