머신러닝의 확률 기초 | 넘스탯(NumStats) — ML 면접에서 자주 묻는 통계 질문
"모델이 고양이일 확률 92%라고 할 때, 그 92%는 정확히 뭔가요?" — 머신러닝 면접에 거의 항상 등장하는 확률·통계 질문 5가지를 일상 비유로 풀어봅니다. 수식보다 직관이 먼저예요.
면접실. 화이트보드 앞에 앉은 지원자에게 면접관이 노트북을 돌려 보여줍니다. 이미지 분류 모델이 고양이 사진을 보고 "고양이 92%"라고 출력하고 있어요. 면접관이 묻습니다.
모델은 대체 무엇을 '학습'한 걸까요?"
많은 지원자가 여기서 잠깐 멈칫합니다. 코드는 짤 줄 알지만, 그 밑에 깔린 확률의 언어로 설명하라고 하면 막막해지거든요. 그런데 면접관이 진짜 보고 싶은 건 화려한 모델 이름이 아니라 바로 이 기초예요.
머신러닝은 본질적으로 불확실한 세상에서 확률로 판단을 내리는 기술입니다. 그래서 ML·데이터 사이언스 면접에는 확률·통계 질문이 단골로 나와요. 오늘은 그중 가장 자주 등장하는 다섯 가지 질문을 골라, 외운 답이 아니라 직관으로 설명할 수 있게 풀어봅니다.
이 글이 답하는 면접 단골 질문 5가지
① 모델은 결국 무엇을 학습하나요?
② 정확도 99% 모델, 믿어도 되나요?
③ 손실 함수에 왜 하필 log가 들어가나요?
④ 나이브 베이즈는 왜 '순진(naive)'한가요?
⑤ 과적합을 통계로 설명해보세요.
Q 1 / 5모델은 결국 무엇을 학습하나요? — P(정답 | 입력)
가장 근본적인 질문이자, 의외로 많은 사람이 한 문장으로 답하지 못하는 질문이에요. 답은 놀랍도록 간단합니다. 대부분의 분류 모델이 학습하는 것은 "입력이 주어졌을 때 정답일 확률", 즉 조건부 확률이에요.
고양이 분류기는 이미지 x를 받아 "이 이미지가 주어졌을 때 고양이일 확률" P(고양이 | 이미지)를 계산해요. 92%라는 출력은 바로 이 조건부 확률값이죠. 조건부 확률이 뭐였는지 가물가물하다면 6편(조건부 확률 예제)을 먼저 보고 오시면 이 글 전체가 훨씬 선명하게 읽혀요.
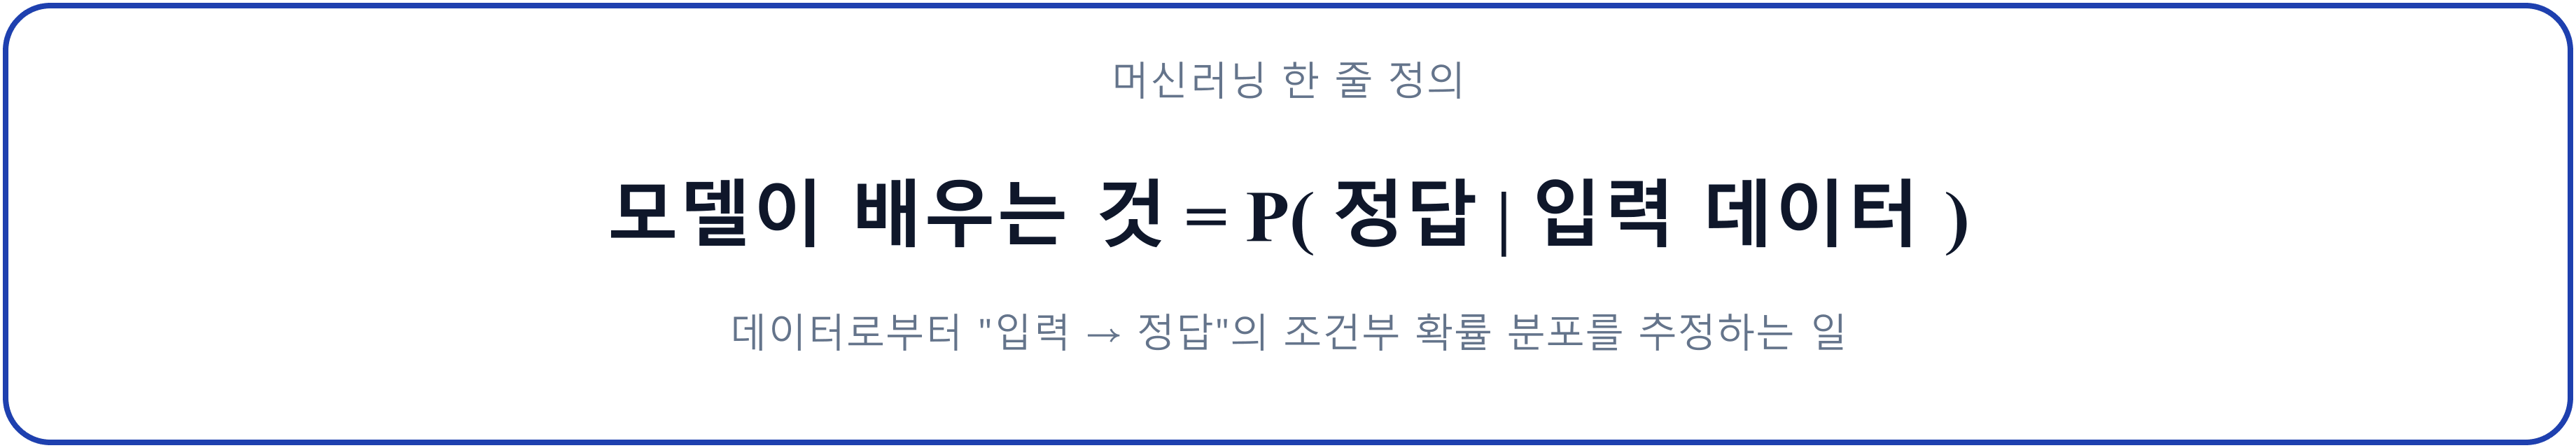
그래서 "학습(training)"이란 결국 수많은 예시 데이터를 보면서 이 조건부 확률을 점점 더 정확하게 맞춰가는 과정이에요. 강아지·고양이 사진 수만 장을 보여주면, 모델은 "이런 픽셀 패턴이면 고양이일 확률이 높다"는 규칙을 스스로 조정해 나갑니다.
📌 정확성 주석 — "P(y|x)를 직접 추정한다"는 설명은 로지스틱 회귀·소프트맥스 분류처럼 판별 모델(discriminative model)에 들어맞아요. 회귀 모델은 보통 조건부 기댓값 E[y|x]를 추정하고, 나이브 베이즈 같은 생성 모델(generative model)은 P(x|y)와 P(y)를 거쳐 베이즈 정리로 P(y|x)를 구합니다. 큰 그림에서 "조건부 확률을 다룬다"는 본질은 모두 같아요.
Q 2 / 5정확도 99% 모델, 믿어도 되나요? — 정밀도와 재현율
면접에서 함정 카드로 자주 나오는 질문이에요. "암을 진단하는 모델을 만들었는데 정확도(accuracy)가 99%입니다. 좋은 모델인가요?"
정답은 "그것만으로는 전혀 알 수 없다"예요. 환자가 1,000명 중 10명뿐인 희귀 암이라면, 모든 사람을 무조건 "정상"이라고 찍는 멍청한 모델도 정확도가 990/1000 = 99%가 나오거든요. 정작 진짜 환자 10명은 전부 놓치는데도요.
어디서 본 함정 같지 않나요? 맞아요, 6편의 병원 검사 이야기와 정확히 같은 구조예요. 드문 사건에서는 "전체 정답률"이라는 숫자가 거짓말을 합니다. 그래서 머신러닝에서는 정확도 대신 정밀도(Precision)와 재현율(Recall)을 함께 봐요. 이 둘을 한눈에 정리한 표가 혼동 행렬(Confusion Matrix)입니다.
두 지표가 답하는 질문은 방향이 정반대예요. 6편에서 본 "조건의 방향" 이야기가 여기서 그대로 반복됩니다.
- 정밀도 = "스팸이라고 예측한 것 중 진짜 스팸의 비율" → P(진짜 스팸 | 스팸이라 예측). 6편 병원 검사의 P(환자 | 양성)과 같은 방향이에요.
- 재현율 = "진짜 스팸 중 모델이 잡아낸 비율" → P(스팸이라 예측 | 진짜 스팸). 6편의 민감도와 같은 방향이고요.
재현율이 중요한 경우: 암 진단·금융 사기 탐지처럼 놓치면(FN) 치명적인 문제. 정상을 몇 번 의심하더라도 진짜를 빠짐없이 잡아야 해요.
정밀도가 중요한 경우: 스팸 필터·추천처럼 잘못 잡으면(FP) 사용자가 짜증나는 문제. 중요한 메일이 스팸함에 갇히면 안 되니까요.
둘은 보통 한쪽을 올리면 다른 쪽이 내려가는 트레이드오프 관계라, 둘을 조화 평균으로 묶은 F1 점수를 함께 보고합니다. "정확도 말고 무엇을 보겠냐"는 면접 질문의 모범 답안이 바로 이거예요.
Q 3 / 5손실 함수에 왜 하필 log가 들어가나요? — 최대우도추정
분류 모델을 학습할 때 거의 항상 등장하는 손실 함수가 크로스 엔트로피(Cross-Entropy)예요. 식을 보면 늘 log가 붙어 있죠. 면접관이 "왜 하필 로그냐"고 물으면, 여기엔 통계학의 아주 우아한 이유가 있어요. 바로 최대우도추정(MLE, Maximum Likelihood Estimation)입니다.
아이디어는 단순해요. "우리가 실제로 관찰한 데이터가 나올 가능성(우도)을 가장 크게 만드는 모델이 가장 좋은 모델이다." 모델이 정답에 부여한 확률이 높을수록 좋은 거예요. 그런데 확률들을 전부 곱하면(데이터가 많으면 0.0001 × 0.002 × …) 숫자가 0에 가깝게 사라져 계산이 불안정해져요. 그래서 로그를 씌워 곱셈을 덧셈으로 바꿉니다. log는 단조 증가 함수라, 로그를 씌워도 "가장 큰 값"의 위치는 변하지 않거든요.
모델이 정답에 부여한 확률이 1에 가까우면 → log(1) = 0 → 벌점 거의 없음.
모델이 정답에 부여한 확률이 0에 가까우면 → log(0.01)처럼 큰 음수 → 벌점 폭증.
즉 "자신 있게 틀린" 예측에 가장 큰 벌을 줘요. 크로스 엔트로피를 최소화하는 것은 곧 우도를 최대화하는 것 — 손실 함수와 MLE는 동전의 양면입니다.
그래서 "왜 로그냐"의 정답은 이거예요. "확률의 곱을 합으로 바꿔 수치적으로 안정시키고, 동시에 최대우도추정이라는 통계 원리를 그대로 손실 함수로 옮기기 위해서." 한 문장으로 답하면 면접관이 고개를 끄덕입니다.
Q 4 / 5나이브 베이즈는 왜 '순진(naive)'한가요? — 조건부 독립 가정
스팸 필터의 고전, 나이브 베이즈(Naive Bayes). 이름에 대놓고 "순진하다(naive)"가 붙어 있어요. 면접관이 "뭐가 그렇게 순진하냐"고 물으면 답할 수 있어야 합니다.
나이브 베이즈는 4편에서 다룬 베이즈 정리로 P(스팸 | 메일)을 계산해요. 그런데 메일에는 단어가 수백 개라, "이 단어 조합이 통째로 스팸에서 나타날 확률"을 직접 구하긴 사실상 불가능합니다. 그래서 과감한 가정을 하나 둬요.
— 즉, '무료'가 나오든 말든 '당첨'이 나올 확률은 영향받지 않는다고 가정
현실에선 명백히 틀린 가정이에요. '무료'와 '당첨'과 '클릭'은 스팸에서 함께 몰려다니니까요. 단어 사이의 관계를 깡그리 무시한다는 점에서 '순진하다(naive)'고 부르는 거예요. 정확히는 "클래스가 주어졌을 때 특징들이 서로 조건부 독립"이라고 가정합니다 — 6편의 조건부 확률, 그리고 "조건부 독립" 개념이 여기서 직접 쓰여요.
놀랍게도 나이브 베이즈는 스팸 필터·문서 분류에서 지금도 훌륭하게 작동해요. 확률값 자체는 부정확해도, 우리가 필요한 건 "스팸일 확률이 정상일 확률보다 큰가?"라는 순서뿐이거든요. 가정이 거칠어도 순위만 맞으면 분류는 성공합니다. "모든 모델은 틀렸지만, 일부는 유용하다"는 통계학의 격언(조지 박스)을 가장 잘 보여주는 사례예요.
Q 5 / 5과적합을 통계로 설명해보세요 — 편향-분산 트레이드오프
마지막 단골 질문. "과적합(overfitting)이 뭐고, 왜 생기나요?"를 통계 언어로 답하는 거예요. 핵심 개념은 편향-분산 트레이드오프(Bias-Variance Tradeoff)입니다.
모델의 예측 오차는 크게 세 조각으로 나뉘어요. 편향(bias)은 모델이 너무 단순해서 생기는 체계적 오차이고, 분산(variance)은 모델이 너무 복잡해서 학습 데이터의 잡음까지 외워버려 생기는 흔들림이에요. 그리고 어쩔 수 없는 잡음(irreducible error)이 남고요.
그래프를 보면 한눈에 들어와요. 모델이 너무 단순한 왼쪽에서는 편향이 커서 학습 데이터조차 제대로 못 맞히는 과소적합(underfitting)이 일어나요. 모델이 너무 복잡한 오른쪽에서는 분산이 커져, 학습 데이터는 완벽히 외우지만 새 데이터엔 폭삭 무너지는 과대적합(overfitting)이 일어나고요.
그래서 면접 모범 답안은 이렇게 됩니다. "과적합은 모델이 데이터의 신호가 아니라 잡음까지 학습해 분산이 커진 상태예요. 편향과 분산은 트레이드오프 관계라, 둘의 합인 총 오차가 최소가 되는 적절한 복잡도를 찾는 게 핵심이고, 정규화·교차 검증·더 많은 데이터가 그 도구입니다."
📌 정확성 주석 — 위 분해(총 오차 = 편향² + 분산 + 잡음)는 회귀의 제곱 오차에서 엄밀하게 유도돼요(Hastie 외, ESL). 그래프의 곡선은 개념을 보여주기 위한 도식이며, 실제 곡선 모양은 모델·데이터에 따라 달라집니다. 또한 딥러닝의 "이중 강하(double descent)"처럼 이 고전적 U자 곡선이 그대로 들어맞지 않는 현대적 현상도 보고되고 있어요.
노래로 듣는 머신러닝 검증
검증의 블루스
정확도·정밀도·재현율·MLE·편향-분산 — 오늘 본 다섯 질문을 멜로디와 함께 한 번 더 정리해보세요. 4편(베이즈) "로또의 진실 II", 8편(로지스틱) "시그모이드의 곡선"에 이은 NumStats 교육 노래 시리즈입니다.
면접 5문 한눈에 정리
다섯 질문의 핵심을 카드로 묶었어요. 면접 직전 이 다섯 장만 떠올려도 절반은 성공입니다.
① 모델이 배우는 것
입력이 주어졌을 때 정답일 확률 P(정답|입력)을 데이터로 추정하는 일.
② 정확도의 함정
불균형 데이터에선 정확도가 거짓말. 정밀도·재현율·F1로 방향을 나눠 본다.
③ log가 들어가는 이유
곱을 합으로 바꿔 안정화 + 최대우도추정을 손실 함수로 옮긴 것.
④ 나이브 베이즈
"특징들이 조건부 독립"이라는 순진한 가정. 틀려도 순위만 맞으면 작동.
⑤ 과적합
잡음까지 학습해 분산↑. 편향-분산 합이 최소인 복잡도를 찾는 문제.
머신러닝 이론을 직접 따라가며 익히기
넘스탯(NumStats) 머신러닝 이론 페이지에서는 오늘 본 확률 기초부터
지도학습·비지도학습·모델 평가까지, 개념을 단계별 도식과 인터랙티브 실습으로 따라갈 수 있어요.
numlm.com/theory_machine_learning
한 발 더 들어가고 싶다면
오늘 다룬 다섯 질문은 모두 앞선 글들의 기초 위에 서 있어요. 막혔던 부분이 있다면 이어서 읽어보세요:
- 6편 — 조건부 확률 예제: 모든 분류 모델의 출발점인 P(정답|입력), 그리고 정밀도·재현율의 뿌리
- 4편 — 베이즈 정리: 나이브 베이즈와 확률적 추론의 기둥
- 2편 — 정규분포: 수많은 모델이 깔고 가는 "가우시안 가정"의 정체
- 다음 8편 — 로지스틱 회귀: P(정답|입력)을 실제로 어떻게 계산하는지, Sigmoid 함수로 파헤칩니다
참고 자료
본문 작성 시 참고한 머신러닝 표준 교재들입니다. 더 깊이 들어가고 싶은 분들께 추천드려요.
- Christopher M. Bishop (2006) — Pattern Recognition and Machine Learning (Springer). 확률론적 관점에서 ML을 다루는 표준 교재
- Ian Goodfellow, Yoshua Bengio, Aaron Courville (2016) — Deep Learning (MIT Press). 최대우도추정·크로스 엔트로피 손실의 표준 설명
- Trevor Hastie, Robert Tibshirani, Jerome Friedman (2009) — The Elements of Statistical Learning (2nd ed., Springer). 편향-분산 분해의 정석
- Kevin P. Murphy (2012) — Machine Learning: A Probabilistic Perspective (MIT Press)
- Tom M. Mitchell (1997) — Machine Learning (McGraw-Hill). 나이브 베이즈 등 고전 알고리즘의 표준 정리
- NumStats 머신러닝 이론 페이지 — numlm.com/theory_machine_learning
마무리
오늘 우리는 면접관의 다섯 질문을 따라가며, 머신러닝이라는 기술의 밑바닥에 흐르는 확률의 언어를 들여다봤어요. 모델이 배우는 건 조건부 확률이고, 평가 지표도, 손실 함수도, 알고리즘의 가정도, 과적합조차도 — 전부 확률·통계의 얼굴을 하고 있었죠.
핵심은 한 문장이에요. "머신러닝은 불확실한 세상에서 데이터로 확률을 추정하고, 그 확률로 판단을 내리는 기술이다."
이 관점을 한번 장착하고 나면, 새로운 모델이나 논문을 만나도 "이건 어떤 확률을, 어떤 가정 아래에서 추정하는 걸까?"라는 질문 하나로 핵심을 꿰뚫어 볼 수 있어요. 화려한 모델 이름에 휘둘리지 않는, 단단한 기초가 생기는 거죠.
막혔던 머신러닝 개념이 있다면 댓글로 들려주세요. 다음 글 주제로 풀어볼게요.
넘스탯(NumStats)에서 다음 글(로지스틱 회귀)로 만나요.