마르코프 체인 입문 | 넘스탯(NumStats) — 구글 페이지랭크의 핵심 알고리즘
오늘 날씨로 내일을 예측하고, 구글이 가장 중요한 페이지를 찾고, 스마트폰 자동완성이 다음 단어를 추천합니다. 전혀 달라 보이는 이 세 가지가 사실은 같은 수학 — 마르코프 체인(Markov Chain)으로 작동해요.
오늘 아침 창밖을 보니 비가 옵니다. 내일은 어떨까요? 어쩌면 우리는 무의식 중에 "어제 비왔으니까 오늘도 흐릴 거 같아" 같은 식으로 생각해요. 어제 일을 보고 오늘을 짐작하는 거죠.
그런데 신기한 게 있어요. 이런 "바로 직전 상태만 보고 다음을 예측하는 방식"이 단순한 직관이 아니라, 수학적으로 정식화된 도구라는 사실. 그게 오늘 이야기할 마르코프 체인입니다.
현재 상태에만 의존한다.
이 한 문장이 마르코프 체인의 전부예요. 단순해 보이지만 이 가정 위에서 구글 검색 순위·스마트폰 자동완성·날씨 예보·DNA 분석·금융 신용평가까지 작동합니다. 하나씩 풀어볼게요.
마르코프 체인이란? — 날씨로 시작하는 가장 친근한 예시
예를 들어 우리 동네에 세 가지 날씨가 있다고 해봅시다. 맑음·흐림·비. 지난 몇 년간 관측한 결과 이런 패턴이 보였다고 가정해볼게요.
- 오늘 맑으면 → 내일도 맑을 확률 70%, 흐릴 확률 20%, 비 올 확률 10%
- 오늘 흐리면 → 내일 맑을 확률 30%, 흐릴 확률 40%, 비 올 확률 30%
- 오늘 비 오면 → 내일 맑을 확률 20%, 흐릴 확률 40%, 비 올 확률 40%
이걸 그림으로 그려보면 이렇게 생겼어요.
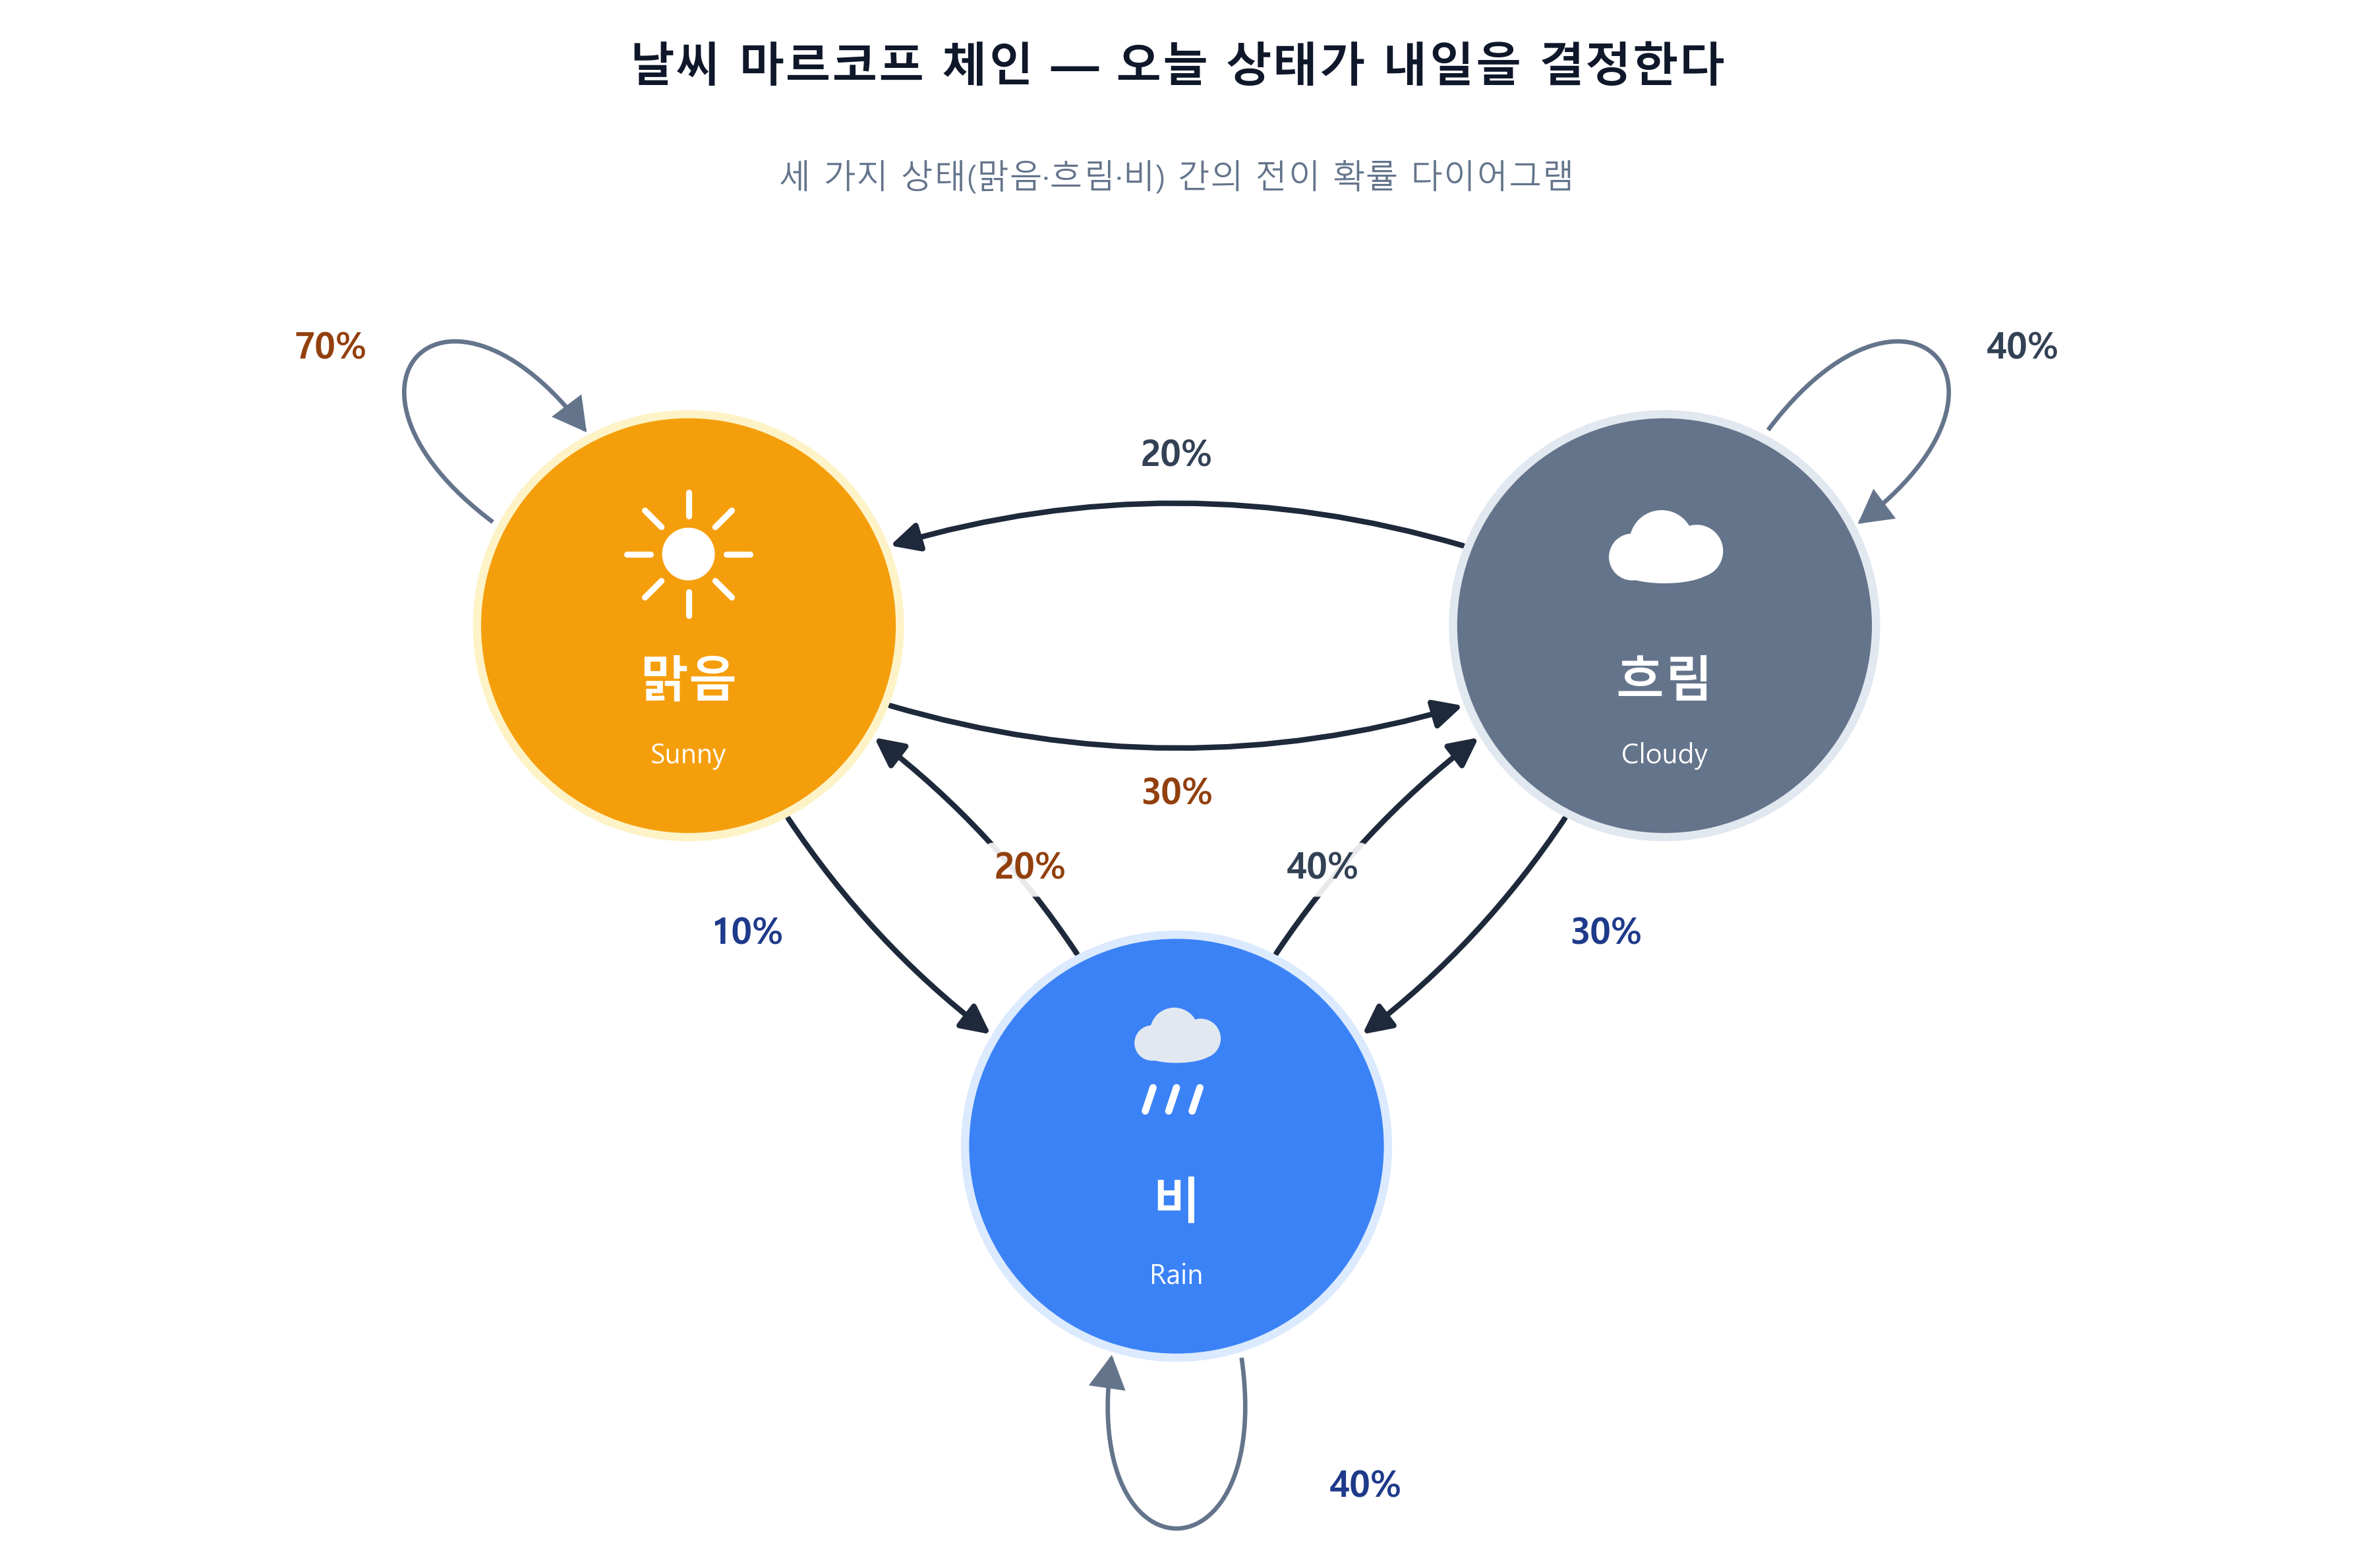
위 그림에서 보이는 동그라미(노드)는 상태이고, 화살표는 전이 확률이에요. 핵심 규칙은 단 하나:
다음 상태의 확률은 오직 현재 상태에만 의존한다. 그 전에 무슨 일이 있었는지는 잊어버려도 된다.
이 가정이 사실 굉장히 대담해요. "어제 며칠 연속 비가 왔든, 한 달 전 어땠든 상관없이, 오늘 비라는 사실 하나만으로 내일을 예측한다"는 거니까요. 현실의 많은 시스템이 이 가정으로 단순화해도 충분히 잘 맞아요. 단순함이 마르코프 체인의 가장 큰 무기입니다.
위 그림은 표로도 정리할 수 있어요. 이걸 전이 행렬(Transition Matrix)이라고 합니다.
| 오늘 \ 내일 | 맑음 | 흐림 | 비 |
|---|---|---|---|
| 맑음 | 0.70 | 0.20 | 0.10 |
| 흐림 | 0.30 | 0.40 | 0.30 |
| 비 | 0.20 | 0.40 | 0.40 |
이 표 하나만 있으면 컴퓨터가 "100일 후엔 평균적으로 며칠이 맑을지"까지 계산해줍니다. 그게 마르코프 체인의 진짜 매력이에요.
구글은 이걸로 검색 순위를 정했다 — 페이지랭크의 비밀
1996년, 스탠퍼드 대학교 박사과정 두 학생이 있었어요. 세르게이 브린(Sergey Brin)과 래리 페이지(Lawrence "Larry" Page). 그들은 인터넷의 수많은 웹페이지 중 어떤 게 "가장 중요한지" 자동으로 판단하는 방법을 찾고 있었습니다.
그들의 아이디어는 충격적으로 단순했어요. 웹페이지를 노드로, 페이지 간의 링크를 화살표로 보자. 그러면 인터넷 전체가 거대한 마르코프 체인이 됩니다.
한 사람이 인터넷을 무작위로 돌아다닌다고 상상해보세요. 페이지를 열고, 링크 하나를 무작위로 클릭하고, 또 클릭하고… 이렇게 무한히 반복하면 그 사람이 각 페이지에 머물러 있을 비율이 자연스럽게 정해져요. 많은 링크를 받는 페이지일수록 자주 방문하게 되겠죠. 그 비율이 바로 페이지랭크(PageRank)입니다.
다시 말해 페이지랭크는 웹이라는 거대한 마르코프 체인의 정상 분포(Stationary Distribution)예요. 정상 분포란 "충분히 오랜 시간이 지나면 도달하는 안정적인 확률 분포"를 말해요. 이게 1998년 두 사람이 발표한 논문 "The Anatomy of a Large-Scale Hypertextual Web Search Engine"의 핵심이고, 같은 해 9월에 Google이 정식 회사로 설립되었습니다.
오늘날 구글은 페이지랭크 외에 수백 가지 신호를 함께 쓰며, 페이지랭크 점수 자체는 2016년부터 외부에 공개되지 않습니다. 그러나 "여러 곳에서 링크받는 페이지가 더 중요하다"는 마르코프 체인 기반의 아이디어는 여전히 현대 검색 알고리즘의 출발점 중 하나입니다.
마르코프 체인은 멀리 있지 않다 — 매일 마주치는 사례들
구글 검색만이 아니에요. 우리가 매일 쓰는 서비스의 뒤편 곳곳에 마르코프 체인이 숨어 있어요.
1. 스마트폰 자동완성과 예측 키보드
"안녕하세요" 다음에 무슨 단어가 올 가능성이 높을까요? 키보드 앱은 방대한 텍스트 코퍼스에서 단어와 단어 사이의 전이 확률을 학습해 둡니다. "안녕" 다음에는 "하세요"가 가장 확률이 높고, "하세요" 다음엔 "."이나 "!"가 자주 나오죠. 이 모든 게 단어를 상태로 보는 마르코프 체인이에요.
n-gram 언어모델 — 트랜스포머·GPT 이전 NLP의 표준이었음
2. 넷플릭스·유튜브의 다음 영상 추천
"이 영상 시청 후 다음에 본 영상" 데이터를 모으면 영상 간 전이 행렬이 만들어져요. 액션 영화를 본 사람이 다음에 어떤 장르를 클릭하는지 패턴이 잡히면, 그걸로 자동재생 큐를 결정합니다. 현대 추천 시스템은 협업 필터링·딥러닝 등이 결합된 복합 모델이지만, 사용자의 다음 행동을 시퀀스로 모델링한다는 핵심 아이디어는 마르코프 체인에서 출발했어요.
시퀀스 기반 추천(Sequential Recommendation) — 마르코프 체인의 응용
3. 음성 인식 (Hidden Markov Model)
Siri나 Google Assistant가 우리 목소리를 글자로 바꾸는 일에도 마르코프 체인의 확장판인 은닉 마르코프 모델(HMM)이 핵심으로 쓰였어요. 음성 신호의 작은 조각들이 어떤 음소(ㄱ·ㄴ·ㅏ 같은 소리 단위)에서 다음 음소로 전이되는지를 확률로 모델링합니다. 2010년대 딥러닝이 도입되기 전까지 30년 동안 음성 인식의 표준이었습니다.
1980~2010년대 음성 인식의 표준 알고리즘
4. 보드게임의 수학적 분석
"뱀과 사다리(Snakes and Ladders)"나 모노폴리 같은 보드게임은 완벽한 마르코프 체인이에요. 다음 칸은 오직 현재 칸과 주사위 결과에 의존하니까요. 수학자들은 이 도구로 "모노폴리에서 가장 자주 멈추는 칸은 어디인가"까지 계산해냈습니다. 분석 결과 감옥(Jail)과 Illinois Avenue 같은 칸들이 가장 자주 방문되는 곳으로 자주 꼽힙니다(정확한 순위는 감옥 머무름 같은 세부 룰 가정에 따라 달라집니다).
Truman Collins(1997) 분석 — 마르코프 체인의 고전적 응용
5. 금융의 신용등급 변화
S&P·Moody's 같은 신용평가사는 "AAA 등급 회사가 1년 후에 어떤 등급으로 변할지"를 등급 전이 행렬로 매년 발표해요. 은행은 이걸 마르코프 체인으로 해석해 채권 포트폴리오의 미래 리스크를 추정합니다. 수십 년의 등급 변동 데이터에서 만들어진 이 행렬은 신용 리스크 모델링의 기본 도구입니다.
신용 리스크 분석 — 마르코프 체인의 금융 응용
참고로 — 마르코프는 시인의 글에서 출발했다
마르코프 체인을 만든 사람은 러시아 수학자 안드레이 마르코프(Andrey Markov, 1856-1922)예요. 그가 이 이론을 처음 적용한 곳이 어디였을 것 같으세요? 놀랍게도 러시아의 국민 시인 알렉산드르 푸시킨의 소설 "예브게니 오네긴"이었어요.
마르코프 체인의 수학적 기초는 1906년에 발표되었고, 1910년대 초반에는 푸시킨 소설의 처음 약 2만 글자를 일일이 분석해 모음과 자음의 전이 패턴을 살핀 논문을 내놓았어요(흔히 1913년으로 인용됩니다). "모음 다음에 자음이 올 확률"과 "자음 다음에 모음이 올 확률"을 계산해, 글자들이 단순한 독립이 아니라 "바로 앞 글자에 의존하는 패턴"이 있다는 걸 보였습니다. 통계적 언어 분석의 출발점이었어요.
한 사람의 시 한 편이 100년 후 구글 검색·자동완성·음성 인식까지 만들어내는 이야기 — 수학의 가장 매력적인 모습 중 하나가 이런 부분이에요.
읽기만 해서는 와닿지 않는 부분
지금까지 본 이야기 — 전이 행렬·정상 분포·페이지랭크 — 는 글로 따라가면 어쩐지 추상적이에요. 하지만 직접 노드와 화살표를 그려보고, 확률을 바꿔보고, 컴퓨터가 100번 시뮬레이션한 결과를 눈으로 보면 단번에 와닿습니다.
예를 들어 위 날씨 예시에서 처음에 비가 왔다고 가정하고 100일 시뮬레이션을 돌려보면, 시간이 지날수록 "맑음·흐림·비" 비율이 특정 값으로 수렴해요. 그게 정상 분포이고, 그게 페이지랭크의 본질입니다.
넘스탯(NumStats) 마르코프 체인 학습 페이지에서는 상태와 전이 확률을 직접 조절하며
시간이 지남에 따라 분포가 어떻게 수렴하는지 인터랙티브 시각화로 확인할 수 있습니다. 무료입니다.
한 발 더 들어가고 싶다면
마르코프 체인을 마스터했다면, 이어서 만나볼 만한 주제들이 있어요:
- 은닉 마르코프 모델(HMM): 음성 인식·생물정보학의 표준 도구
- 몬테카를로 마르코프 체인(MCMC): 베이지안 통계의 핵심 샘플링 방법
- 강화학습: 마르코프 결정 과정(MDP) 위에서 작동하는 AI 학습 방법
- 페이지랭크의 수학: 정상 분포와 행렬의 고유벡터 계산
이 모든 주제를 넘스탯(NumStats)에서 차근차근 실습해볼 수 있어요. 한 번 마르코프의 사고 틀이 익숙해지면, 시간에 따라 변하는 거의 모든 현상이 다르게 보이기 시작합니다.
참고 자료
본문 작성 시 참고한 주요 학술 자료와 출처입니다. 더 깊이 들어가고 싶은 분들께 추천드려요.
- Brian Hayes — "First Links in the Markov Chain" (American Scientist, 2013). 마르코프의 푸시킨 텍스트 분석을 영어로 가장 친절히 정리한 칼럼 — Google에서 제목으로 검색하면 바로 나옵니다
- A. A. Markov (1913) — 푸시킨 "예브게니 오네긴" 텍스트 분석 원논문. 영어 번역본 공개
- Sergey Brin and Lawrence Page (1998) — "The Anatomy of a Large-Scale Hypertextual Web Search Engine". WWW7 conference(1998년 4월, 호주 브리즈번) 발표 + Computer Networks and ISDN Systems에 동시 게재. 구글의 출생 신고서 같은 논문. Stanford InfoLab·Google Scholar에서 PDF 무료 공개
- Truman Collins (1997) — "Probabilities in the Game of Monopoly". tkcs-collins.com 개인 사이트에서 원문 공개. 모노폴리 마르코프 체인 분석의 고전
- L. R. Rabiner (1989) — "A tutorial on hidden Markov models and selected applications in speech recognition" (Proceedings of the IEEE). HMM 학습의 가장 유명한 튜토리얼
- Sheldon Ross — Introduction to Probability Models. 마르코프 체인 챕터 (학부 표준 교재)
- J. R. Norris — Markov Chains (Cambridge University Press). 좀 더 깊이 있는 책
- 김우철 — 통계학 개론. 한국 통계학 표준 입문서
마무리
오늘 본 이야기를 한 줄로 요약하면 이거예요. "미래는 과거 전체가 아니라 현재 상태에만 의존한다."
이 단순한 가정 하나가 한 세기가 넘는 시간 동안 구글 검색·음성 인식·자동완성·금융 리스크 분석을 만들어냈어요. 푸시킨의 운문 소설 한 편에서 시작된 수학이 지금도 우리가 매일 쓰는 서비스의 뒤편에서 묵묵히 일하고 있는 셈이죠.
다음에 구글 검색창에 무언가를 입력하거나, 스마트폰이 다음 단어를 추천해줄 때, 한 번쯤 떠올려 보세요. "아, 이게 마르코프가 100년 전에 생각한 그 아이디어구나." 그 순간 당신은 이미 수학을 일상에서 발견하는 사람이 된 거예요.
"오늘 비가 오면 내일도 비올 확률이 높다"가 맞는 동네인지, 댓글로 알려주세요.
넘스탯(NumStats)에서 다음 글로 만나요.